
TiDB + pandas 实战:DataFrame 十大常用函数
环境说明:本文所有代码基于 Python 3.12 编写运行
数据库为 TiDB Cloud Serverless(版本 8.0.11-TiDB-v8.5.3)
pandas 连接走
mysql+pymysql+ SQLAlchemy。
1. 开篇引言
从 TiDB 读出一张表之后,90% 的新手会卡在同一句话:"接下来该用哪个函数?"
head、describe、groupby、sort_values……pandas 函数上百个,教程翻一篇忘一篇。
其实日常数据分析,真正高频的就那么十来个函数,记住它们就够应付 80% 的活儿。
这篇一次讲透:
- ✅ 看数据的"三板斧":
head/info/describe - ✅ 找数据的"三件套":筛选 /
sort_values/value_counts - ✅ 算数据的"核心武器":
groupby+ 聚合 - ✅ 全文沿用系列统一的
orders订单表,无缝衔接
学完这篇,拿到任何一张表你都知道先干嘛、再干嘛,咱们发车!
2. 知识点通俗讲解
2.1 DataFrame 是什么?再啰嗦一遍
DataFrame 就是 pandas 在内存里开的一张"Excel 表":有行有列,每列有名字。
我们从 TiDB 读出的数据、做的所有分析,都是在操作这张内存表。
2.2 为什么要先学"常用函数"?
打个比方:DataFrame 是一辆新车,常用函数就是方向盘、油门、刹车。
你不需要先搞懂发动机的200个零件(全部函数),先会开(10个高频函数),路上遇到情况再查说明书(官方文档)。
2.3 什么时候用哪个?看真实工作流
实际开发里的分析流程是固定的:接到需求 → 读表 → 先看数据长啥样 → 挑出要的部分 → 算指标 → 出结论。
比如领导问"哪个城市销售额最高",你的动作就是:head 扫一眼 → groupby 按城市求和 → sort_values 降序。三个函数搞定,这就是本篇要练的肌肉记忆。
2.4 函数按"用途"分四类,好记!
| 类别 | 干什么 | 代表函数 |
|---|---|---|
| 看 | 快速浏览数据长啥样 | head、info、describe |
| 找 | 挑数据、排顺序、数个数 | 条件筛选、sort_values、value_counts |
| 算 | 分组统计、批量加工 | groupby、apply |
| 修 | 处理脏数据 | fillna、drop_duplicates、astype |
记住这个分类,用到时自然知道该翻哪一类。
3. 核心语法/规则详解
3.1 "看"数据三板斧 ⭐ 拿到表第一件事
df.head()       # 看前5行(默认5,可写 df.head(10))
df.info()       # 看每列的类型、有没有空值
df.describe()   # 数值列的统计:个数、均值、最大最小值
重点:info() 里的 non-null 数量如果比总行数少,说明这一列有空值,后面要处理。
3.2 "找"数据三件套
df[df["amount"] > 1000]                    # 条件筛选:只要金额大于1000的行
df.sort_values("amount", ascending=False)  # 按金额从高到低排
df["city"].value_counts()                  # 数每个城市有几单
易错点:sort_values 默认是升序,想从大到小必须加 ascending=False。
3.3 "算"数据核心:groupby 分组聚合
df.groupby("city")["amount"].sum()   # 按城市分组,对金额求和
df.groupby("city")["amount"].mean()  # 换成求平均值
一句话理解:groupby 就是"先按某列归类,再对每类算一笔账"——和 SQL 里的 GROUP BY 一模一样。
3.4 "修"数据三兄弟(拓展选学)
df["amount"].fillna(0)          # 空值填0
df.drop_duplicates()            # 去重(删掉完全重复的行)
df["amount"].astype(int)        # 把金额列转成整数
4. 完整实战代码案例
import pandas as pd
from sqlalchemy import create_engine
# ========== 连接 TiDB Serverless(替换成你自己的连接信息) ==========
engine = create_engine(
"mysql+pymysql://你的用户名:你的密码@你的主机:4000/test"
"?ssl_verify_cert=true&ssl_verify_identity=true"
)
# ========== 第一步:读表 ==========
df = pd.read_sql("SELECT * FROM orders", engine)
# ========== 第二步:"看"数据三板斧 ==========
print("===== 前5行 =====")
print(df.head())
print("\n===== 表结构 =====")
df.info()
print("\n===== 数值统计 =====")
print(df.describe())
# ========== 第三步:"找"数据三件套 ==========
print("\n===== 金额大于1000的大单 =====")
big = df[df["amount"] > 1000]
print(big[["customer_id", "city", "amount"]])
print("\n===== 按金额从高到低排 =====")
print(df.sort_values("amount", ascending=False)[["customer_id", "amount"]].head(3))
print("\n===== 各城市订单数 =====")
print(df["city"].value_counts())
# ========== 第四步:"算"数据:分组统计 ==========
print("\n===== 各城市销售额 =====")
print(df.groupby("city")["amount"].sum().sort_values(ascending=False))
print("\n===== 各城市平均客单价 =====")
print(df.groupby("city")["amount"].mean().round(2))
# ========== 第五步(拓展):一次算多种账 ==========
print("\n===== 各城市:总销售额 + 最大单笔 + 单数 =====")
result = df.groupby("city")["amount"].agg(["sum", "max", "count"])
print(result)
5. 运行结果展示
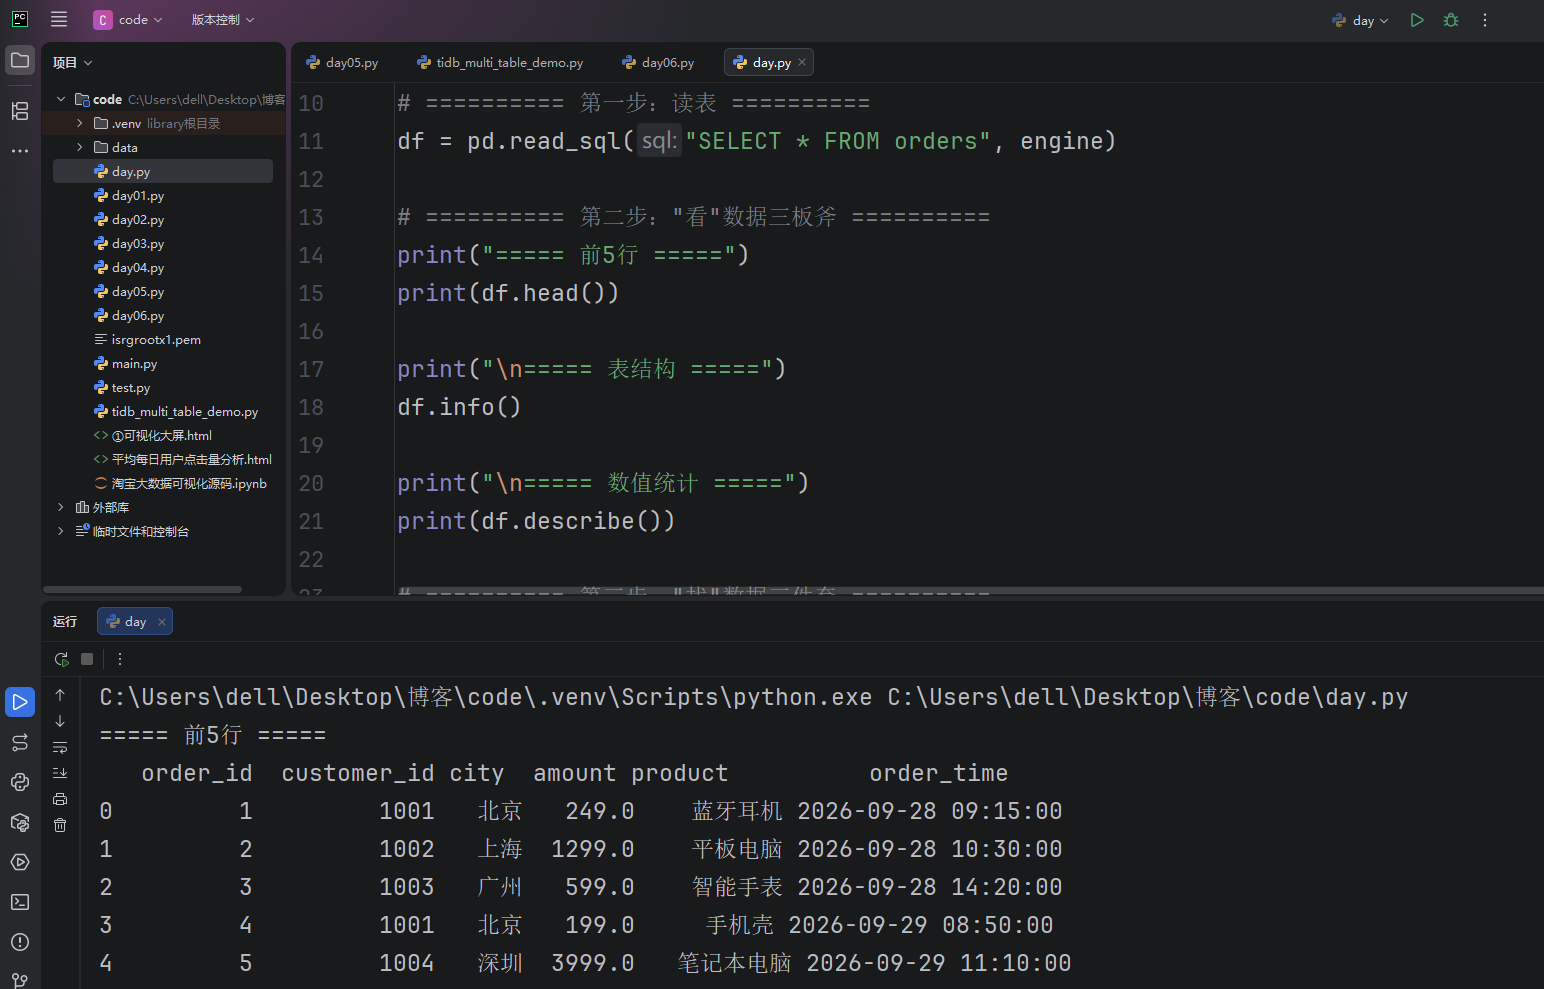
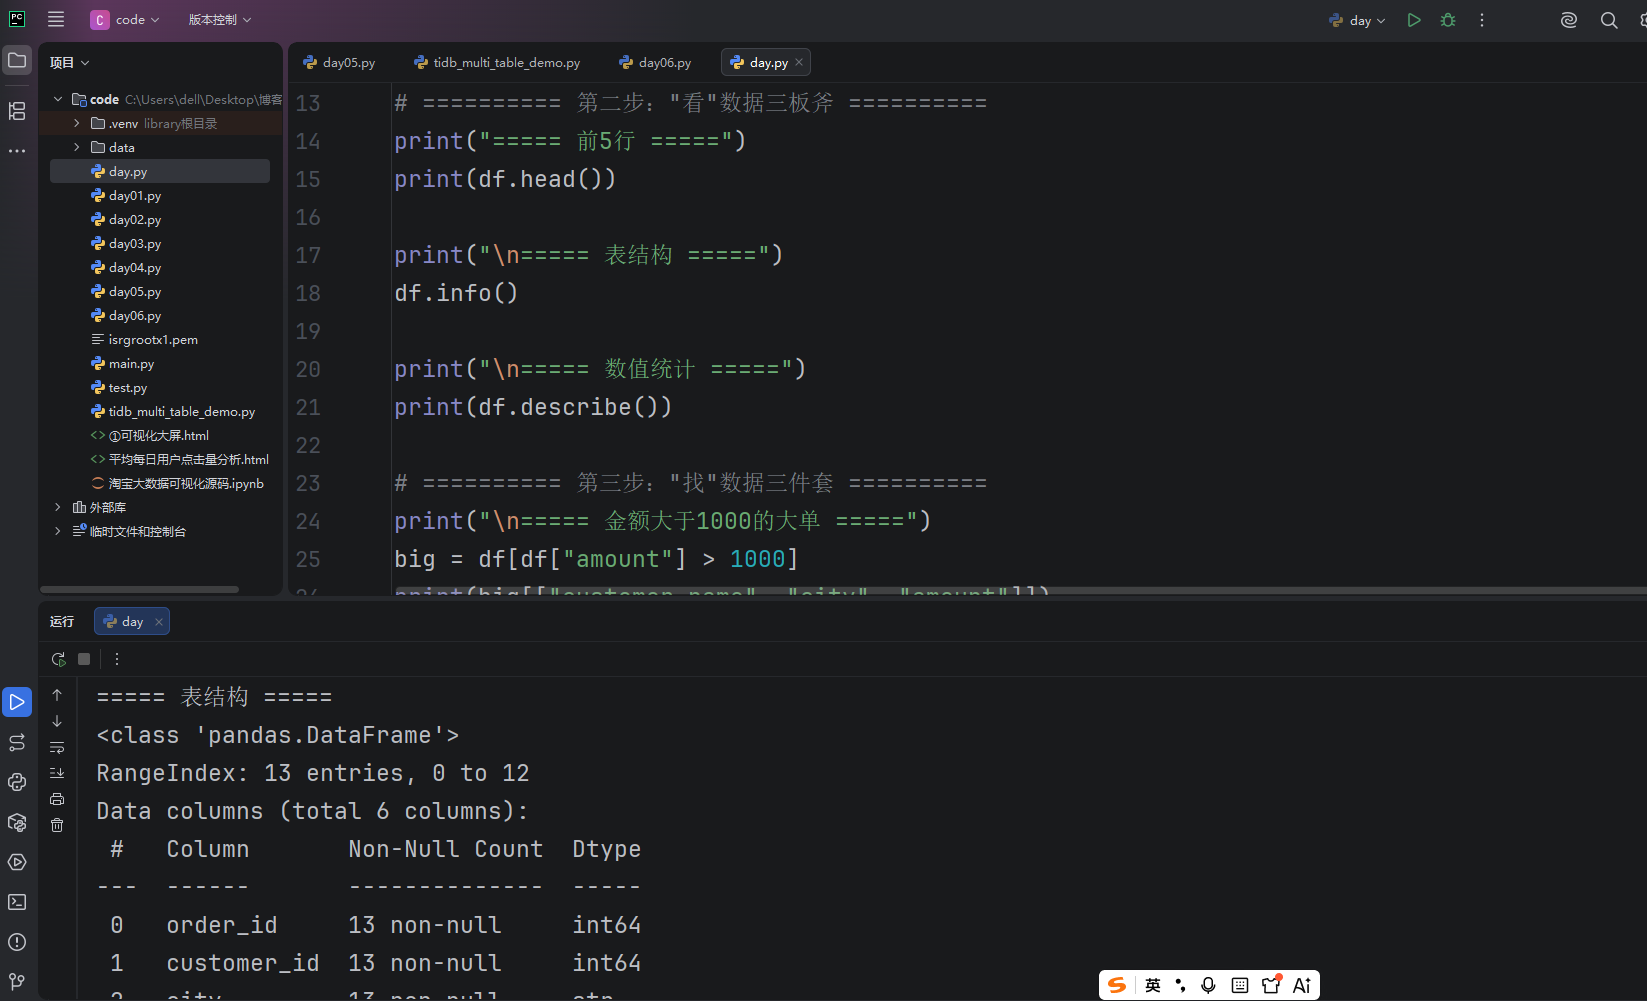
手把手对应讲解:
RangeIndex: 12 entries→ 表里一共 12 行- 每列都是
12 non-null→ 没有空值,这表很干净,不用修 Dtype是int64(整数)和object(字符串),类型正常


最后一步的 agg(["sum","max","count"]) 是进阶写法:一格代码出三张账,工作中做日报周报超常用。