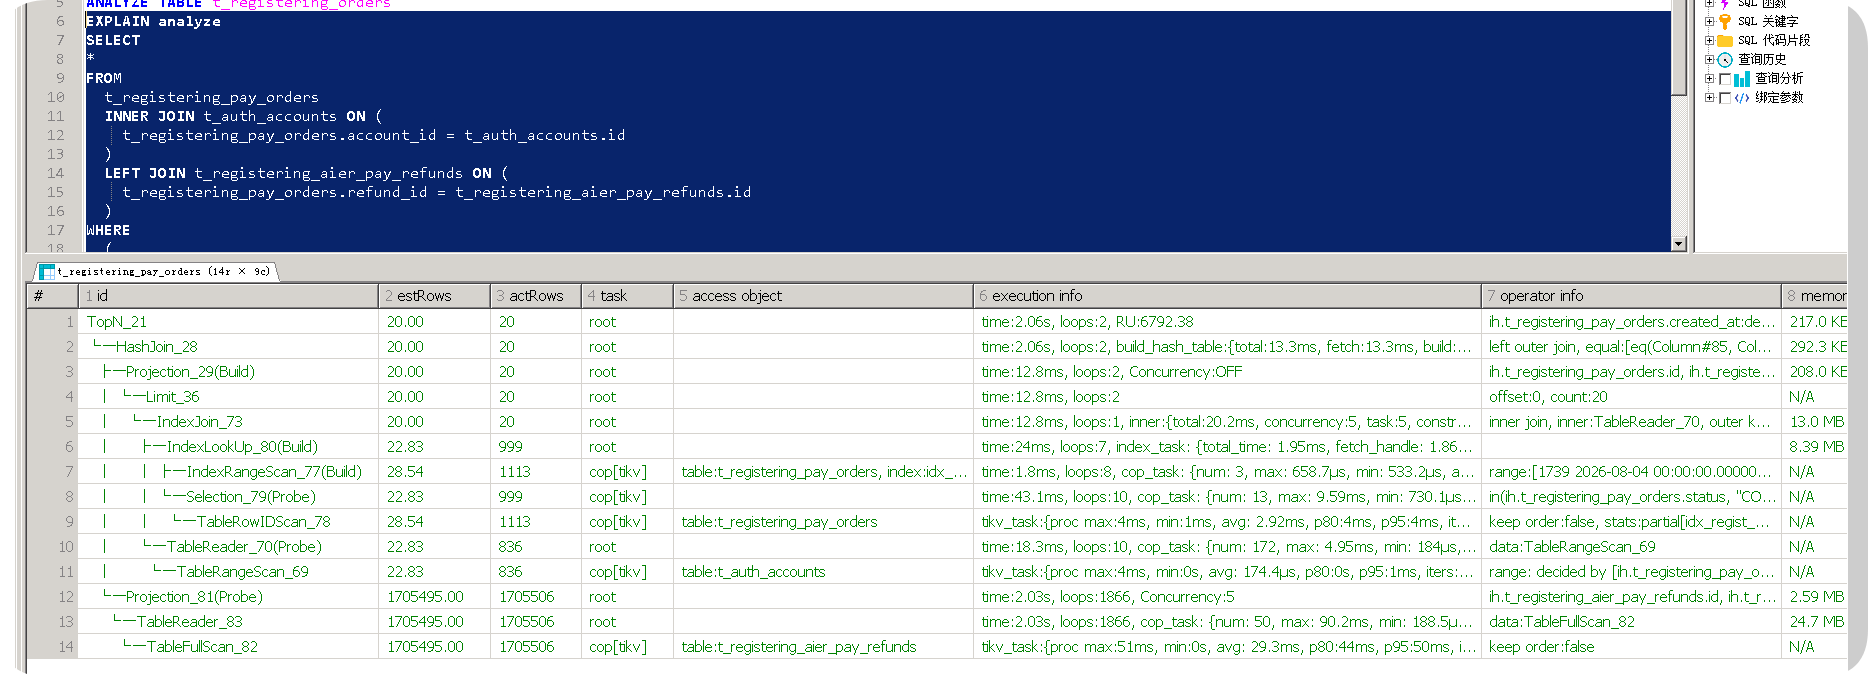
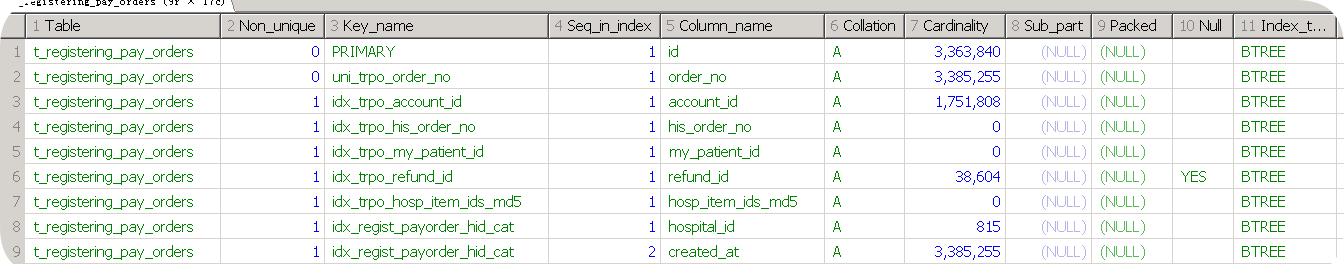
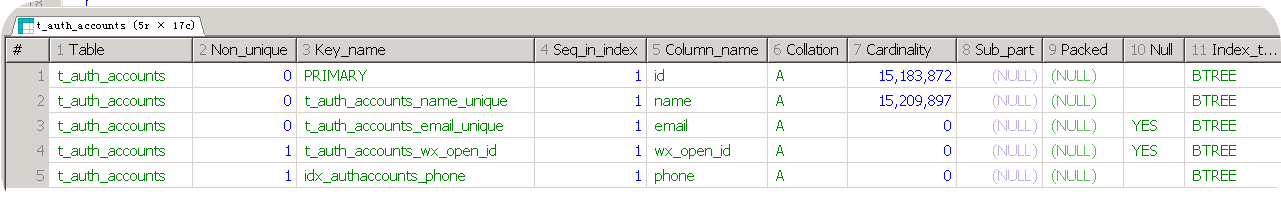
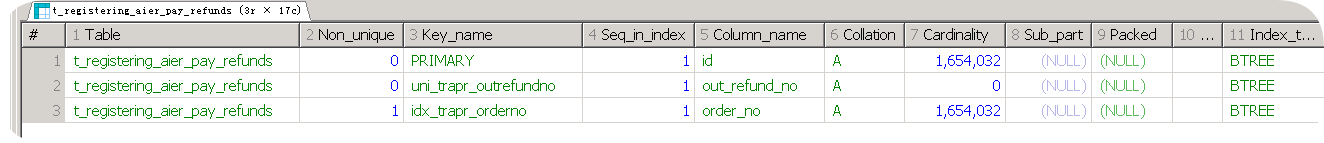

在tidb 执行的是hash join,mysql 里面是index join
看截图信息有限,先给几个排查方向:
-
检查关联字段的字符集和排序规则是否一致,不一致会导致索引失效。用
SHOW CREATE TABLE对比下两表相关列。 -
确认驱动表是否选对,小表驱动大表。如果 t_registering_aier_pay_refunds 是事实表且数据量大,试试加
STRAIGHT_JOIN强制驱动顺序。
来学习一下
SELECT
*
FROM
t_registering_pay_orders
INNER JOIN t_auth_accounts ON (
t_registering_pay_orders.account_id = t_auth_accounts.id
)
LEFT JOIN t_registering_aier_pay_refunds ON (
t_registering_pay_orders.refund_id = t_registering_aier_pay_refunds.id
)
WHERE
(
t_registering_pay_orders.created_at >= ‘2026-08-04 00:00:00’
)
AND (
t_registering_pay_orders.created_at < ‘2026-09-03 00:00:00’
)
AND (t_registering_pay_orders.hospital_id = 1739)
AND (
t_registering_pay_orders.status IN (‘CONFIRM_FAIL’, ‘FINISHED’, ‘CANCELLED’)
)
ORDER BY
t_registering_pay_orders.created_at DESC
LIMIT
20;
表结构
mysql> desc t_registering_pay_orders;
±-------------------------------±------------±-----±-----±--------±------------------+
| Field | Type | Null | Key | Default | Extra |
±-------------------------------±------------±-----±-----±--------±------------------+
| id | bigint | NO | PRI | NULL | |
| created_at | datetime(6) | NO | | NULL | |
| updated_at | datetime(6) | NO | | NULL | |
| account_id | bigint | NO | MUL | NULL | |
| order_no | varchar(32) | NO | UNI | NULL | |
| his_order_no | varchar(17) | NO | MUL | NULL | |
| my_patient_id | bigint | NO | MUL | NULL | |
| patient_info | json | NO | | NULL | |
| hospital_id | bigint | NO | MUL | NULL | |
| department_id | bigint | YES | | NULL | |
| department_info | json | NO | | NULL | |
| staff_id | bigint | YES | | NULL | |
| doctor_info | json | NO | | NULL | |
| total_price | bigint | NO | | NULL | |
| discount_code | varchar(50) | NO | | NULL | |
| order_info | json | NO | | NULL | |
| pay_at | datetime(6) | YES | | NULL | |
| pay_status | varchar(10) | NO | | NULL | |
| pay_info | json | YES | | NULL | |
| confirm_payment | json | YES | | NULL | |
| withdraw_at | datetime(6) | YES | | NULL | |
| cancel_at | datetime(6) | YES | | NULL | |
| wx_open_id | varchar(64) | YES | | NULL | |
| status | varchar(20) | NO | | NULL | |
| version | int | NO | | NULL | |
| refund_no | varchar(32) | YES | | NULL | |
| refund_at | datetime(6) | YES | | NULL | |
| refund_id | varchar(40) | YES | MUL | NULL | |
| pay_info_trx_no | varchar(30) | YES | | NULL | VIRTUAL GENERATED |
| item_ids | text | YES | | NULL | |
| medical_insurance_info | json | YES | | NULL | |
| pay_type | varchar(20) | YES | | NULL | |
| cost_type | varchar(10) | YES | | NULL | |
| pre_insure_at | datetime | YES | | NULL | |
| pay_price | bigint | NO | | NULL | |
| coupon_info | json | YES | | NULL | |
| acrm_channel_info | json | YES | | NULL | |
| terminate_at | datetime | YES | | NULL | |
| hosp_item_ids_md5 | varchar(32) | NO | MUL | NULL | |
| input_coupon_tickets | json | YES | | NULL | |
| coupon_tickets_locked | tinyint(1) | NO | | 0 | |
| insure_family | tinyint | YES | | NULL | |
| insure_confirmed | tinyint(1) | YES | | NULL | |
| confirm_payment_confirm_pay_id | varchar(30) | YES | | NULL | VIRTUAL GENERATED |
| shipment_info | json | YES | | NULL | |
| deliver_at | datetime | YES | | NULL | |
| shipping_address_id | bigint | YES | | NULL | |
| shipping_address_info | json | YES | | NULL | |
| account_channel | varchar(20) | YES | | NULL | |
±-------------------------------±------------±-----±-----±--------±------------------+
49 rows in set (0.00 sec)
mysql> desc t_auth_accounts;
±------------------±-------------±-----±-----±--------±------+
| Field | Type | Null | Key | Default | Extra |
±------------------±-------------±-----±-----±--------±------+
| id | bigint | NO | PRI | NULL | |
| created_at | datetime(6) | NO | | NULL | |
| updated_at | datetime(6) | NO | | NULL | |
| name | varchar(40) | NO | UNI | NULL | |
| email | varchar(40) | YES | UNI | NULL | |
| phone | varchar(40) | NO | MUL | NULL | |
| nickname | varchar(50) | YES | | NULL | |
| password | varchar(255) | NO | | NULL | |
| salt | varchar(8) | NO | | NULL | |
| active | tinyint(1) | NO | | 1 | |
| last_login_at | datetime(6) | NO | | NULL | |
| photo | varchar(255) | YES | | NULL | |
| wx_open_id | varchar(64) | YES | MUL | NULL | |
| referral_code | varchar(20) | YES | | NULL | |
| referral_info | json | YES | | NULL | |
| acrm_channel_info | json | YES | | NULL | |
| deleted | tinyint(1) | YES | | NULL | |
| deleted_at | datetime | YES | | NULL | |
±------------------±-------------±-----±-----±--------±------+
18 rows in set (0.00 sec)
mysql> desc t_registering_aier_pay_refunds;
±------------------------±-------------±-----±-----±--------±---------------+
| Field | Type | Null | Key | Default | Extra |
±------------------------±-------------±-----±-----±--------±---------------+
| id | bigint | NO | PRI | NULL | auto_increment |
| created_at | datetime(6) | NO | | NULL | |
| updated_at | datetime(6) | NO | | NULL | |
| order_no | varchar(32) | NO | MUL | NULL | |
| order_type | varchar(16) | NO | | NULL | |
| out_refund_no | varchar(32) | NO | UNI | NULL | |
| amount | bigint | NO | | NULL | |
| refund_amount | bigint | NO | | NULL | |
| reason | varchar(100) | YES | | NULL | |
| channel_type | varchar(16) | NO | | NULL | |
| status | varchar(20) | NO | | NULL | |
| refund_at | datetime | YES | | NULL | |
| refund_tx_no | varchar(40) | YES | | NULL | |
| refund_channel_order_no | varchar(32) | YES | | NULL | |
| dummy | tinyint(1) | NO | | 0 | |
| trans_number | varchar(25) | YES | | NULL | |
| refund_by | json | YES | | NULL | |
±------------------------±-------------±-----±-----±--------±---------------+
17 rows in set (0.00 sec)
ai的建议非常好
看了一下表结构和 SQL,这个查询的主要瓶颈不在 JOIN,而在 t_registering_pay_orders 上没有包含 created_at 的索引。逐条分析:
问题诊断
- 过滤 + 排序走不了同一个索引(核心问题)
- WHERE 用了
hospital_id + created_at 范围 + status,ORDER BY 用created_at DESC - 现有索引只有
hospital_id单列:MySQL 只能按医院筛出整月的数据,再对created_at做 filesort,最后才 LIMIT 20。医院单量大的话,排序代价非常高。
SELECT *拖了大量 JSON 大字段:patient_info、doctor_info、order_info、pay_info、coupon_info、shipment_info……十几个 JSON 列,且三表都有id/created_at/updated_at/order_no同名列,结果集里也容易出歧义。- 类型不匹配的隐患:
t_registering_pay_orders.refund_id是varchar(40),而t_registering_aier_pay_refunds.id是bigint。JOIN 时发生隐式转换(数值化),虽然走 LIMIT 后每行仍是 PK 查找,但这是设计层面的脏点,极端情况(空串、非纯数字)会匹配错误。
优化方案
1. 加复合索引(最关键,一条就够)
sql
ALTER TABLE t_registering_pay_orders
  ADD INDEX idx_hosp_created_status (hospital_id, created_at, status);
设计思路:
hospital_id等值 →created_at范围 + 倒序扫描(天然满足ORDER BY created_at DESC,无 filesort)status放第三列 → 状态过滤在索引内完成(覆盖过滤),不匹配的行不用回表- 找够 20 条立即停止扫描,扫描量从“整月订单”降到“约 20 行附近”
补充:如果该医院这 3 种状态的订单占比很低(比如全月大多行状态都不在 IN 列表里),可改用
(hospital_id, status, created_at),按 3 个状态各走一段倒序范围再取 top 20,两个方案二选一,用 EXPLAIN 验证。一般业务上 FINISHED/CANCELLED 是大头,前者更优。
2. SQL 改写(显式列 + 表别名)
sql
SELECT
    o.id, o.order_no, o.created_at, o.pay_at, o.status, o.pay_status,
    o.total_price, o.pay_price, o.refund_no, o.refund_at, o.pay_type,
    a.id          AS account_id,
    a.name        AS account_name,
    a.phone       AS account_phone,
    r.id          AS refund_id,
    r.out_refund_no, r.refund_amount, r.status AS refund_status, r.refund_at AS refund_real_at
FROM t_registering_pay_orders o
JOIN t_auth_accounts a
     ON a.id = o.account_id          -- PK 关联,无需处理
LEFT JOIN t_registering_aier_pay_refunds r
     ON r.id = o.refund_id           -- 注意 varchar ↔ bigint 类型不一致
WHERE o.hospital_id = 1739
  AND o.created_at >= '2026-08-04 00:00:00'
  AND o.created_at <  '2026-09-03 00:00:00'
  AND o.status IN ('CONFIRM_FAIL', 'FINISHED', 'CANCELLED')
ORDER BY o.created_at DESC
LIMIT 20;
JOIN 两个表都走主键点查(每行 ≤1 次 PK lookup,总共 ≤20 次),这部分本来就不是瓶颈,保持即可。
3. 验证
sql
EXPLAIN ANALYZE SELECT ... ; -- MySQL 8.0+
加索引后应看到:o 表 key = idx_hosp_created_status,Extra 里不再出现 Using filesort,扫描行数(rows)降到几十以内;两个 JOIN 均为 eq_ref。
4. 建议顺手修的两个隐患
refund_id varchar(40)↔id bigint类型对齐:要么把refund_id改成bigint(需确认该列是否存过非数字值,先SELECT refund_id FROM t_registering_pay_orders WHERE refund_id IS NOT NULL AND refund_id NOT REGEXP '^[0-9]+排查),要么关联时显式r.id = CAST(o.refund_id AS UNSIGNED)。- 时间跨度整月的查询建议按
created_at分页时带上created_at游标(WHERE created_at < 上一页最后一条)而不是LIMIT offset,越翻越深也不会变慢。
一句话总结:加 (hospital_id, created_at, status) 复合索引,让“按医院过滤 + 时间倒序 + LIMIT 20”变成一次索引倒序扫描立即截断;同时把 SELECT * 换成显式列,避免拖十几个 JSON 大字段。 LIMIT 10;排查),要么关联时显式DISCOURSE_PLACEHOLDER_41`。
- 时间跨度整月的查询建议按
DISCOURSE_PLACEHOLDER_42分页时带上DISCOURSE_PLACEHOLDER_43游标(DISCOURSE_PLACEHOLDER_44)而不是DISCOURSE_PLACEHOLDER_45,越翻越深也不会变慢。
一句话总结:加 DISCOURSE_PLACEHOLDER_46 复合索引,让“按医院过滤 + 时间倒序 + LIMIT 20”变成一次索引倒序扫描立即截断;同时把 DISCOURSE_PLACEHOLDER_47 换成显式列,避免拖十几个 JSON 大字段。
全表扫描一般就两个原因:一是关联或过滤条件用的列在这张表上没有可用索引,二是优化器选了 Hash Join 本来就会整表读。你这里执行计划变了,变成hash join
| refund_id | varchar(40) | YES | MUL | NULL | |
| id | bigint | NO | PRI | NULL | auto_increment |
做了隐士类型转换了,索引没有派上用场,走了全表扫描
t_registering_pay_orders.refund_id = t_registering_aier_pay_refunds.id
检查这两个字段是主键吗,字段类型是啥