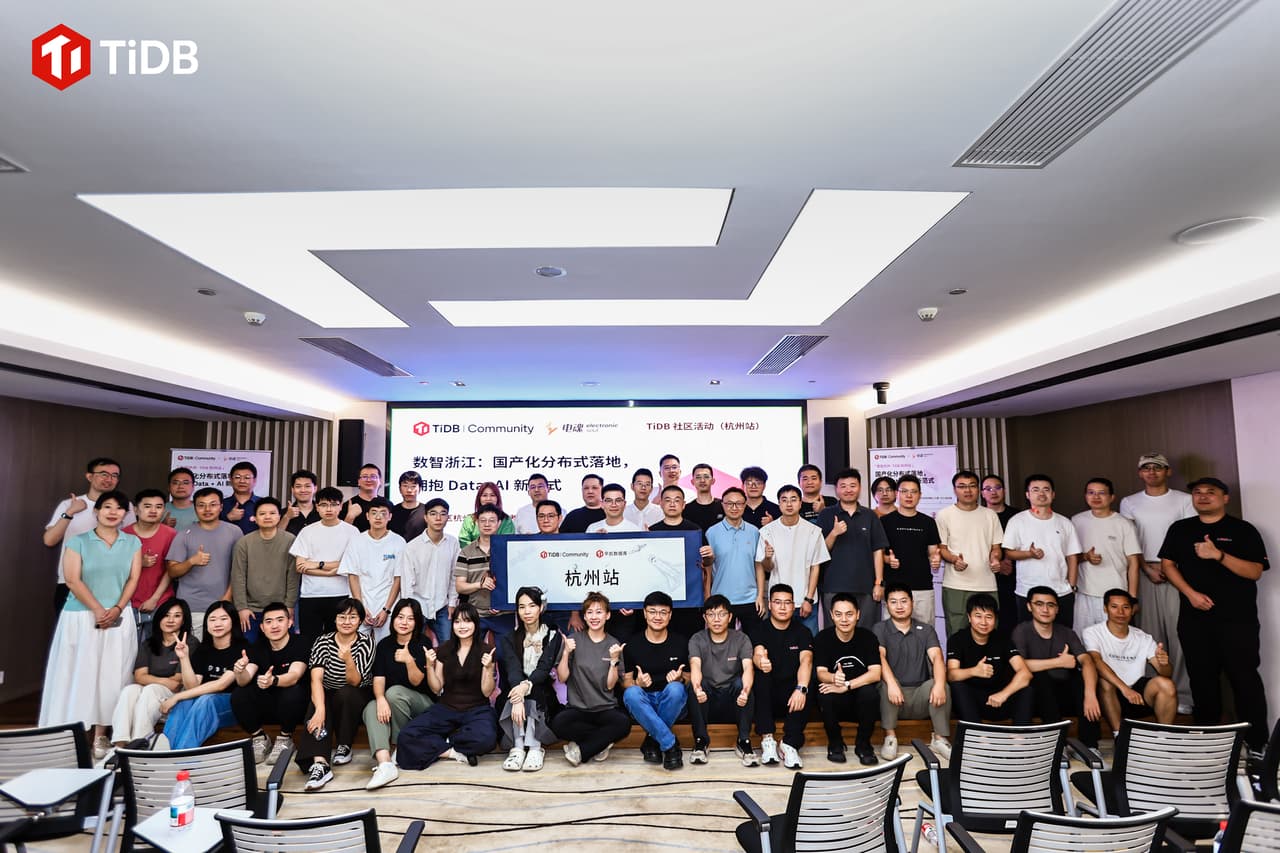
9 月 12 日,TiDB 社区「数智浙江」Data+AI 线下技术交流会于杭州圆满举办,众多本地企业技术同仁齐聚现场,共探技术实践。特别感谢电魂网络对本次活动的大力支持!
本次活动围绕国产化 分布式数据库 落地与Data+AI 新 范式两大方向展开。来自中亦科技、DatusAI、某股份制银行、正泰安能、融同科技的技术专家,分享 TiDB 在核心系统国产化改造、Data Agent 语义层、实时 ODS、财务共享性能优化、AI 驱动开发体系等场景的实战案例。
圆桌环节,月之暗面 Kimi、德哥、云贝教育、杭州益丰文化与 TiDB AI 负责人等嘉宾,以企业 Agent 严肃落地与稳定运行为主题展开深度研讨,从智能体安全运行管控、数据治理、AI 基础设施选择等维度,交流落地痛点与实践经验。
照片链接:https://live.pailixiang.com/album/a13683816119?from=singlemessage
PPT 下载
面向 Data Agent 的开放语义层:从指标定义到 TiDB SQL.pdf (3.6 MB)
从分布式实时 ODS 到信创聚合库:某股份制银行 TiDB 实践与 AI 运维展望.pdf (5.5 MB)
破局性能瓶颈:正泰安能财务共享TiDB试点落地实践.pdf (6.6 MB)
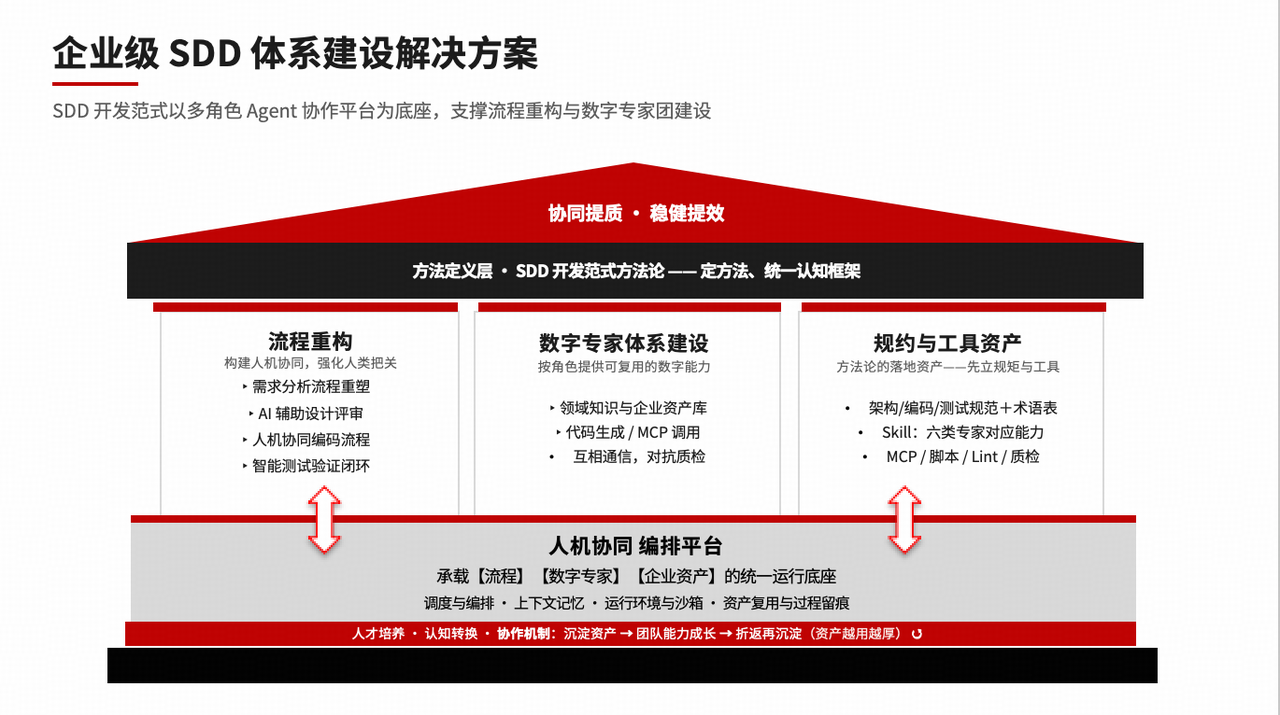
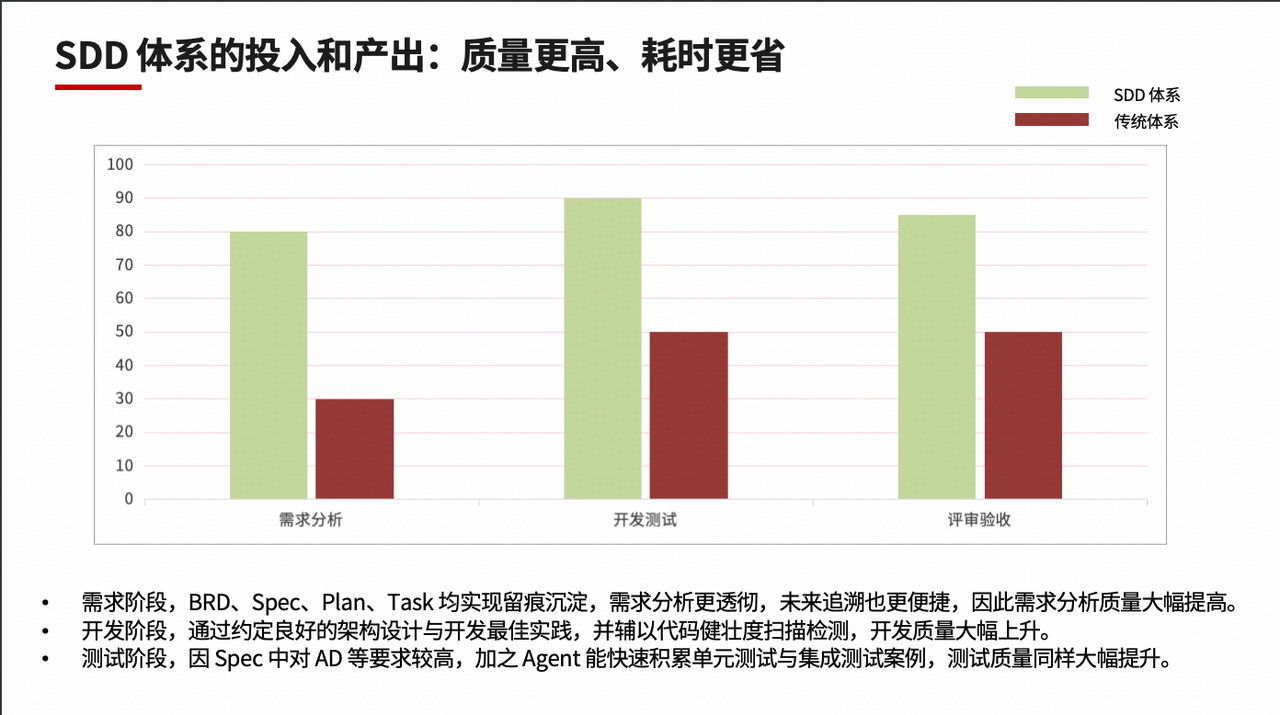
从“人治”到“智治”,AI 驱动 SDD 开发体系的落地实践.pdf (6.0 MB)
中亦科技:云南农信核心系统上百套 TiDB 应用实践
分享嘉宾: 李琪|中亦科技数据库工程师、云南农信 TiDB 现场负责人、PCTP、 IFClub 成员
分享概要:
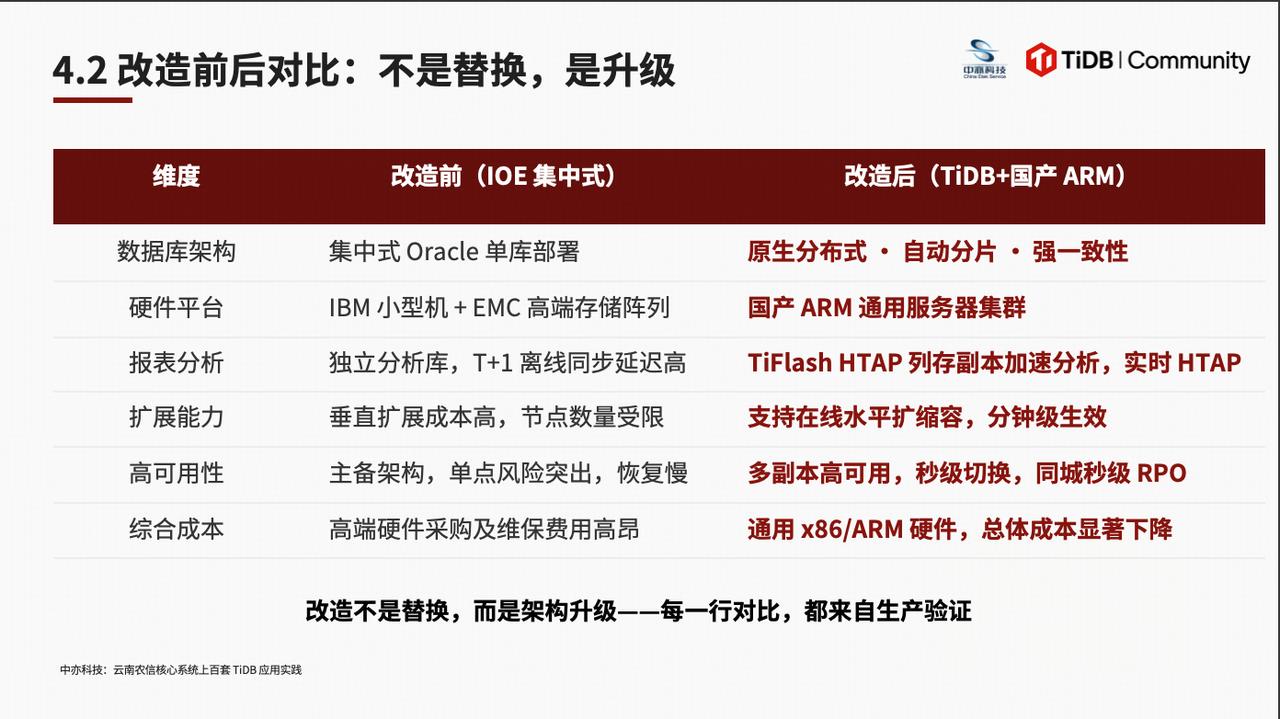
云南农信在推进多个核心系统的业务重构时,原有的 IOE 集中式架构已难以支撑——扩展能力受限、业务耦合严重、高并发下锁冲突突出,IBM 小型机与 EMC 存储的成本也居高不下,向分布式数据库转型势在必行。
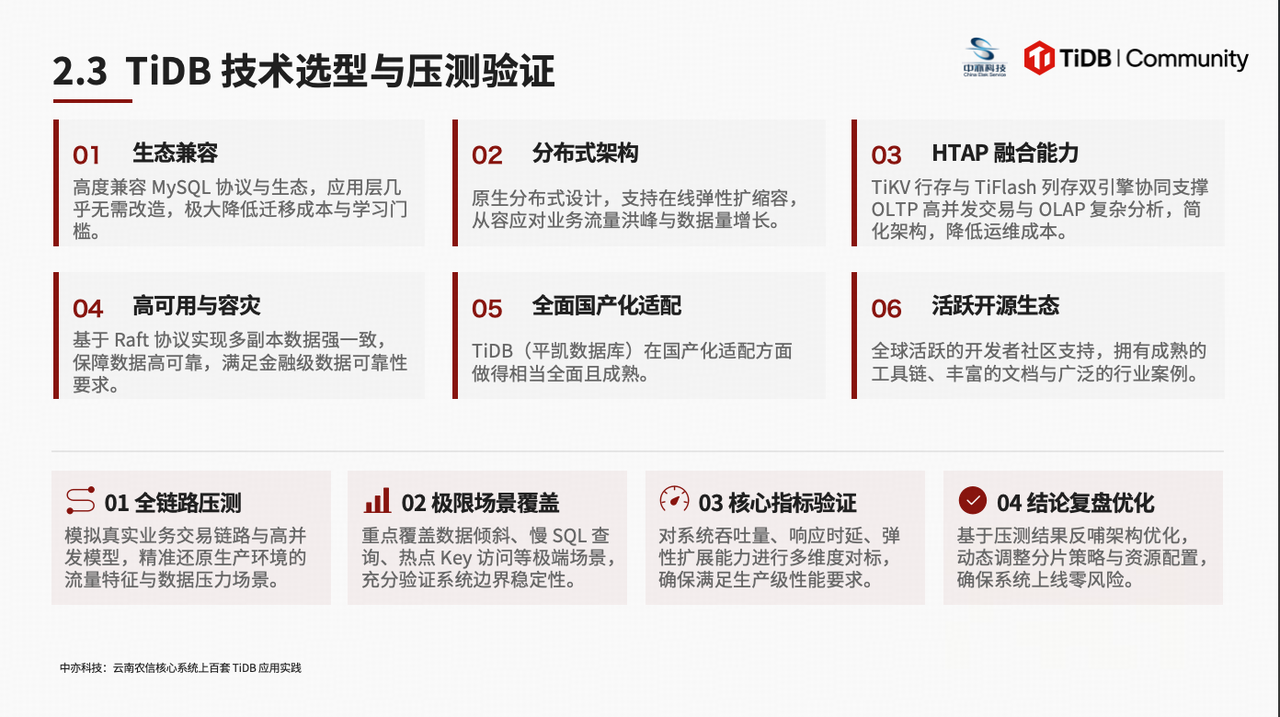
团队从 MySQL 兼容性、分布式弹性、HTAP 能力、高可用容灾、国产化适配到开源生态进行了综合评估,最终选择了 TiDB。从 2025 年 6 月选型到 2026 年 7 月验收,150 多个系统在一年内全部上线,目前运行着百套生产集群、百套 TEM 统一纳管、百TB 以上的数据量。TiFlash 将报表查询提速 11 倍,v8.4 原生向量搜索可支撑金融 RAG 知识库,召回率达 94%,交易、分析与 AI 向量负载由一套集群统一承载,为金融行业核心系统的分布式转型提供了可参考的实践样本。
面向 Data Agent 的开放语义层:从指标定义到 TiDB SQL
分享嘉宾:Harrison Zhao|DatusAI 创始人 · Dosi 作者

分享概要:
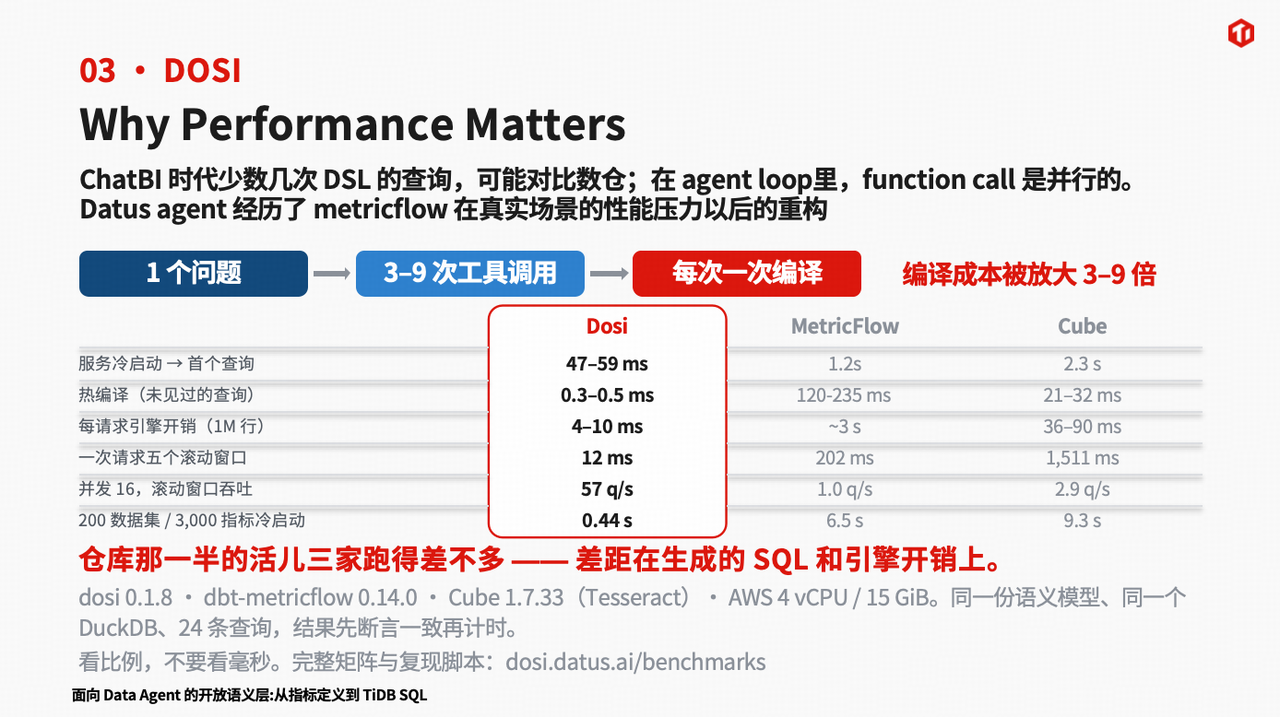
DatusAI 创始人赵恒提出了一个很实际的问题:向 Agent 提出一个数据分析请求,背后需要调用 5 到 9 次工具,每一步都依赖指标口径、数据粒度、join 路径和 SQL 方言的语义支撑。缺少语义层时,模型只能自行推断,导致 join 扇出重复计数、比率不可加等错误——这些 SQL 都能正常执行,直到两个看板的数据在会上对不上才会暴露。
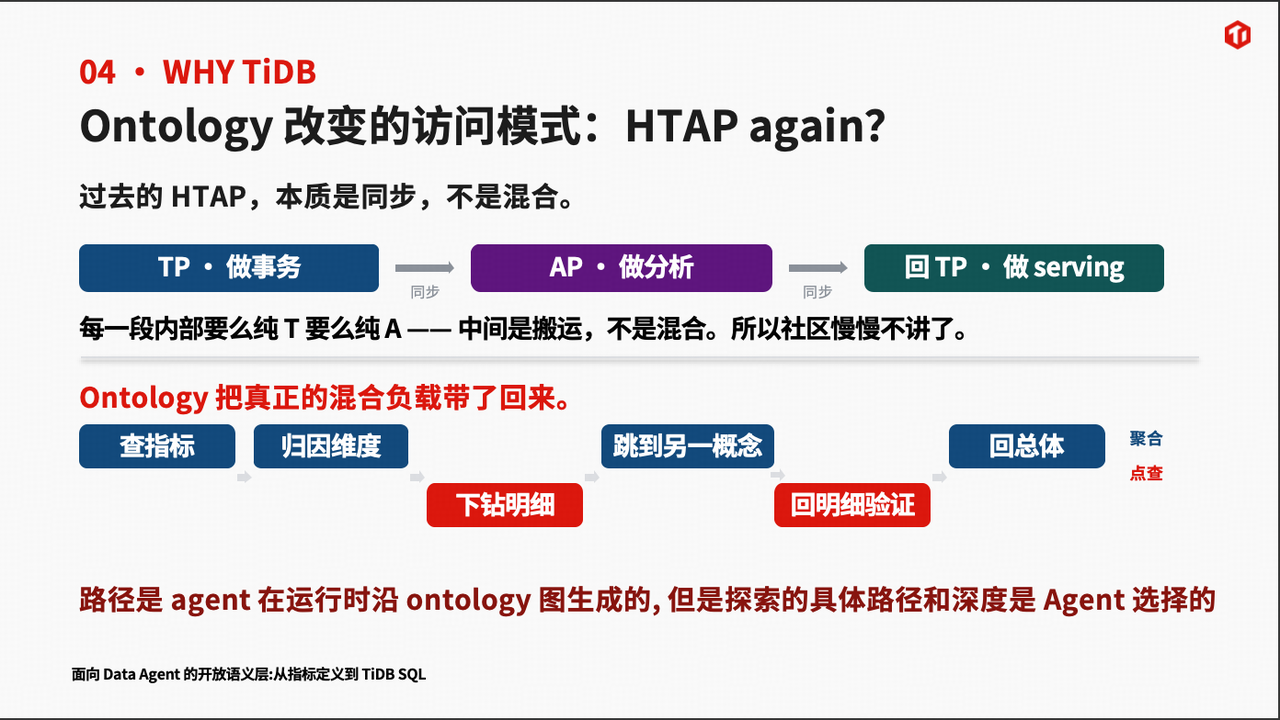
为此他们构建了 Apache Ossie 语义规范和 Dosi 执行引擎,采用 Rust 编写,冷启动仅 47 到 59 毫秒,支持 16 种以上数据仓库方言,TiDB 也在其中。选择 TiDB 的原因在于,Agent 的负载特征独特——突发高并发、毫秒级点查与大吞吐聚合交替出现,TiDB 的存算分离、弹性伸缩与行列混合 Serverless HTAP 恰好匹配这一负载形态,Ontology 还能让聚合与明细共用同一套语义,真正实现混合负载。
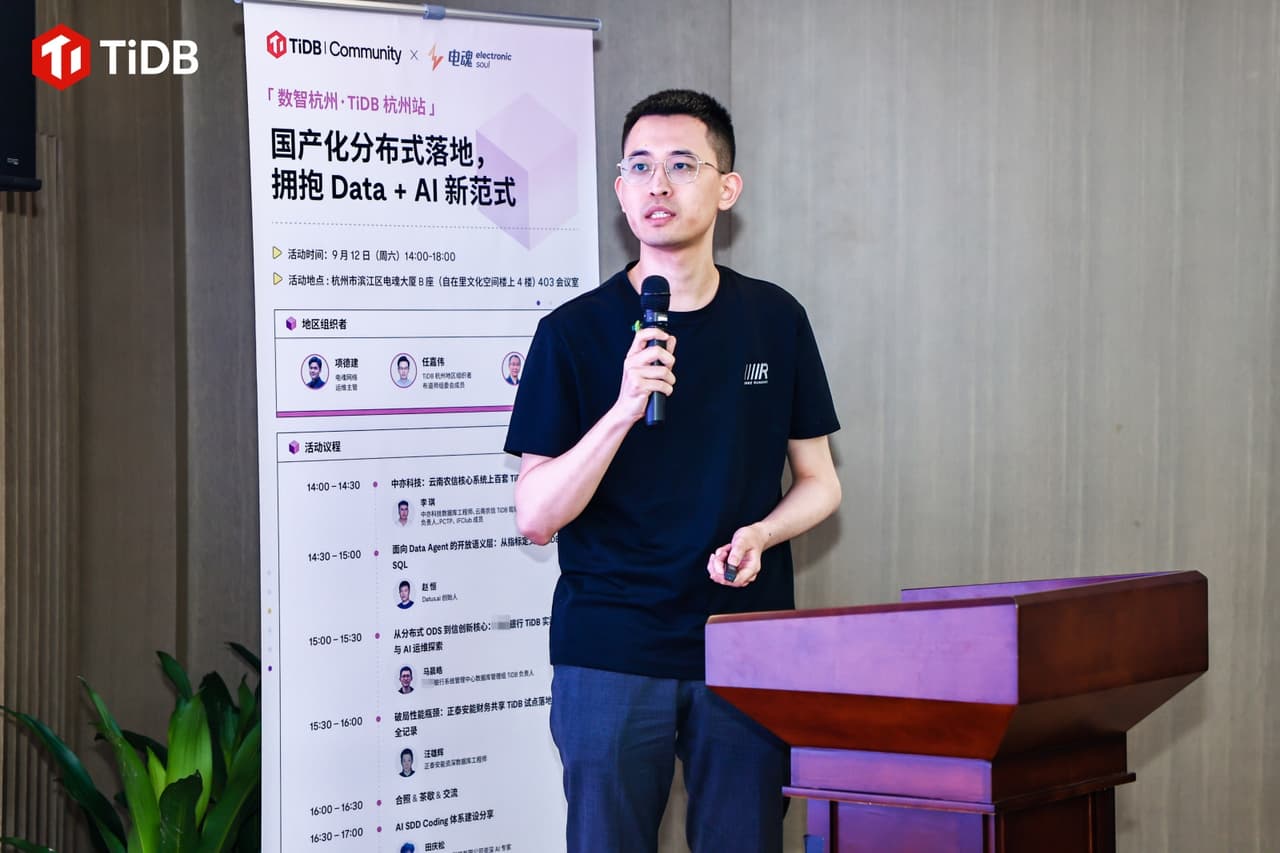
从分布式实时 ODS 到信创聚合库:某股份制银行 TiDB 实践与 AI 运维展望
分享嘉宾:马晨皓|某股份制银行系统管理中心数据库管理组 TiDB 负责人

分享概要:
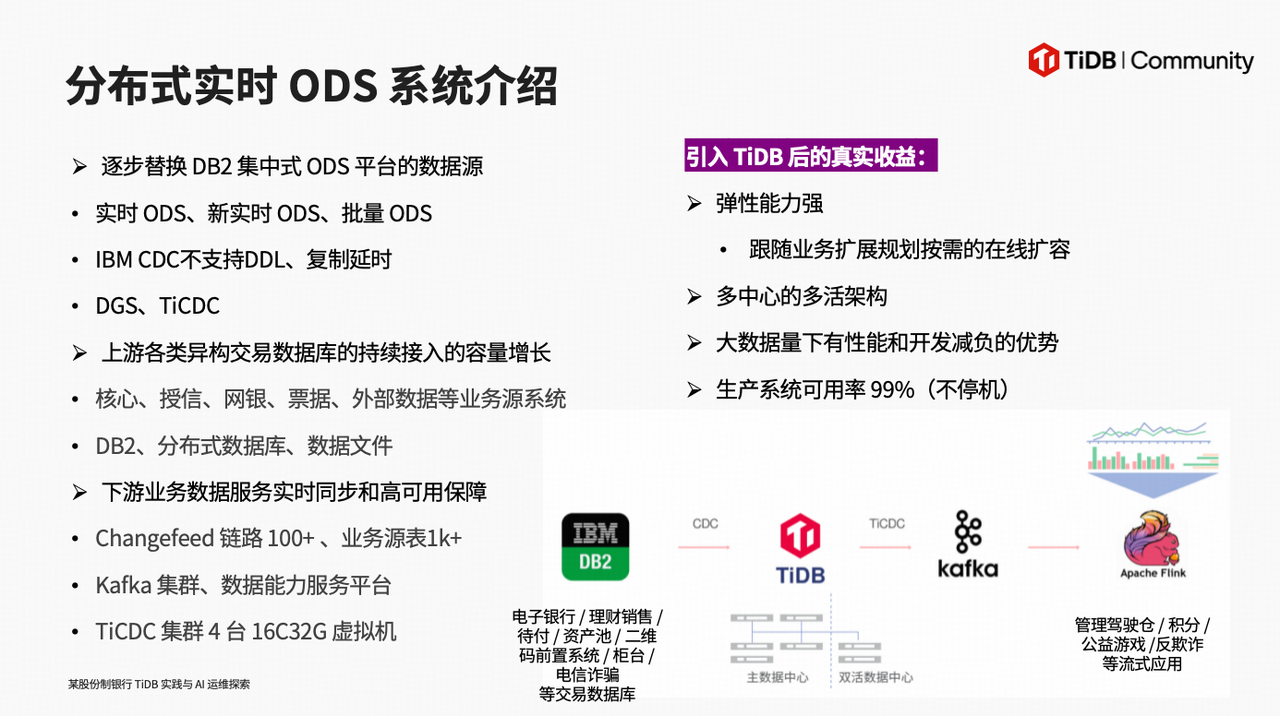
某股份制银行原采用 DB2 构建集中式 ODS 平台,但在实时同步、事务型操作和复杂分析方面均存在不足。随着上游核心、授信、网银等异构数据库的持续接入,数据量快速增长,下游电子银行、反欺诈等流式应用对数据时效性的要求也不断提高,原有平台已难以满足需求。
行内对四种数据库对比评估后,TiDB 凭借十亿级单表性能稳定、透明分片改造成本低、TiCDC 增量同步成熟等优势入选。自 2021 年上线以来,已运行 8 套多生产集群,支撑 15 个以上业务系统,生产可用率 99%。信创聚合库采用 TiCDC-standalone 模式,无需单独搭 CDC 集群即可提供三种同步方案;团队还提出"先有 API 再有 AI"的思路,TiDB 未来可作为承载 Agent 记忆与会话状态的 AI 业务中台底座。
破局性能瓶颈:正泰安能财务共享 TiDB 试点落地实践
分享嘉宾:汪雄辉|正泰安能数据库工程师

分享概要:
正泰安能财务共享平台基于低代码平台构建,系统自动生成的 SQL 普遍存在多表关联、查询条件动态组合的情况,而平台不提供底层源码,手工优化 SQL 无从下手,导致 SQL 慢、接口慢、页面慢的连锁问题。
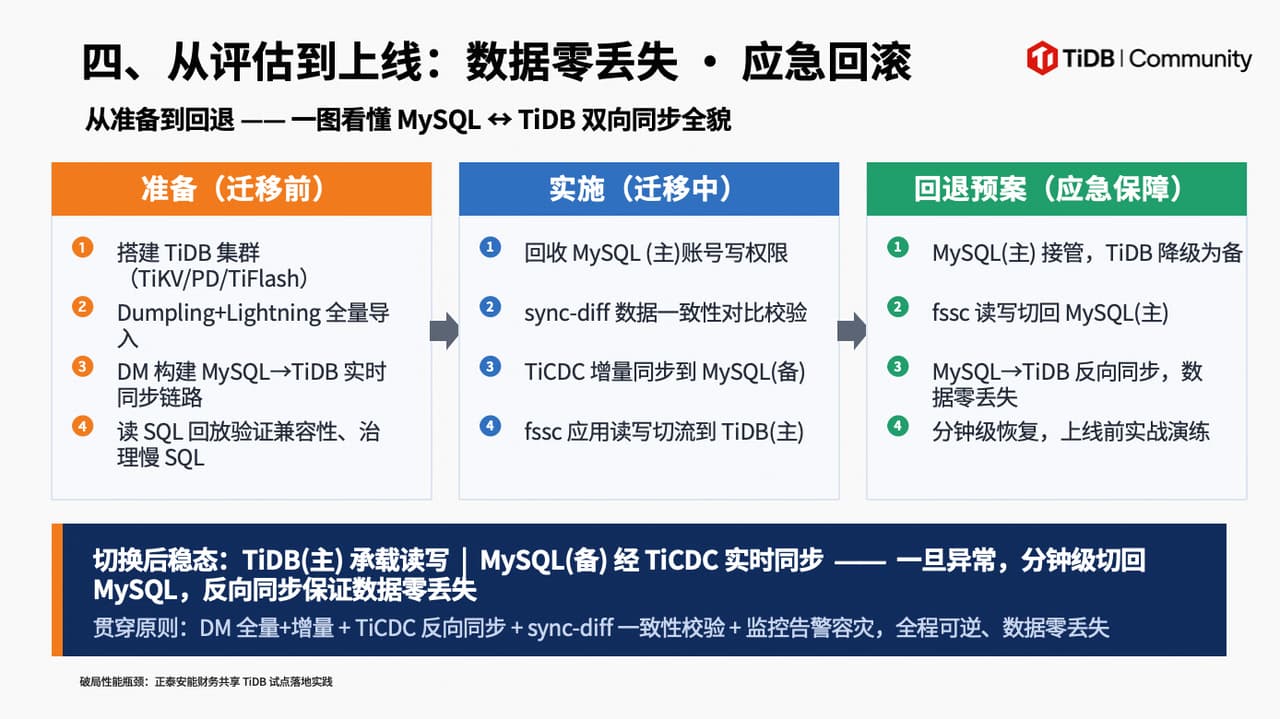
团队对多款数据库进行对比评估,并在生产环境采集 100 万条真实 SQL 开展回放测试,TiDB 平均耗时仅 4.08 毫秒,较 MySQL 快 28 倍,性能波动最小,最终入选。迁移采用 DM 与 TiCDC 双向同步方案,异常情况下可分钟级回切且数据零丢失。低代码平台无法修改 SQL 这一约束,恰恰成为 TiDB 的优势场景——依靠原生分布式执行引擎与多节点分担直接压制长尾延迟,自增 ID 与分页排序的分布式特性差异,通过两个参数即可平滑适配,验证了 TiDB 在无法改 SQL 的约束场景下仍能有效解决性能瓶颈。
从"人治"到"智治",AI 驱动 SDD 开发体系的落地实践
分享嘉宾:田庆松|融同(北京)科技有限公司资深 AI 专家
分享概要:
融同科技资深 AI 专家田庆松指出,直接让 AI 编写代码会引发需求失真、评审跟不上、代码质量失控等问题,AI 生成速度越快,缺乏约束时失控风险越高。
为此他们构建了 SDD 体系,以多角色 Agent 协作平台为底座,各阶段配置执行与双评审 Agent,七个环节设立签字门禁,缺陷逃逸率降低 39%,交付周期从 19 天缩短至 13 天。多智能体协作对数据持久化要求较高,TiDB 作为底层数据底座,支持 SQL、向量、全文检索统一存储,ACID 与 HTAP 能力可满足需求,为 Agent 协作提供可靠的数据保障。
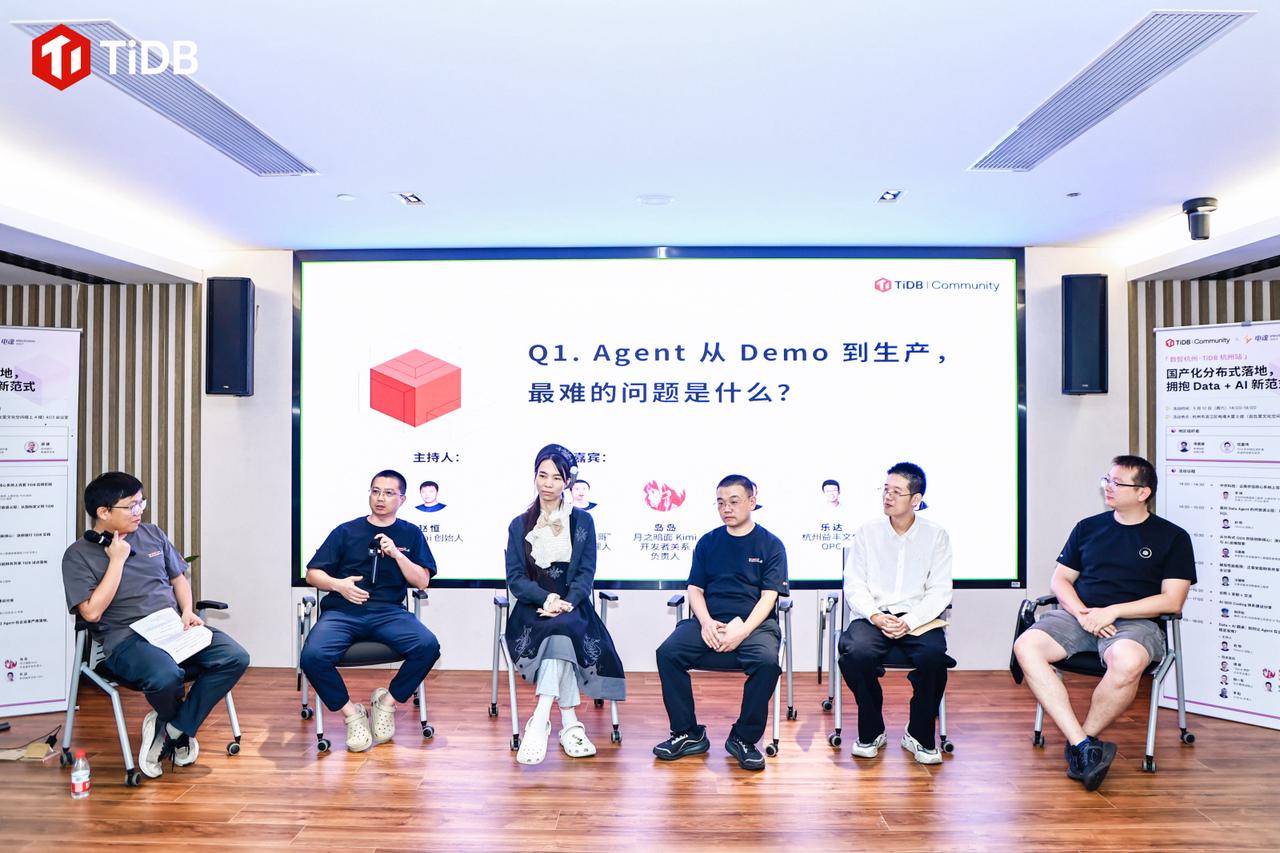
Data+AI 圆桌:如何让 Agent 在企业里严肃落地、稳定发挥?
主持人:赵恒|Datus.ai 创始人
圆桌嘉宾:
德哥|"digoal 德哥"公众号主理人
岛岛|月之暗面 Kimi 开发者关系负责人
郭一军|云贝教育创始人
乐达|杭州益丰文化 OPC
李粒|TiDB AI 负责人
圆桌概要:
本次 Data+AI 圆桌由 Datus.ai 创始人赵恒主持,邀请来自数据库社区、大模型厂商、IT 培训机构、OPC 从业者和 TiDB AI 团队的六位嘉宾,围绕"如何让 Agent 在企业里严肃落地、稳定发挥"展开深入探讨。圆桌共设置四个核心议题:
Q1:Agent 从 Demo 到生产,最难的问题是什么?
Q2:一个 Agent 要长期稳定工作,关键能力到底是什么?
Q3:企业级 Agent 怎么做到稳定、可靠、可控?
Q4:Data + AI,怎么真正从信息走向 Decision & Action?
落地建议合集
-
区分企业内部与对外服务Agent,二者核心难点不同。企业内部Agent最大瓶颈是业务抽象与数据对接;面向海量外部用户的Agent,重点解决权限越权管控、Skill管理、长任务Checkpoint容错。
-
Agent生产落地不能单纯依赖 大模型 基座能力,Honeycomb(蜂巢)架构是长期稳定运行的关键,需要建设面向组织业务的垂类Agent体系,实现数据、插件调用、访问权限全程可控。
-
Memory记忆层需要分层治理,增加权重评分机制。划分为短期会话记忆、长期历史记忆、业务规则边界、Skill脚本参考库;人工纠正错误后,需要下调历史错误样本的召回权重,避免Agent重复犯同样错误。
-
长耗时Agent任务需要重构底层基建,传统SaaS架构不再适配。运行数小时的任务要支持Checkpoint快照,系统崩溃后可从断点恢复执行;不建议使用SQLite、本地文件存储有状态任务数据。
-
做好底层数据标准化与数据契约管理,保证数据实时更新;沉淀Golden Case(正向案例)与Bad Case(负面案例),系统变更后重跑案例集做回归验证,降低数据不一致引发的模型幻觉。
-
金融等高风险行业落实三重可控原则:预期可控、流程可控、权限可控。划定Agent明确能力边界;低风险工作交由Agent执行,中风险人机协同,高风险严禁Agent直接操作;优先输出报告、分析建议,禁止直接执行高危业务变更。
-
Agent调用链会持续 累积误差 ,必须强化可观测性建设。接入链路追踪SDK,采集输入输出、Token消耗、人工介入率、任务达成率等指标;做到故障可定位、可回滚,企业级Agent本质是端到端的治理问题。
-
优先选择非标、重复耗人力、风险可控的场景作为落地切入点,例如供应商入库、数据库巡检报表。这类工作占用人力、重复度高,但关键业务节点必须保留人工复核。
-
推行Human‑in‑the‑Loop人机闭环机制,Agent完成基础执行工作,关键节点由人审核确认;在业务执行中持续沉淀真实业务案例,迭代提升Agent成功率。Human‑in‑the‑loop不是可选项,已经成为Agent业务成本的一部分。
-
尽量把Agent不确定的推理逻辑沉淀为Skill、脚本,把动态推理转化成确定性能力,是提升稳定性最直接的手段。
-
会话、任务快照、工具调用记录等状态数据,采用 分布式数据库 持久化存储。企业大规模Agent场景下,Session Event数据可达上百TB,单条上下文可达几十MB,本地存储极易发生数据丢失。
-
权限校验不能只写在Prompt提示词中,提示词容易被上下文、记忆干扰,必须外置独立规则引擎完成权限校验,高危操作设置二次确认。
-
Agent不能取代传统 软件工程 能力,幂等、补偿、回滚、数据校验等能力依旧需要传统软件方案补齐,不能全部寄希望于大模型推理。
-
Data+AI从数据展示走向决策与行动,元数据是基础底座。数据库表、字段要补齐业务注释与描述信息;缺少元数据语义,模型很难生成正确SQL与业务分析结论。
-
做好数据语义抽象,严格隔离数据读、写权限,不允许模型直接操作原始业务数据表。
-
引入信息增强与多Agent交叉校验机制。Agent拿到查询结果后补充外部业务信息做核验,重要场景通过多智能体交叉核对,减少低级错误。
-
Agent自主决策的边界取决于验证能力:自动化验证覆盖的场景越多,可交给AI自主完成决策与行动的范围就越大。
-
生产环境首要考虑故障兜底问题:Agent一旦出错,要提前设计好排查链路、追责机制,将风险约束在可控范围,这是从Demo走向生产必须验证的课题。
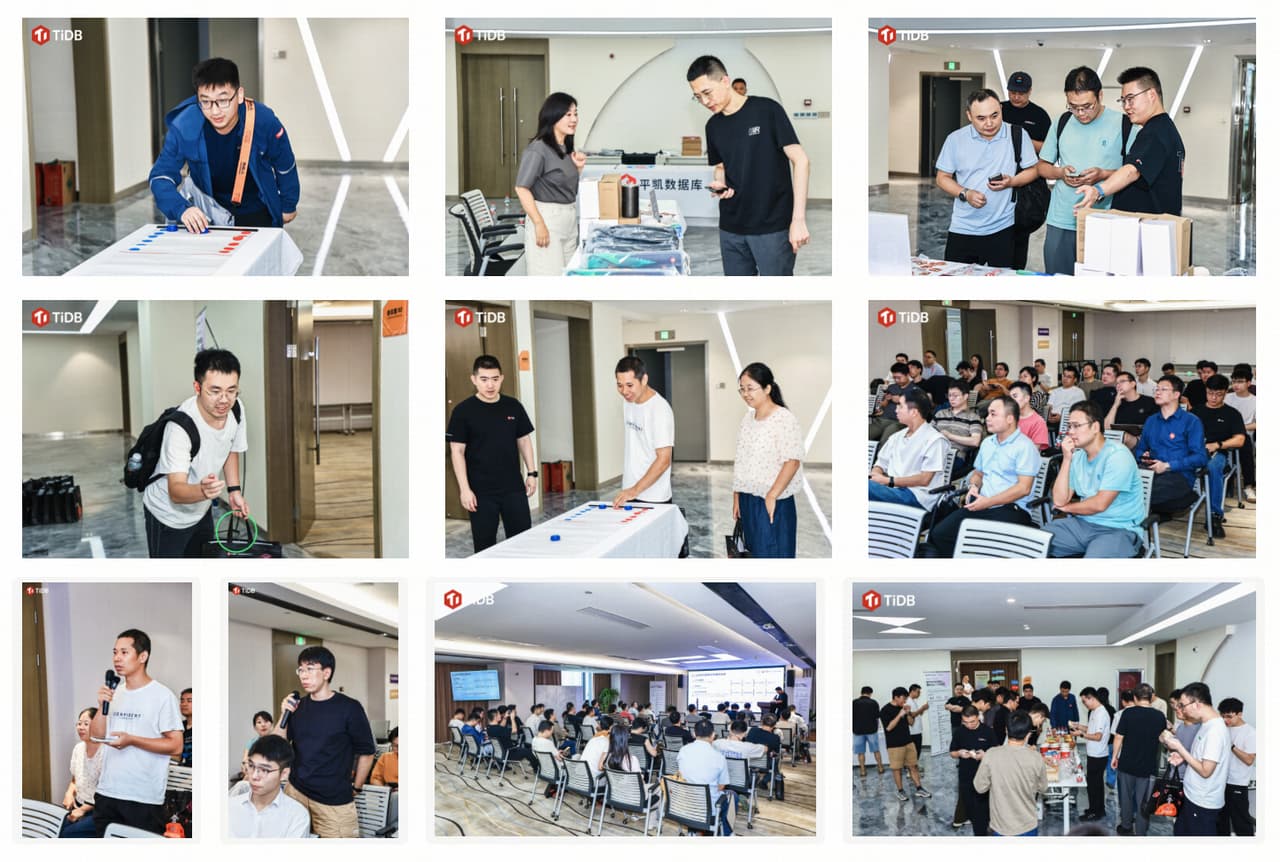
活动花絮
「观后感文章」有奖征集!
一场干货满满的行业实践分享会虽然落幕,但技术交流的余温还在!
无论是数据库行业应用、AI 落地实践的思考,还是个人的参会心得,关于数据库选型、运维收获,都欢迎在社区博客投稿,优质文章即可赢取专属周边(600ml TiDB AI 主题咖啡杯),截止时间:9 月 19 日