一个好的问题描述有利于社区小伙伴更快帮你定位到问题,高效解决你的问题
【TiDB 使用环境】生产环境 /测试环境
【TiDB 版本】
【部署方式】云上部署(什么云)/机器部署
【操作系统/CPU 架构/芯片详情】
【机器部署详情】CPU大小/内存大小/磁盘大小
【集群数据量】
【集群节点数】
【问题复现路径】做过哪些操作出现的问题
【遇到的问题:问题现象及影响】
【资源配置】进入到 TiDB Dashboard -集群信息 (Cluster Info) -主机(Hosts) 截图此页面
【复制黏贴 ERROR 报错的日志】
【其他附件:截图/日志/监控】
我这边有大量的limit查询提示这个
克里克里克
(Ti D Ber H052ej9m)
2
info级别的日志,如果影响不大忽略吧。
另外,可以看看系统里是不是很多limit的语句,是否limit没有下推到TiKV层。
limit语句都是有索引的,程序会发起很多limit sql,但是单条耗时一般在50ms,想着看看能不能调整一下,查询能更快一些
检查索引,尽量让 limit 查询走索引,减少扫描 region 数量;TiKV 负载高、网络差也会加重这个问题。
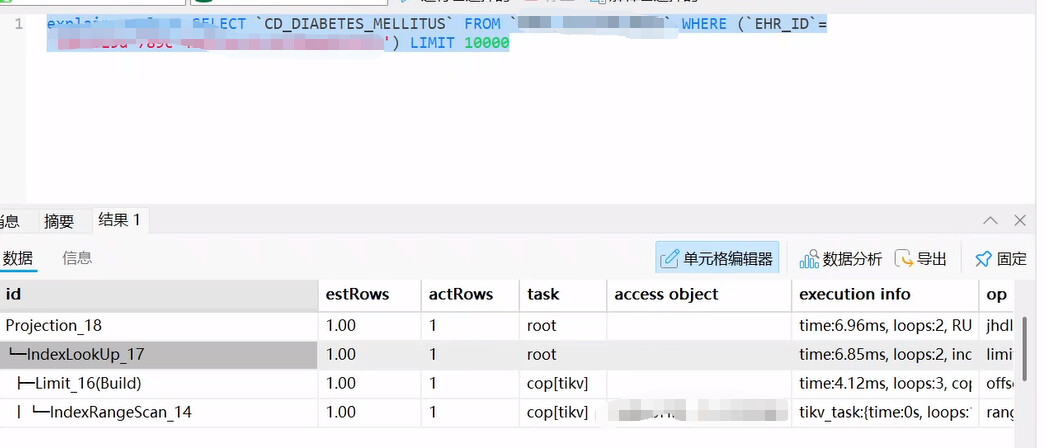
先看执行计划是不是IndexLookUp,是的话limit要把索引扫完再回表。改成覆盖索引、order by对齐索引顺序,走IndexReader才能真把limit下推。
CHENGX
14
我们的业务场景会发起超多的这个limit语句,高峰qps达到了50K,就有这些日志了
WalterWj
(王军 - PingCAP)
15
Loop 分析如下:
您好,关于日志 [INFO] [select.go:565] limit executor close takes a long time,结论如下:
这不是报错,也不代表查询慢。 它是 TiDB 内置的一条诊断日志:一条 SQL 执行结束、释放执行算子链时,如果这一步耗时超过 1 毫秒就会打印一条 INFO。1.5ms、几十毫秒这种量级属于正常抖动——正因为阈值定得很低,它容易刷屏,但对结果正确性和查询响应时间都没有影响。
特别说明一点:您帖子里那条 LIMIT 10000 的查询(执行计划是 IndexLookUp + Limit 下推)本身不会打印这条日志——LIMIT 已经被下推到索引扫描内部,执行计划里没有独立的 Limit 算子,也就走不到这段日志。所以刷屏的日志来自其它带 LIMIT 的语句。这条日志只带耗时、不带 SQL 文本和连接信息,无法直接反查是哪条语句,建议按日志时间戳对齐业务日志或慢日志来定位。
如果诉求只是「不想让日志刷屏」(推荐):把该 TiDB 实例的日志级别调到 warn。注意每台 TiDB 都要执行一次、且实例重启后会恢复:
curl -X POST 'http://<TiDB_IP>:10080/settings' -d 'log_level=warn'
想永久生效,就改 tidb.toml 里的 [log] level = "warn" 再重启实例。
如果真实诉求是「LIMIT 查询提速」:这条日志帮不上忙,提速要看具体语句的真实执行时间与计划。您贴的那条 1 行、约 7ms 的查询已经很快;如果还有其它较慢的 LIMIT 语句,请把语句和执行计划贴出来,我们一起看。
一个例外:如果某条这类日志的耗时到了秒级及以上(几秒、十几秒),那它就不是噪音了,通常意味着上游有真实问题(例如该语句的内存估算偏低导致落盘),可以顺着那个时间点去查真实慢查询。
另外:升级版本不会消除这条日志(阈值一直是 1ms),不必为此升级。