
升级范围:TiDB 从 6.5.12 升级至 TiDB v8.5.2
集群标识:
- 主集群:
tidb-pro- 备集群:
tidb-adr示例信息:文档中所有出现的 IP、端口及目录均为假设,以实际环境为准。
一、升级前置步骤
1.1 variables 参数比对
简单说明:
测试环境输出升级前和升级后的 variables 差异,以便评估升级后如何做 variables 的版本标准化。
标准操作:
测试环境升级前
mysql -hIP -P4000 -uroot -p -e"show variables;" > variables_6.5.12.log
换行复制
测试环境升级后
mysql -hIP -P4000 -uroot -p -e"show variables;" > variables_7.1.8-5.2.log
换行复制
compare_variables_diff.sh 比较从 v6.5.12 升级到 v7.1.8-5.2 后有差异的系统变量
#!/bin/bash

# 文件名
file1="variables_6.5.12.log"
file2="variables_7.1.8-5.2.log"

# 输出文件名
output="compare_variables_result.csv"

# 检查文件是否存在
if [[ ! -f "$file1" || ! -f "$file2" ]]; then
    echo "文件不存在,请检查文件路径。"
    exit 1
fi

# 格式化文件:跳过表头、统一用制表符分隔,然后按变量名排序
awk 'NR>1 { $1=$1; print }' OFS='\t' "$file1" | sort -k1,1 > sorted_A.txt
awk 'NR>1 { $1=$1; print }' OFS='\t' "$file2" | sort -k1,1 > sorted_B.txt

# 输出 CSV 文件标题(所有字段均用双引号包裹)
echo "\"Variable_name\",\"6512_Value\",\"718_Value\",\"type\"" > "$output"

# 处理存在于 6.5.12 中但不存在于 7.1.8-5.2 中的参数(标记为 6512only)
awk 'function csv_quote(str) {
         gsub(/"/, "\"\"", str);
         return "\"" str "\""
     }
BEGIN { FS="\t"; OFS="," }
NR==FNR { b[$1]=$2; next }
{
    if (!($1 in b))
        print csv_quote($1), csv_quote($2), csv_quote(""), csv_quote("6512only")
}' sorted_B.txt sorted_A.txt >> "$output"

# 处理存在于 7.1.8-5.2 中但不存在于 6.5.12 中的参数(标记为 718only)
awk 'function csv_quote(str) {
         gsub(/"/, "\"\"", str);
         return "\"" str "\""
     }
BEGIN { FS="\t"; OFS="," }
NR==FNR { a[$1]=$2; next }
{
    if (!($1 in a))
        print csv_quote($1), csv_quote(""), csv_quote($2), csv_quote("718only")
}' sorted_A.txt sorted_B.txt >> "$output"

# 对比两个文件中共有的参数,若转换后值不一致,则标记为 inconsistent
join -1 1 -2 1 -t $'\t' -o 0,1.2,2.2 sorted_A.txt sorted_B.txt | \
awk -F '\t' 'function csv_quote(str) {
                 gsub(/"/, "\"\"", str);
                 return "\"" str "\""
             }
BEGIN { OFS="," }
{
    valA = tolower($2)
    valB = tolower($3)
    if(valA == "off") { valA = "0" }
    if(valA == "on")  { valA = "1" }
    if(valB == "off") { valB = "0" }
    if(valB == "on")  { valB = "1" }
    if(valA != valB) {
        print csv_quote($1), csv_quote($2), csv_quote($3), csv_quote("inconsistent")
    }
}' >> "$output"

# 删除临时文件
rm -f sorted_A.txt sorted_B.txt

echo "对比结果已保存到 $output"
换行复制
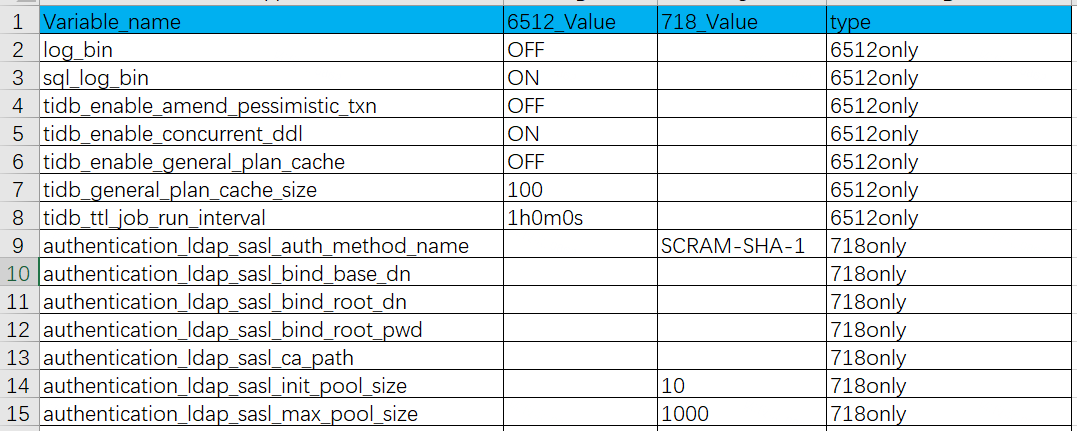
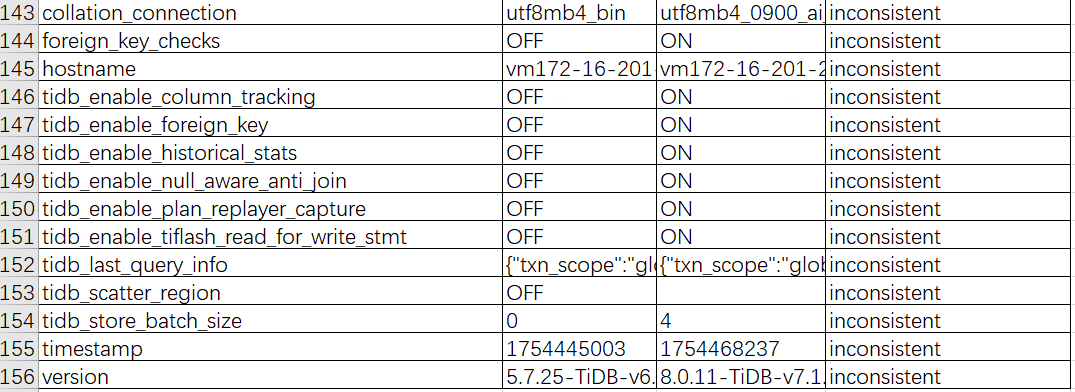
脚本输出后的样式如下(只截取部分),由于升级都是倾向于保守(继承老参数),如希望使用 7.1.8的新特性,可评估开启相关特性的参数。
预览
预览
1.2 集群参数比对
简单说明:
测试环境输出升级前和升级后的 config 差异,以便评估升级后如何做 config 的版本标准化。
标准操作:
测试环境升级前
mysql -hIP -P4000 -uroot -p -e"show config where type='tidb' and instance='IP:4000';" > tidb-config_6.5.12.log
mysql -hIP -P4000 -uroot -p -e"show config where type='tikv' and instance='IP:20260';" > tikv-config_6.5.12.log
mysql -hIP -P4000 -uroot -p -e"show config where type='pd' and instance='IP:2379';" > pd-config_6.5.12.log
换行复制
测试环境升级后
mysql -hIP -P4000 -uroot -p -e"show config where type='tidb' and instance='IP:4000';" > tidb-config_7.1.8-5.2.log
mysql -hIP -P4000 -uroot -p -e"show config where type='tikv' and instance='IP:20260';" > tikv-config_7.1.8-5.2.log
mysql -hIP -P4000 -uroot -p -e"show config where type='pd' and instance='IP:2379';" > pd-config_7.1.8-5.2.log
换行复制
compare_config_diff.sh
#!/bin/bash

# 文件名
file1="pd-config_6.5.12.log"
file2="pd-config_7.1.8-5.2.log"

# 输出文件名
output="compare_config_result.csv"

# 检查文件是否存在
if [[ ! -f "$file1" || ! -f "$file2" ]]; then
    echo "文件不存在,请检查文件路径。"
    exit 1
fi

# 提取关键字段(参数名称和参数值),跳过表头,并排序
awk 'NR>1 {print $3 "\t" $4}' "$file1" | sort -k1,1 > sorted_A.txt
awk 'NR>1 {print $3 "\t" $4}' "$file2" | sort -k1,1 > sorted_B.txt

# 输出 CSV 文件标题,字段都加上引号
echo "\"Variable_name\",\"6512_Value\",\"718_Value\",\"type\"" > "$output"

# 处理存在于 6.5.12 中但不存在于 7.1.8-5.2 中的参数(标记为 6512only)
awk 'BEGIN {
    FS="\t"; OFS=","
}
# CSV转义函数:将双引号替换为两个双引号,并用双引号包裹字段
function csv_quote(str) {
    gsub(/"/, "\"\"", str);
    return "\"" str "\"";
}
NR==FNR { a[$1]=$2; next }
{
    if (!($1 in a))
        print csv_quote($1), csv_quote($2), csv_quote(""), csv_quote("6512only")
}' sorted_B.txt sorted_A.txt >> "$output"

# 处理存在于 7.1.8-5.2 中但不存在于 6.5.12 中的参数(标记为 718only)
awk 'BEGIN {
    FS="\t"; OFS=","
}
function csv_quote(str) {
    gsub(/"/, "\"\"", str);
    return "\"" str "\"";
}
NR==FNR { a[$1]=$2; next }
{
    if (!($1 in a))
        print csv_quote($1), csv_quote(""), csv_quote($2), csv_quote("718only")
}' sorted_A.txt sorted_B.txt >> "$output"

# 对比两个文件中都有的参数,标记值不一致的项 (inconsistent)
join -1 1 -2 1 -t $'\t' sorted_A.txt sorted_B.txt | \
awk -F '\t' 'BEGIN {
    OFS=","
}
function csv_quote(str) {
    gsub(/"/, "\"\"", str);
    return "\"" str "\"";
}
{
    valA = tolower($2)
    valB = tolower($3)
    if (valA != valB)
        print csv_quote($1), csv_quote($2), csv_quote($3), csv_quote("inconsistent")
}' >> "$output"

# 删除临时文件
rm -f sorted_A.txt sorted_B.txt

# 输出结果提示
echo "对比结果已保存到 $output"
换行复制
1.3 应用兼容性
简单说明:
需准备测试环境、准生产环境、或者生产备库,运维人员配合应用人员做回归测试。
标准操作:
无。
1.4 集群巡检
简单说明:
应提前做详细的数据库核心指标巡检,并记录。后续可使用升级前的指标和升级后的指标对比得出升级收益。
标准操作:
集群核心指标巡检 |
|||||
巡检涉及角色 |
巡检指标分类 |
巡检指标名称 |
指标值(升级前) |
指标值(升级后) |
备注 |
主机层Overview |
System Info |
CPU |
50%~75% |
55%~78% |
|
Memory Available |
50GB~80GB |
100GB ~ 110GB |
|||
IO utilization |
24% ~ 62% |
20% ~ 35% |
|||
Network |
|||||
TIDB层 |
Query Summary |
Duration P999 |
|||
QPS |
|||||
Failed Query OPM |
|||||
Server |
Memory Usage |
||||
CPU Usage |
|||||
Connection count |
|||||
Panic and Critial Error |
|||||
PD层 |
Abnormal stores |
Disconnect Stores |
|||
Unhealth Stores |
|||||
LowSpace Stores |
|||||
Down Stores |
|||||
Offline Stores |
|||||
Tombstone Stores |
|||||
Slow Stores |
|||||
Region Healthy |
down-peer-region-count |
||||
miss-peer-region-count |
|||||
pending-peer-region-count |
|||||
offline-peer-region-count |
|||||
Cluster |
CPU Usage |
||||
Memory Usage |
|||||
Operator |
balance-leader |
||||
balance-region |
|||||
transfer-hot-write-leader |
|||||
transfer-hot-read-leader |
|||||
Statistics-balance |
Store available ratio |
||||
TIKV层 |
Cluster |
CPU |
|||
Memory |
|||||
IO utilization |
|||||
MBps Read |
|||||
MBps Write |
|||||
QPS kv_prewrtie |
|||||
QPS kv_get |
|||||
QPS Coprocessor |
|||||
Erros |
Critical error |
||||
Server is busy |
|||||
Server report failures |
|||||
gRPC message error |
|||||
Thread CPU |
Raft store CPU |
||||
Async apply CPU |
|||||
gRPC poll CPU |
|||||
Scheduler worker CPU |
|||||
Unified read pool CPU |
|||||
RocksDB CPU |
|||||
GC Worker CPU |
|||||
BackGround Worker CPU |
|||||
Raft IO |
Append log duration |
||||
Apply Log Duration |
|||||
Commit Log Duration |
|||||
Binlog |
pump |
Write binlog QPS by instance |
|||
Write Binlog latency |
|||||
Pump Storage Error By Type |
|||||
drainer |
Checkpoint TSO |
||||
99% Execute Time |
|||||
99% sql query time |
|||||
node |
Goroutine |
||||
Memory |
|||||
TICDC |
Lag analyze |
Changefeed checkpoint lag |
|||
TiDB query duration |
|||||
Server |
CPU Usage |
||||
Memory Usage |
|||||
DataFlow |
Puller output events/s |
||||
Sorter output events/s |
|||||
Mounter output events/s |
|||||
SinkV2 - Sink flush rows/s |
1.5 patch 补丁检查
简单说明:
确认目标版本包含所有必要的 Bug 修复和新特性。
标准操作:
无。
1.6 业务性能压测
简单说明:
主要确保升级后性能没有回退。
标准操作:
业务侧在测试环境或准生产环境做业务性能压测。
运维侧搭建相关环境集群和配置参数,配合处理业务压测期间遇到的问题,优化SQL等。
1.7 升级时长与窗口评估
简单说明:
评估在线滚动升级对业务的影响,并确定最佳执行时间段。
标准操作:
- 升级需要选择业务低峰,收集监控历史升级过程中的 QPS/延迟波动信息
- 根据组件数量保守的估算总耗时:TiDB ≈1 min/节点,TiKV ≈5 min/节点,PD * 3节点 ≈5 min
- 由上述数据辅助下,运维人员与应用侧沟通升级变更窗口
1.8 DDL 变更与窗口评估
简单说明:
确保升级期间无结构变更干扰,避免不确定风险。
标准操作:
与业务侧确认,升级窗口内禁止 DDL,或提前完成必要的表结构变更。
运维侧集群执行admin show ddl jobs 100;二次确认 DDL 规律,确保升级窗口不会有定时任务等 DDL 操作;
1.9 软件包准备
简单说明:
获取升级目标版本的 TiDB 安装介质,要注意区分是 X86 还是 ARM 的版本,通常需要 server 包和 toolkit 包,并且需要做合包处理。
标准操作:
#解压 server 包和 toolkit 包
tar xvf tidb-ee-server-v7.1.8-5.2-linux-amd64.tar.gz
tar xvf tidb-ee-toolkit-v7.1.8-5.2-linux-amd64.tar.gz
#server、toolkit 的镜像合并,注意路径
cp -r /home/tidb/tidb-ee-server-v7.1.8-5.2-linux-amd64/keys /home/tidb/.tiup
tiup mirror merge /home/tidb/tidb-ee-toolkit-v7.1.8-5.2-linux-amd64
换行复制
1.10 备份
简单说明:
数据与配置备份,确保手上有集群所有信息的备份,才能实施升级。
标准操作:
数据库一般有日常全备份或PITR增备,也可能有备库。
除数据库备份外的备份清单
序号 |
备份内容 |
1 |
系统参数(variables) |
2 |
组件配置(config) |
3 |
SPM (global bindings) |
4 |
序列 (sequence) |
5 |
视图 (views) |
6 |
用户权限备份 |
7 |
meta.yaml |
8 |
组件版本信息 |
9 |
PD ctl 配置信息 |
10 |
client host 信息 |
参考脚本(不含数据库备份)
#!/bin/bash


CLUSTER_NAME="$1"

# 颜色变量
GREEN='\033[32m'; RED='\033[31m'; YELLOW='\033[33m'; NC='\033[0m'

#############################################
# 用户可修改的配置块
#############################################
# 备份目录
BACKUP_DIR="/home/tidb/${CLUSTER_NAME}"

# 数据库连接(留空则自动填充)
DB_HOST=""
DB_PORT=""
DB_USER="xxx"
DB_PASSWORD="xxx"

# 版本相关
OLD_VERSION=""  # 留空则自动从 tiup 获取
TIMESTAMP=$(date +%Y%m%d%H%M%S)

#############################################
#  DB_HOST 或 DB_PORT 自动化填充
#############################################
# 如果 DB_HOST 或 DB_PORT 为空,则尝试通过 tiup 获取
if [[ -z "$DB_HOST" || -z "$DB_PORT" ]]; then
    echo "未在配置信息中找到 DB_HOST 或 DB_PORT,尝试通过 'tiup cluster display $CLUSTER_NAME' 获取..."

    # 获取第一个状态为 Up 的 TiDB 节点信息
    TIDB_NODE=$(tiup cluster display "$CLUSTER_NAME" 2>/dev/null | \
                awk '($2=="tidb" || $2=="ubisql") && ($6~/^Up/ || $7~/^Up/) {split($1,a,":"); print a[1] ":" a[2]}' | \
                head -n 1)

    if [[ -n "$TIDB_NODE" ]]; then
        if [[ -z "$DB_HOST" ]]; then
            DB_HOST=$(echo "$TIDB_NODE" | cut -d':' -f1)
        fi
        if [[ -z "$DB_PORT" ]]; then
            DB_PORT=$(echo "$TIDB_NODE" | cut -d':' -f2)
        fi
        echo "自动获取到 DB_HOST=$DB_HOST, DB_PORT=$DB_PORT"
    else
        echo "未能通过 tiup 命令获取到 TiDB 节点信息,请检查集群状态或填写数据库连接信息。"
        exit 1
    fi
fi

#############################################
# OLD_VERSION 自动化填充
#############################################
if [[ -z "$OLD_VERSION" ]]; then
    echo "未在配置信息中找到 OLD_VERSION,尝试通过 'tiup cluster display $CLUSTER_NAME' 获取集群版本..."

    # 获取包含 "Cluster version" 关键字的行
    CLUSTER_VERSION_OUTPUT=$(tiup cluster display "$CLUSTER_NAME" 2>/dev/null | grep -i "Cluster version")

    if [[ -n "$CLUSTER_VERSION_OUTPUT" ]]; then
        # 提取版本号:忽略前面的 'v' 字符,取形如 X.Y.Z 的版本号
        OLD_VERSION=$(echo "$CLUSTER_VERSION_OUTPUT" | sed -E 's/.*v([0-9]+\.[0-9]+\.[0-9]+).*/\1/')
        echo "自动获取到 OLD_VERSION=$OLD_VERSION"
    else
        echo "未能通过 tiup 命令获取到集群版本信息,请检查集群状态或手动填写 OLD_VERSION。"
        exit 1
    fi
fi

#############################################
# 通用工具函数
#############################################

# 统一的 MySQL 操作函数
run_mysql() {
    local sql="$1"
    mysql -h "$DB_HOST" -P "$DB_PORT" -u "$DB_USER" -p"$DB_PASSWORD" -se "$sql"
}

# 输出检查通过信息(绿色)
print_ok() {
    echo -e "${GREEN}检查 OK: $1${NC}"
}

# 输出检查错误信息(红色)
print_error() {
    echo -e "${RED}检查 ERROR: $1${NC}"
}

#############################################
# 辅助函数:打印段落标题和分隔线(ASCII 边框版)
#############################################
#带序号的格式
print_section_header() {
    local title="$1"
    local separator="----------------------------------------------------------------------"
    echo "$separator"
    echo "-- 检查${CHECK_COUNTER}:${title}"
    echo "$separator"
    CHECK_COUNTER=$((CHECK_COUNTER + 1))
}

#不带序号的格式
print_section_header_nonum() {
    local title="$1"
    local separator="----------------------------------------------------------------------"
    echo "$separator"
    echo "-- $title"
    echo "$separator"
}


# 打印集群名称 Banner
BANNER_BORDER="========================================"
echo -e "\n${YELLOW}${BANNER_BORDER}"
echo -e "当前操作集群: ${CLUSTER_NAME}"
echo -e "${BANNER_BORDER}${NC}\n"


#############################################
# 备份系统变量和各组件配置文件
#############################################
get_random_instance() {
    # 获取指定类型组件的随机实例,返回实例信息
    local type="$1"
    local instance
    instance=$(run_mysql "SELECT INSTANCE FROM INFORMATION_SCHEMA.CLUSTER_INFO WHERE TYPE='${type}' LIMIT 1;" 2>/dev/null)
    echo "$instance"
}


backup_system_variables_and_config() {
    print_section_header "备份系统变量和各组件配置文件"
    # 确保备份目录存在
    mkdir -p "$BACKUP_DIR"

    echo "正在备份全局系统变量..."
    run_mysql "SHOW VARIABLES;" > "$BACKUP_DIR/variables_${OLD_VERSION}.log" 2>/dev/null
    print_ok "全局系统变量备份完成"

    # 获取各组件的随机实例,用于备份各自配置
    local tidb_instance pd_instance tikv_instance tiflash_instance
    tidb_instance=$(get_random_instance "tidb")
    pd_instance=$(get_random_instance "pd")
    tikv_instance=$(get_random_instance "tikv")
    tiflash_instance=$(get_random_instance "tiflash")

    echo "正在备份 TiDB 配置..."
    run_mysql "SHOW CONFIG WHERE type='tidb' AND instance='${tidb_instance}';" > "$BACKUP_DIR/tidb-config_${OLD_VERSION}.log" 2>/dev/null
    print_ok "TiDB 配置备份完成"

    echo "正在备份 TiKV 配置..."
    run_mysql "SHOW CONFIG WHERE type='tikv' AND instance='${tikv_instance}';" > "$BACKUP_DIR/tikv-config_${OLD_VERSION}.log" 2>/dev/null
    print_ok "TiKV 配置备份完成"

    echo "正在备份 PD 配置..."
    run_mysql "SHOW CONFIG WHERE type='pd' AND instance='${pd_instance}';" > "$BACKUP_DIR/pd-config_${OLD_VERSION}.log" 2>/dev/null
    print_ok "PD 配置备份完成"

    echo "正在备份 TiFlash 配置..."
    run_mysql "SHOW CONFIG WHERE type='tiflash' AND instance='${tiflash_instance}';" > "$BACKUP_DIR/tiflash-config_${OLD_VERSION}.log" 2>/dev/null
    print_ok "TiFlash 配置备份完成"

    echo "正在备份 TiUP 集群配置..."
    tiup cluster show-config "$CLUSTER_NAME" > "$BACKUP_DIR/${CLUSTER_NAME}_${TIMESTAMP}.yaml" 2>/dev/null
    print_ok "TiUP 集群配置备份完成"
}


#############################################
# 备份 SPM(global bindings)
#############################################
backup_global_bindings() {
    print_section_header "备份 SPM(global bindings)"
    echo "正在备份 global bindings 配置..."
    run_mysql "SHOW GLOBAL BINDINGS;" > "$BACKUP_DIR/global_bindings_${TIMESTAMP}.log" 2>/dev/null
    print_ok "global bindings 配置备份完成"
}


#############################################
# 备份 sequence
#############################################
backup_sequence() {
    print_section_header "备份 sequence"
    echo "正在备份 sequence..."
    run_mysql "SELECT CONCAT(
      'CREATE SEQUENCE ',
      SEQUENCE_SCHEMA,
      '.',
      SEQUENCE_NAME,
      ' start with xxxxx ',
      ' minvalue ',
      MIN_VALUE,
      ' maxvalue ',
      MAX_VALUE,
      ' increment by ',
      INCREMENT,
      CASE cache WHEN 1 THEN ' cache ' WHEN 0 THEN ' nocache ' ELSE '' END,
      CASE cache WHEN 1 THEN CAST(CACHE_VALUE AS CHAR) WHEN 0 THEN '' ELSE '' END,
      CASE cycle WHEN 1 THEN ' cycle ' WHEN 0 THEN ' nocycle ' END,
      ' ;'
    ) AS create_SQL,
    CONCAT('select nextval(', SEQUENCE_SCHEMA, '.', SEQUENCE_NAME, ');') AS nextval_SQL
    FROM information_schema.sequences;" > "$BACKUP_DIR/sequence_${TIMESTAMP}.sql" 2>/dev/null
    print_ok "sequence 备份完成"
}


#############################################
# 备份 views
#############################################
backup_views() {
    print_section_header "备份 views"
    echo "正在备份 views..."
    run_mysql "SELECT CONCAT('CREATE OR REPLACE VIEW ', TABLE_SCHEMA, '.', TABLE_NAME, ' AS ', VIEW_DEFINITION, ';') FROM information_schema.views WHERE TABLE_SCHEMA NOT IN ('mysql','information_schema','performance_schema');" 2>/dev/null | sed 's/\\n/\n/g' > "$BACKUP_DIR/views_${TIMESTAMP}.sql"
    print_ok "views 备份完成"
}


#############################################
# 备份用户和权限
#############################################
createuser() {
    # 输出创建用户的 SQL 语句
    echo "-- USER EXPORT CREATE"
    run_mysql "SELECT CONCAT('CREATE USER ', user, '@\'', host, '\' IDENTIFIED BY PASSWORD \'', authentication_string, '\';') FROM mysql.user WHERE user <> 'root';" 2>/dev/null
    echo "FLUSH PRIVILEGES;"
}

expgrants() {
    # 输出各用户权限的 SQL 语句
    run_mysql "SELECT CONCAT('SHOW GRANTS FOR \'', user, '\'@\'', host, '\';') FROM mysql.user WHERE user <> 'root';" 2>/dev/null | \
    while IFS= read -r query; do
         run_mysql "$query"
    done | sed 's/\(GRANT .*\)/\1;/; s/^\(Grants for .*\)/-- \1 /;'
}

backup_users_and_permissions() {
    print_section_header "备份用户和权限"
    echo "正在备份 users 和权限..."
    # 将创建用户及其权限导出到文件中
    local backup_output
    backup_output=$( { createuser; expgrants; } )
    echo "$backup_output" > "$BACKUP_DIR/grants_${TIMESTAMP}.sql"
    print_ok "users 和权限备份完成"
}


#############################################
# 备份集群核心 variables
#############################################
backup_cluster_core_variables() {
    print_section_header "备份集群核心 variables"
    echo "正在备份集群核心 variables..."
    run_mysql "SHOW VARIABLES WHERE variable_name IN (
      'sql_mode','tidb_ddl_enable_fast_reorg','tidb_max_auto_analyze_time','tidb_opt_fix_control',
      'tidb_enable_prepared_plan_cache','tidb_enable_metadata_lock','tidb_enable_paging','tidb_partition_prune_mode',
      'tidb_stats_load_pseudo_timeout','tidb_opt_range_max_size','sql_require_primary_key','tidb_analyze_version',
      'tidb_cost_model_version','tidb_enable_outer_join_reorder','tidb_mem_quota_query','tidb_enable_telemetry',
      'tidb_enable_rate_limit_action','tidb_enable_analyze_snapshot','tidb_enable_clustered_index',
      'tidb_enable_pseudo_for_outdated_stats','tidb_enable_top_sql','tidb_enable_gogc_tuner'
    );" > "$BACKUP_DIR/cluster_core_variables_${TIMESTAMP}.log" 2>/dev/null
    print_ok "集群核心 variables 备份完成"
}


#############################################
# 备份老版本meta.yaml文件
#############################################
backup_old_meta_yaml() {
    print_section_header "备份老版本 meta.yaml 文件"
    echo "正在备份老版本 meta.yaml 文件..."

    # 从 tiup cluster list 提取第四列作为 meta.yaml 所在目录
    CLUSTER_META_DIR=$(tiup cluster list | grep "$CLUSTER_NAME" | awk '{print $4}')

    # 检查是否获取到目录
    if [ -z "$CLUSTER_META_DIR" ]; then
        print_error "未能从 tiup cluster list 获取到 meta.yaml 所在目录"
        return 1
    fi

    META_FILE="$CLUSTER_META_DIR/meta.yaml"

    if [ -f "$META_FILE" ]; then
        cp "$META_FILE" "$BACKUP_DIR/meta_${TIMESTAMP}.yaml"
        print_ok "老版本 meta.yaml 文件备份完成"
    else
        print_error "老版本 meta.yaml 文件不存在"
    fi
}


#############################################
# 备份组件版本信息
#############################################
backup_cluster_info() {
    print_section_header "备份组件版本信息"
    echo "正在备份组件版本信息..."
    run_mysql "SELECT type, version, git_hash FROM INFORMATION_SCHEMA.CLUSTER_INFO;" > "$BACKUP_DIR/cluster_info_${TIMESTAMP}.log" 2>/dev/null
    print_ok "组件版本信息备份完成"
}


#############################################
# 备份客户端连接来源(按 IP 分组统计)
#############################################
backup_client_connections() {
    # 备份 应用连接来源
    print_section_header "备份多维度连接来源"
    echo "正在备份应用连接来源信息…"
    run_mysql "
      SELECT
        SUBSTRING_INDEX(HOST, ':', 1) AS ip,
        COUNT(*) AS conn_count
      FROM
        information_schema.cluster_processlist
      GROUP BY
        ip;
    " > "${BACKUP_DIR}/client_connections_ip_${TIMESTAMP}.log" 2>/dev/null
    print_ok "应用连接来源信息备份完成"

    # 备份 数据库维度连接数
    echo "正在备份数据库维度连接数信息…"
    run_mysql "
      SELECT
        IFNULL(DB, 'NULL') AS db_name,
        COUNT(*) AS conn_count
      FROM
        information_schema.cluster_processlist
      GROUP BY
        db_name;
    " > "${BACKUP_DIR}/client_connections_db_${TIMESTAMP}.log" 2>/dev/null
    print_ok "数据库维度连接数备份完成"

    # 备份 用户维度连接数
    echo "正在备份用户维度连接数信息…"
    run_mysql "
      SELECT
        USER AS user_name,
        COUNT(*) AS conn_count
      FROM
        information_schema.cluster_processlist
      GROUP BY
        user_name;
    " > "${BACKUP_DIR}/client_connections_user_${TIMESTAMP}.log" 2>/dev/null
    print_ok "用户维度连接数备份完成"
}


backup_system_variables_and_config
backup_global_bindings
backup_sequence
backup_views
backup_users_and_permissions
backup_cluster_core_variables
backup_old_meta_yaml
backup_cluster_info
backup_client_connections
echo -e "\n\n"
echo -e "\n\n"
echo -e "${GREEN}所有备份任务完成,路径在 $BACKUP_DIR${NC}"
换行复制
二、升级变更期间操作步骤(原地升级)
2.1 屏蔽告警
简单说明:
按和业务沟通的变更窗口时间,屏蔽告警。按需屏蔽,不限于 TiDB 集群的告警。
标准操作:
无
2.2 按版本最佳实践调整 config 参数
简单说明:
按版本最佳实践微调整 config 参数。
标准操作:
按需,通常只操作部分关注的核心 config 参数:
删减高版本已废弃的参数条目,调整已有参数为最佳实践值,新增高版本特有的参数和最佳实践值。
tiup cluster edit-config <cluster-name>
换行复制
2.3 本地升级 ONLINE
简单说明:
命令 tiup cluster upgrade 用于将指定集群升级到特定版本。
tiup cluster upgrade 重要的参数:
参数 |
含义 |
--force |
强制替换二进制并启动(忽略集群未启动或升级过程中的错误) |
--transfer-timeout <秒> |
等待 leader 迁移最长时间(秒),超时后跳过迁移直接升级(默认600) |
--wait-timeout <秒> |
等待操作完成的超时时间(秒),对于不适用此超时的操作将被忽略。(默认120) |
--pre-upgrade-script <脚本> |
在升级前于各节点本地执行指定脚本(实验特性,tiup v1.16.2 GA) |
--post-upgrade-script <脚本> |
在升级后于已完成升级的节点本地执行指定脚本(实验特性,tiup v1.16.2 GA) |
--offline |
集群离线升级 |
-h, --help |
查看帮助 |
标准操作:
tiup cluster upgrade <cluster_name> v7.1.8-5.2 --transfer-timeout 3600 --wait-timeout 3600
换行复制
2.4 检查 TiDB QPS 与 P99 延迟、PD Leader 分布等
简单说明:
登陆 grafana,检查对应的监控面板。
标准操作:
补图
2.5 核对版本信息
简单说明:
核对版本信息,如组件出现两种 version,说明升级有问题。如组件是 patch 版本,git_hash 要与 patch 的 git_hash 匹配,说明 patch 正确。
标准操作:
mysql> SELECT DISTINCT type, version, git_hash FROM INFORMATION_SCHEMA.CLUSTER_INFO;
+------+-----------+------------------------------------------+
| type | version   | git_hash                                 |
+------+-----------+------------------------------------------+
| pd   | 7.1.8-5.2 | 4cd009c4db3c15215341a96521dd53e53c55e5bd |
| tikv | 7.1.8-5.2 | 5ef13702596622793bf719d098383d711b184d46 |
| tidb | 7.1.8-5.2 | 2f6202bc86944b33d139403d5e65cb10de12540e |
+------+-----------+------------------------------------------+
3 rows in set (0.01 sec)
换行复制
2.6 按版本最佳实践调整 variables
简单说明:
按版本最佳实践微调整 variables 参数。
标准操作:
在升级完成后,第一时间调整 variables。
#按需,以下只是语法 demo
set global tidb_mem_quota_query=1073741824;
换行复制
2.7 人工检查,最重点的是日志信息有误异常、grafana 监控的 Failed Query OPM 等指标
简单说明:
登陆 dashboard ,检查对应的面板。
标准操作:
补图
三、升级变更期间操作步骤(迁移升级)
预览
3.1 前期准备:
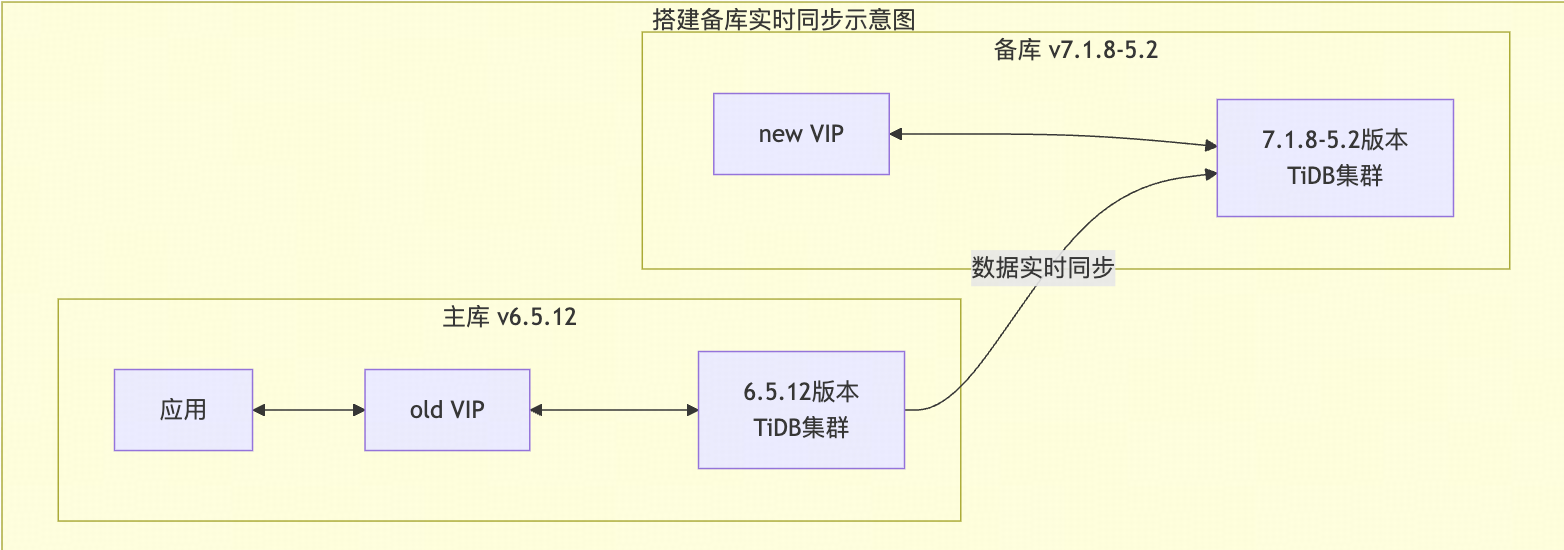
迁移升级,需要搭建备库,备库刷版本最佳实践参数,BR备份恢复到备集群后,扩容 cdc ,配置 cdc 实时同步。
BR备份恢复
备份参考命令
./br backup full \
--pd "127.0.0.1:2379" \
-s "local:///backup/tidb/full" \
--log-file /backup/brfull.log \
--ratelimit 128
换行复制
恢复参考命令
./br restore full \
--pd "127.0.0.1:2379" \
-s "local:///backup/tidb/full" \
--log-file /backup/brestore.log \
--ratelimit 128
换行复制
扩容 ticdc 组件
vim scale-out-cdc.yaml
cdc_servers:
- host: 172.16.201.1
  ssh_port: 22
  port: 8300
  gc-ttl: 86400
  deploy_dir: /data/tidb-deploy/cdc-8300
  data_dir: /data/tidb-data/cdc-8300
  log_dir: /data/tidb-deploy/cdc-8300
  arch: amd64
  os: linux
- host: 172.16.201.2
  ssh_port: 22
  port: 8300
  gc-ttl: 86400
  deploy_dir: /data/tidb-deploy/cdc-8300
  data_dir: /data/tidb-data/cdc-8300
  log_dir: /data/tidb-deploy/cdc-8300
  arch: amd64
  os: linux
- host: 172.16.201.3
  ssh_port: 22
  port: 8300
  gc-ttl: 86400
  deploy_dir: /data/tidb-deploy/cdc-8300
  data_dir: /data/tidb-data/cdc-8300
  log_dir: /data/tidb-deploy/cdc-8300
  arch: amd64
  os: linux
换行复制
扩容命令
tiup cluster scale-out tidb-pro ./scale-out-cdc.yaml
换行复制
配置cdc 实时同步
vim changefeed_tidb1_to_tidb2.toml
#配置要同步的库 aaa
[filter]
rules = ["aaa.*"]
换行复制
启动 changefeed 任务
tiup cdc cli changefeed create \
--server="http://172.16.201.1:8300" \
--sink-uri="mysql://同步用户:密码@IP地址:端口?worker-count=64&tidb-txn-mode=pessimistic&write-timeout=30m&time-zone=" \
--changefeed-id="changefeed-tidb1-to-tidb2" \
--start-ts=开始同步的tso \
--config=/<dir>/changefeed_tidb1_to_tidb2.toml
换行复制
3.2 屏蔽告警
简单说明:
按和业务沟通的变更窗口时间,屏蔽告警。按需屏蔽,不限于 TiDB 集群的告警。
标准操作:
无。
3.3 停止应用并将VIP指向 TiDB
简单说明:
停止应用并修改连接串指向新的 TiDB 集群。
F5地址:xxx
域名:xxx
端口:4000
标准操作:
无。
3.4 主备环境数据一致性校验
简单说明:
主备库是异步同步的方式,在切换前应当做一次去全量比数。
标准操作:
业务侧有能力做一致性校验的,由业务侧做,运维侧 count(*) 比对数据辅助。
运维侧也可使用 sync_diff_inspector 比数工具:
vim sync_diff_inspector.toml
# Diff Configuration.

######################### Global config #########################

# 检查数据的线程数量,上下游数据库的连接数会略大于该值
check-thread-count = 4

# 如果开启,若表存在不一致,则输出用于修复的 SQL 语句。
export-fix-sql = true

# 只对比表结构而不对比数据
check-struct-only = false


######################### Datasource config #########################
[data-sources]
[data-sources.tidb1] # mysql1 是该数据库实例唯一标识的自定义 id,用于下面 task.source-instances/task.target-instance 中
    host = "172.16.201.1"
    port = 4000
    user = "root"
    password = "tidb"


[data-sources.tidb2]
    host = "172.16.201.2"
    port = 4001
    user = "root"
    password = "tidb"
    #(可选)使用 TiDB 的 snapshot 功能,如果开启的话会使用历史数据进行对比
    # snapshot = "386902609362944000"


######################### Task config #########################
# 配置需要对比的*目标数据库*中的表
[task]
    # output-dir 会保存如下信息
    # 1 sql: 检查出错误后生成的修复 SQL 文件,并且一个 chunk 对应一个文件
    # 2 log: sync-diff.log 保存日志信息
    # 3 summary: summary.txt 保存总结
    # 4 checkpoint: a dir 保存断点续传信息
    output-dir = "./outputdir"

    # 上游数据库,内容是 data-sources 声明的唯一标识 id
    source-instances = ["tidb1"]

    # 下游数据库,内容是 data-sources 声明的唯一标识 id
    target-instance = "tidb2"

    # 需要比对的下游数据库的表,每个表需要包含数据库名和表名,两者由 `.` 隔开
    # 使用 ? 来匹配任意一个字符;使用 * 来匹配任意;详细匹配规则参考 golang regexp pkg: https://github.com/google/re2/wiki/Syntax
    target-check-tables = ["sbtest.*"]
换行复制
运行比数工具, 比对日志打印在outputdir/sync_diff.log,有差异会打印在outputdir/summary.txt
nohup ./sync_diff_inspector --config=./sync_diff_inspector.toml &
换行复制
3.5 启动应用
简单说明:
应用侧人员启动应用。
标准操作:
无。
3.6 核心业务验证 & 集群监控
简单说明:
应用侧与运维侧人员共同监控业务运行状态。
标准操作:
补运维侧的图
3.7 部署反向数据同步
备库扩容 ticdc 组件
vim scale-out-cdc.yaml
cdc_servers:
- host: 172.16.201.11
  ssh_port: 22
  port: 8300
  gc-ttl: 86400
  deploy_dir: /data/tidb-deploy/cdc-8300
  data_dir: /data/tidb-data/cdc-8300
  log_dir: /data/tidb-deploy/cdc-8300
  arch: amd64
  os: linux
- host: 172.16.201.12
  ssh_port: 22
  port: 8300
  gc-ttl: 86400
  deploy_dir: /data/tidb-deploy/cdc-8300
  data_dir: /data/tidb-data/cdc-8300
  log_dir: /data/tidb-deploy/cdc-8300
  arch: amd64
  os: linux
- host: 172.16.201.13
  ssh_port: 22
  port: 8300
  gc-ttl: 86400
  deploy_dir: /data/tidb-deploy/cdc-8300
  data_dir: /data/tidb-data/cdc-8300
  log_dir: /data/tidb-deploy/cdc-8300
  arch: amd64
  os: linux
换行复制
扩容命令
tiup cluster scale-out tidb-adr ./scale-out-cdc.yaml
换行复制
配置 cdc 实时同步
vim changefeed_tidb2_to_tidb1.toml
#配置要同步的库 aaa
[filter]
rules = ["aaa.*"]
换行复制
启动 changefeed 任务
tiup cdc cli changefeed create \
--server="http://172.16.201.11:8300" \
--sink-uri="mysql://同步用户:密码@IP地址:端口?worker-count=64&tidb-txn-mode=pessimistic&write-timeout=30m&time-zone=" \
--changefeed-id="changefeed-tidb2-to-tidb1" \
--start-ts=开始同步的tso \
--config=/<dir>/changefeed_tidb2_to_tidb1.toml
换行复制
3.8 回退到旧版本(如需)
简单说明
在切换后遇到非预期导致的业务阻塞,或者性能严重回退,需马上回退。
标准操作
- 停应用
预计停机时间约 10 分钟。
- 断开主备同步链路(反向链路)
确认最后一批 cdc 数据同步完成:
通过 grafana 监控面板确认 cdc 同步无延迟,断开 cdc 同步链路:
tiup cluster display cluster-name -R drainer
#暂停后,再按需执行缩容操作
tiup cluster stop cluster-name -N xx.xx.xx.xx:8249
tiup cluster scale-in cluster-name -N xx.xx.xx.xx:8249
tiup cluster prune cluster-name
换行复制
- 应用切到主集群(原集群)
- 业务人员验证并启动应用