
近日,平凯星辰携手华东师范大学团队、中国人民大学团队分别合作完成的两篇论文正式入选国际数据库与数据管理领域顶级学术会议 VLDB 2026。
两项研究成果紧扣现代数据库在复杂业务场景下的核心痛点,分别从“离线查询规划”与“HTAP 混合负载下的存储布局”两个方面提升数据库的真实表现。其中,OBELISK 创新性地提出一种基于贝叶斯优化与大模型语义推理的免训练离线查询规划框架;Jasper 则提出面向 HTAP 系统的联合自适应存储优化机制。
01 OBELISK:给优化器装上代价缩放旋钮,离线查询优化新范式
论文标题:《OBELISK: Efficient Offline Query Planning with Bayesian Optimization-Informed Language Model Reasoning》
下载链接:https://www.vldb.org/pvldb/vol19/p1674-pan.pdf
背景与挑战
基于代价的查询优化器(CBO)依据基数估计与代价模型遴选“估算代价最低”的执行计划,但在复杂查询、多表连接等场景下,易产生估计偏差,造成查询性能回退问题。现代数据库通常引入 SQL 计划管理(SPM)机制,通过复用已验证的高质量计划来缓解这一问题,但该机制本身不具备“优中选优”能力。
现有的离线查询优化思路存在一定局限性:学习型查询优化器作为黑盒模型缺乏可解释性且难以部署;早期的离线框架(如 BayesQO)在潜空间内搜索,过程不透明且难以跨系统泛化;而基于提示(Hint)的传统干预手段粒度较粗(如全局禁用某种连接),破坏了搜索空间的多样性。在此背景下,本研究提出了 OBELISK。
创新与成果
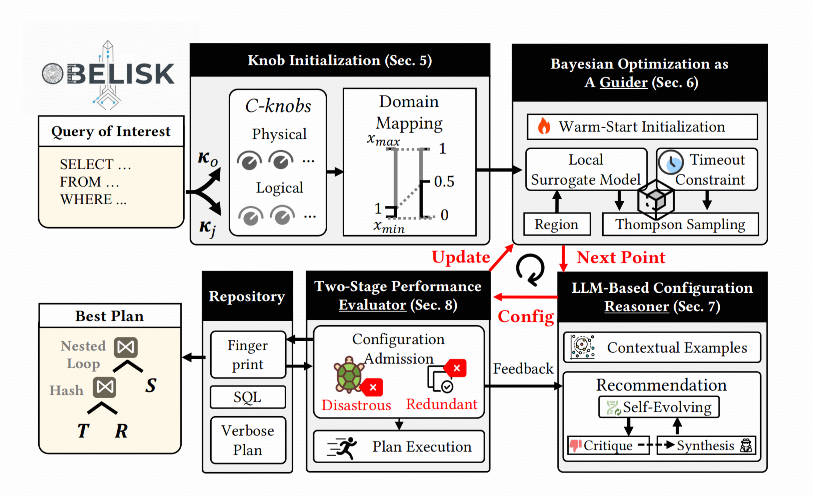
OBELISK 是一种免训练的离线查询规划框架。该框架创新性地引入了“代价缩放旋钮(C-knob)”,并将带约束贝叶斯优化与大模型语义推理深度结合,用白盒化的细粒度干预代替了黑盒潜空间搜索。
针对特定查询,框架在完成旋钮初始化后,以带超时约束的贝叶斯引导器(Guider)识别高质量的配置子空间;以基于 LLM 的自进化推理器(Reasoner)做语义层面的智能推荐与纠错;以双阶段性能评估器(Evaluator)做低成本的安全执行过滤。三大组件紧密协同,逐轮执行“引导—推理—评估”闭环。
该闭环持续迭代,直至满足终止条件。最终脱颖而出的最优执行计划,将被更新至计划基准中,供线上生产环境复用。这一机制有助于破解查询性能回退难题,用统计搜索与语义推理的双轮驱动,让离线查询优化更稳、更强、更可信。
核心技术解析
- 代价缩放旋钮(C-knob)
C-knob 是 OBELISK 的核心技术创新之一。与传统基于 Hint 的“一刀切”硬性约束不同,C-knob 提供的是一种连续的代价缩放机制,只对算子进行“偏置”而非“禁止”,从而允许优化器在局部子计划中依然保留最优选择。C-knob 包含物理和逻辑两类旋钮:物理旋钮可以调整特定物理算子的预估代价,而逻辑旋钮则专门用于影响多表连接顺序的评估。为了有效压缩庞大的搜索空间,系统会在优化器枚举算子和连接顺序时进行底层插桩,自动识别出与当前查询真正相关的旋钮,并剔除掉无关的维度。例如,在处理单表查询时,系统会自动判定所有表连接相关的物理旋钮为无关项,从而将它们排除在搜索范围之外。
- 带超时约束的贝叶斯优化(TCBO)
TCBO 借鉴了信任区域(Trust Region)贝叶斯优化算法,用一组局部代理模型来刻画旋钮配置与查询性能之间的响应面,将搜索重心放在最有可能提升性能的参数组合上。与此同时,它额外训练了一个高斯概率分类器,用来显式地预测“该配置是否会触发执行超时”的风险。在默认的风险阈值(δ=0.05)限制下,模型在推荐下一步采样点时,能够主动绕开可能让查询长时间挂起的配置。
- 基于 LLM 的自进化配置推理器
大模型自进化推理器可根据贝叶斯优化器给出的高潜力搜索方向,检索出多样化的历史执行记录作为上下文示例,进而利用大语言模型生成旋钮配置。如果推荐的配置被评估器拦截,系统会将失败反馈给模型,启动“批判—合成”自进化循环。在这个循环中,模型会分析配置被拒的原因,并调整推荐策略;若大模型连续生成无效配置,分层回退策略也可保障系统不中断。
- 两阶段性能评估器
评估器采用“两步走”策略。第一阶段是轻量的低成本准入控制:对于模型推荐的配置,系统首先通过计划指纹(Fingerprint)过滤掉完全重复的配置。对于未见过的新计划,则从计划库中检索最相似的历史子计划,并结合当前的预估行数,推算出一个保守的执行延迟上限。如果这个预期延迟表现极差(超过阈值),系统就会提前拦截该配置,不做真实的执行。通过准入的配置才进入第二阶段:在带超时保护的前提下于数据库中进行真实测试,并将结果回流,更新贝叶斯模型,形成闭环反馈。
实验数据
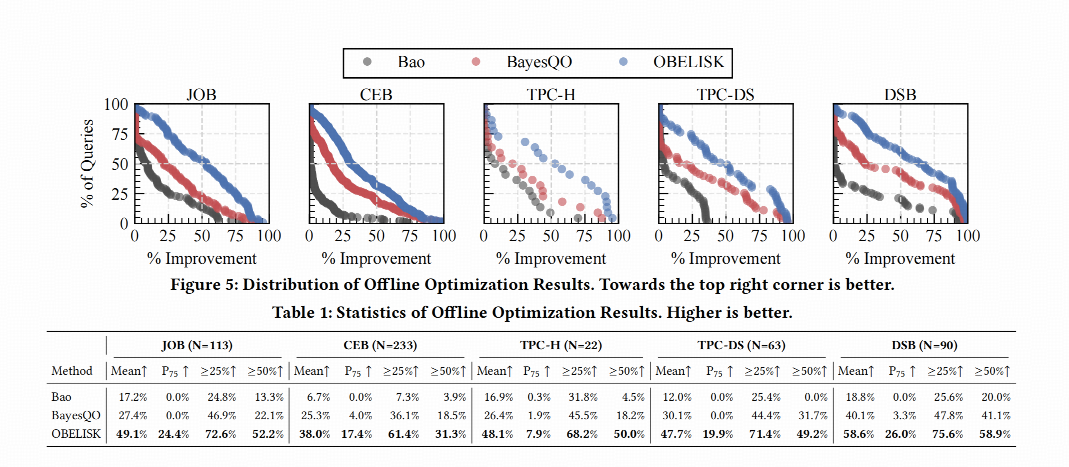
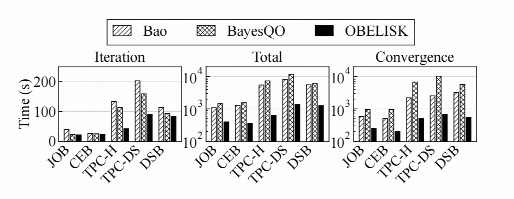
- 优化效果显著:在五个标准基准上,OBELISK 的平均执行时间改进率分别为 JOB 49.1%、CEB 38.0%、TPC-H 48.1%、TPC-DS 47.7%、DSB 58.6%。在最复杂的 DSB 负载上,58.9% 的查询获得超过 50% 的性能提升。这表明负载越复杂、优化器越易产生错误选择时,OBELISK 所能挖掘的收益空间越大。
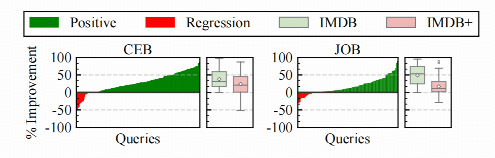
- 数据漂移稳健性:将 IMDB 数据扩增至 IMDB+(7.53GB→19.80GB)模拟数据漂移后,OBELISK 基于旧数据得到的计划,在 CEB 与 JOB 上仍分别有 92.3% 和 85.8% 的查询优于优化器当场生成的新计划。
- 低开销、高效率:在收敛效率方面,OBELISK 的迭代次数只需 Bao、BayesQO 的一半甚至更低;借助两阶段评估于大模型的推理能力,OBELISK 的总耗时也显著低于 Bao、BayesQO 等现有基线。
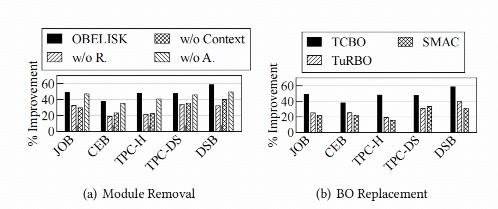
- 组件协同有效性:消融实验表明,OBELISK 框架中,贝叶斯优化、大模型自进化推理器、评估器三大组件缺一不可。移除推理器后,平均性能会大幅下降 33.7% 至 51.8%();替换掉 TCBO 模块(如使用 SMAC 或 TuRBO 替代)后,在 CEB 负载上的性能提升率分别降低了 41.8% 和 33.4%;而移除两阶段评估器的准入机制后,不仅在 DSB 负载上性能下降 15.5%(),还会引入噪声数据误导模型的搜索。
02 Jasper:联合自适应存储,破解 HTAP 的“隔离性—新鲜度”权衡难题
论文标题:《Breaking the Isolation-Freshness Trade-off: Joint Adaptive Storage Optimization for HTAP Systems》
下载链接:https://www.vldb.org/pvldb/vol19/p1142-ding.pdf
背景与挑战
混合事务与分析处理(HTAP)系统需要同一套系统同时支撑在线交易(OLTP)与实时分析(OLAP)。为兼顾两类负载,主流做法是同时维护行存与列存双份副本,再通过异步同步保证一致性。但这种“全量双副本”的粗粒度配置容易带来高昂的同步开销——论文微基准测试显示:开启同步后,分析型查询延迟增加 16.5%–74.4%,且交易负载越重、退化越明显。
创新与成果
研究提出 Jasper 这样一种“联合自适应存储”机制,摒弃了粗粒度的表级副本策略。它能根据业务访问特征,动态组合两类手段——细粒度的水平/垂直分区,以及对“更新少、查询密”的分区选择性物化列存副本——从而在保证事务不被分析查询干扰(强隔离)的同时,尽量减少冗余副本带来的同步开销、提升数据新鲜度。
核心技术解析
- 基于读写特征的“效用—优先级”搜索(MCTS-HTAP)
存储布局的组合空间呈阶乘级爆炸,穷举不可行。Jasper 将“分区 + 列存选择”的联合优化建模为树结构搜索,采用蒙特卡洛树搜索(MCTS)求解,并依据列级读写频率计算动作优先级与节点效用,优先探索有前景的配置、剪枝低效用分支。
- 无侵入的轻量级代价评估模型
Jasper 避免频繁请求数据库优化器,而是缓存查询的逻辑执行计划,结合存储元数据直接实例化物理算子,生成一棵“执行代价树”。该模型除常规算子开销外,还显式纳入了 HTAP 特有成本:列存副本等待最新更新的同步成本(Sync Cost),以及列存数据参与连接时的行列格式转换成本(Transform Cost);模型参数仅用少量算子级延迟样本做离线最小二乘校准,训练开销极小。在动态负载测试中,Jasper 单次评估调用耗时仅 6.7 秒,而依赖优化器逐次生成物理计划的方案需要 40 秒。
- 感知数据迁移成本的增量更新
当业务访问模式发生变化时,Jasper 通过“历史窗口 vs 滑动窗口”捕捉访问频率偏移,只为发生显著变化的列生成局部重构候选,而不是从头重跑整套优化。它内置数据迁移代价模型(扫描开销 + 按带宽/数据量回归估计的重分布 I/O 开销):只有当预期查询收益大于底层数据重分布成本时,才真正触发存储结构变更。
实验数据
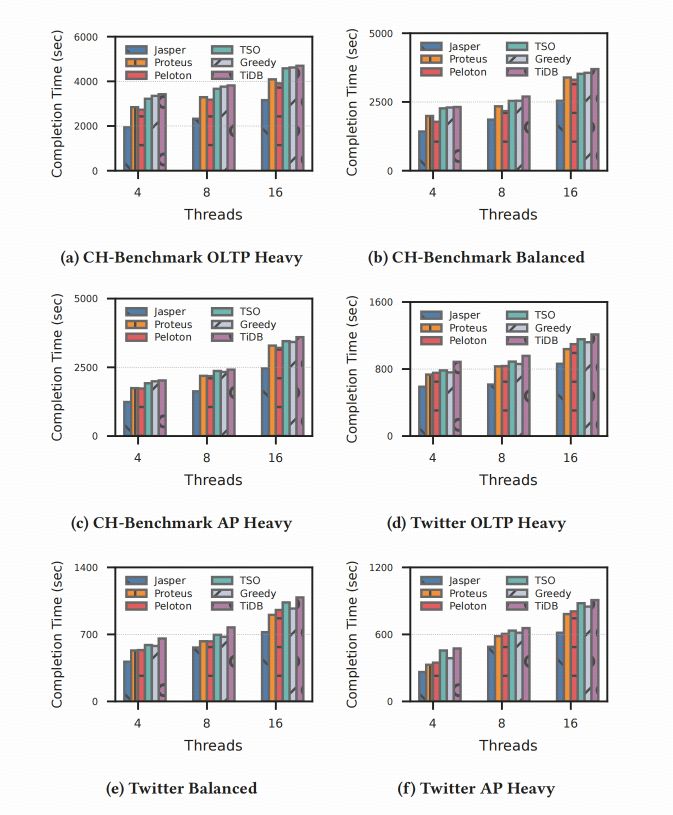
- 降低混合负载完成时间:相比 Proteus、Peloton、两阶段优化(TSO)及 TiDB 默认方案等基线,Jasper 在 CH-Benchmark 上把平均整体完成时间降低 20.72%–40.59%,在 Twitter 基准的混合读写负载上降低 20.43%–33.28%。
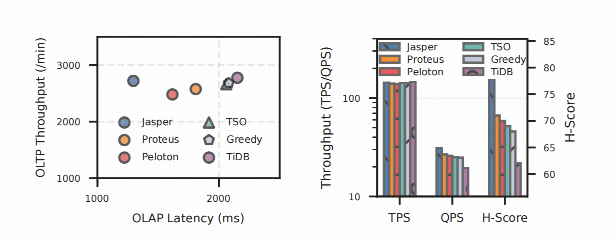
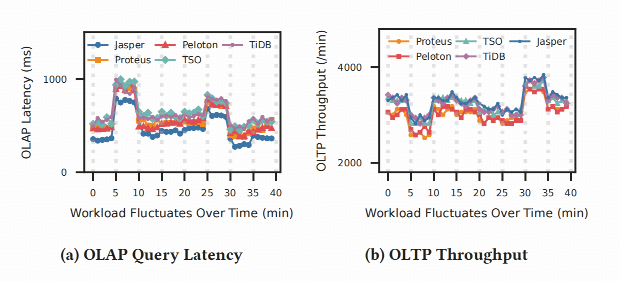
- 吞吐与延迟兼优:在读写均衡(Balanced)负载下,Jasper 的 OLAP 查询延迟比 TiDB 默认的全量双写设置低 39.7%,比 Proteus、Peloton、TSO 分别低 28.39%、19.9%、37.11%,同时 OLTP 吞吐与各方法基本持平;在 HyBench 上亦取得最高 QPS 与 H-Score。
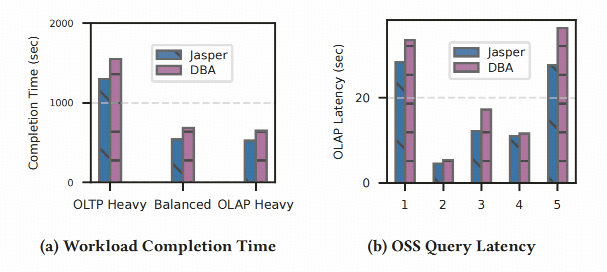
- 真实生产负载验证:在源自 TiDB 真实使用场景、包含超过 80 亿行 GitHub 事件记录的 OSS Insight 负载上,Jasper 自动生成的存储配置相比 DBA 人工调优配置,执行时间进一步缩短 16.67%–21.16%;当负载形态频繁变化时,它只在访问模式显著漂移的时刻做增量调整,始终保持最低延迟与最高吞吐。
结语
此次两篇论文同时入选 VLDB 2026,印证了平凯星辰在数据库内核与查询优化方向的长期技术积累,也展现了“产研结合、以真实系统验证前沿研究”的工程深度。未来,平凯星辰将继续深化与高校的产学研合作,把更多“顶会论文”变成生产环境里看得见的性能提升,为用户带来更智能、更高效的数据处理体验。