
本文主要通过总结TiDB在实践中的SQL调优三个实践案例,引导大家在实践中如何优化业务应用,性能优化,感受让tidb如何“”飞起来“”的真实案例。
案例一:统计信息过期,索引”视而不见”
1.1 问题现象
某电商订单表 orders 约 8 亿行,业务反馈一个简单的查询从 200ms 暴涨到 40 秒:
SELECT order_id, amount, statusFROM ordersWHERE user_id = 123456 AND create_time > '2024-01-01'ORDER BY create_time DESC LIMIT 20;
表结构:
CREATE TABLE orders ( order_id BIGINT PRIMARY KEY, user_id BIGINT, create_time DATETIME, amount DECIMAL(10,2), status TINYINT, INDEX idx_user_time (user_id, create_time) -- 联合索引);
1.2 诊断过程
执行 EXPLAIN ANALYZE:
EXPLAIN ANALYZE SELECT order_id, amount, statusFROM ordersWHERE user_id = 123456 AND create_time > '2024-01-01'ORDER BY create_time DESC LIMIT 20;
优化前执行计划:

关键异常分析:
指标 |
优化前值 |
说明 |
|---|---|---|
IndexRangeScan estRows |
100,000 |
估计扫描 10 万行 |
IndexRangeScan actRows |
100,000 |
实际扫描 10 万行 |
Selection 后 actRows |
20 |
过滤后只剩 20 行 |
问题本质 |
— |
create_time 条件在索引中,但优化器未用它做范围裁剪 |
检查统计信息健康度:
SHOW STATS_HEALTHY WHERE table_name = 'orders';
-- 结果:healthy = 25 (远低于 80 的及格线)
根因判定: ANALYZE 已长时间未执行,优化器误判 create_time 筛选率,选择先扫描整个 user_id 再回表过滤。
1.3 优化方案
步骤 1:立即恢复统计信息
ANALYZE TABLE orders;
步骤 2:验证执行计划
重新执行 EXPLAIN ANALYZE:
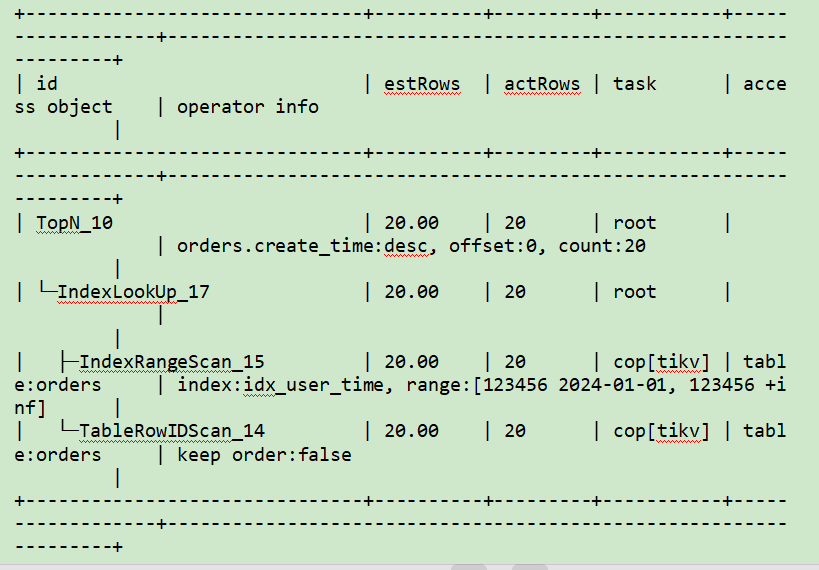
关键改进: IndexRangeScan 的 range 变为 [123456 2024-01-01, 123456 +inf],联合索引两字段均参与范围裁剪。
步骤 3:配置自动收集策略(防复发)
-- 设置自动 ANALYZE 阈值SET GLOBAL tidb_auto_analyze_ratio = 0.5; -- 修改行数超过 50% 时触发SET GLOBAL tidb_auto_analyze_start_time = '00:00 +0800';SET GLOBAL tidb_auto_analyze_end_time = '06:00 +0800';
1.4 效果验证
指标 |
优化前 |
优化后 |
提升倍数 |
|---|---|---|---|
查询耗时 |
40s |
180ms |
222x |
索引扫描行数 |
100,000 |
20 |
5,000x |
Coprocessor 请求量 |
大量 |
极少 |
— |
案例二:时间维度分区表 + 分区裁剪失效
2.1 问题现象
日志表 app_logs 按天分区,30 天约 15 亿行。查询最近 3 天的 ERROR 日志:
SELECT * FROM app_logsWHERE log_level = 'ERROR' AND log_time > NOW() - INTERVAL 3 DAY;
耗时 12 秒,分区表的优势完全没有体现。
2.2 诊断过程
EXPLAIN SELECT * FROM app_logs WHERE log_level = 'ERROR' AND log_time > NOW() - INTERVAL 3 DAY;
优化前执行计划:

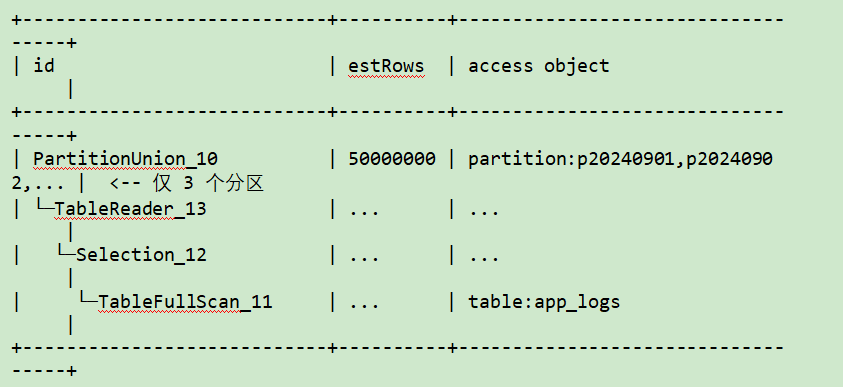
根因判定: PartitionUnion 显示 partition:all,分区裁剪完全失效。问题出在 NOW() - INTERVAL 3 DAY —— TiDB 优化器无法对包含非常量函数的表达式进行分区裁剪。
2.3 优化方案
改写 SQL,使用确定的常量值:
-- 方式一:
应用层传入确定时间SELECT * FROM app_logsWHERE log_level = 'ERROR' AND log_time > '2024-09-01 14:22:00';
-- 确定的时间字符串--
方式二:
先计算边界值再查询SET @three_days_ago = DATE_FORMAT(NOW() - INTERVAL 3 DAY, '%Y-%m-%d %H:%i:%s');
-- 然后在应用层将 @three_days_ago 作为参数传入
优化后执行计划:
进阶优化(高筛选率场景):
若 log_level = 'ERROR' 筛选率很高(如仅占 1%),增加局部索引:
ALTER TABLE app_logs ADD INDEX idx_level_time (log_level, log_time);
执行计划将变为 IndexLookUp,减少回表数据量。
2.4 效果验证
指标 |
优化前 |
优化后 |
提升倍数 |
|---|---|---|---|
扫描分区数 |
30 个 |
3 个 |
10x |
查询耗时 |
12s |
350ms |
34x |
扫描行数 |
15 亿 |
约 5000 万 |
30x |
案例三:写热点 —— 自增主键的”死亡陷阱”
3.1 问题现象
物联网设备上报数据,峰值 10 万 QPS,表结构:
CREATE TABLE device_data ( id BIGINT AUTO_INCREMENT PRIMARY KEY, -- 自增主键 device_id VARCHAR(32), data_value DOUBLE, report_time TIMESTAMP);
TiDB Dashboard 显示 某个 Region 写入流量是其他 Region 的 100 倍,TiKV 节点负载极不均衡,写入延迟飙升,部分请求超时。
3.2 诊断过程
检查表 Region 分布:
SHOW TABLE device_data REGIONS;
TiDB Dashboard Key Visualizer 观察:
- 现象:一条明显的”亮线”集中在 Key Range 最大值端
- 结论:所有新写入集中在最后一个 Region
根因判定: - TiDB 中主键默认是聚簇索引(Clustered Index)
- AUTO_INCREMENT 导致新数据 id 永远递增到最大值
- 写入全部集中在最后一个 Region,形成写热点
3.3 优化方案
方案 A:使用 AUTO_RANDOM(官方推荐)
-- 重建表,将自增改为随机分布CREATE TABLE device_data ( id BIGINT AUTO_RANDOM(6) PRIMARY KEY, -- 6 位 shard 位 device_id VARCHAR(32), data_value DOUBLE, report_time TIMESTAMP);
原理: AUTO_RANDOM 在 id 高位插入随机 shard 位,将写入均匀分散到不同 Region。
方案 B:使用联合主键(业务允许时)
CREATE TABLE device_data ( device_id VARCHAR(32), report_time TIMESTAMP, data_value DOUBLE, PRIMARY KEY (device_id, report_time) -- 按业务维度自然分散) SHARD_ROW_ID_BITS = 4 PRE_SPLIT_REGIONS = 4;
参数说明: - SHARD_ROW_ID_BITS = 4:对非聚簇表打散 _tidb_rowid,产生 16 个分片 - PRE_SPLIT_REGIONS = 4:建表时预分裂 16 个 Region
方案 C:应用层缓冲(必须保留自增时)
若业务强依赖自增 ID(如与外部系统对接),在应用层引入缓冲: 1. 数据先写入 Redis / Kafka 2. 消费者多线程、批量写入 TiDB 3. 降低瞬时并发压力
3.4 效果验证
使用 AUTO_RANDOM 后,通过 TiDB Dashboard → Key Visualizer 观察:
观察维度 |
优化前 |
优化后 |
|---|---|---|
热力图 |
一条”亮线”(热点) |
均匀分布的”热区” |
写入 QPS |
10 万(剧烈抖动) |
稳定 10 万 |
P99 写入延迟 |
500ms |
15ms |
TiKV 负载均衡 |
极差 |
均衡 |
调优方法论总结
4.1 问题分类与诊断工具
问题类型 |
首选诊断工具 |
核心关注指标 |
执行计划异常 |
EXPLAIN ANALYZE |
estRows vs actRows 偏差、operator 类型 |
统计信息失效 |
SHOW STATS_HEALTHY |
healthy 值(< 80 需关注) |
分区未裁剪 |
EXPLAIN 查看 PartitionUnion |
partition 列是否显示 all |
写热点 |
TiDB Dashboard Key Visualizer |
Region 流量分布是否均匀 |
慢查询分析 |
INFORMATION_SCHEMA.SLOW_QUERY |
Query_time、Cop_time、Process_keys |
索引使用 |
EXPLAIN 查看 access object |
是否使用了预期索引 |
4.2 三条铁律
1. 永远先看执行计划EXPLAIN ANALYZE 是 TiDB SQL 调优的”听诊器”。
重点关注 estRows 和 actRows 的偏差,若偏差超过 10 倍,优先检查统计信息。
2. 统计信息是第一生产力ANALYZE 不是可选项。
生产环境务必配置自动收集策略,配合 tidb_auto_analyze_ratio 和 tidb_auto_analyze_start_time 实现无人值守。
3. 热点比慢查询更致命慢查询影响单个业务,写热点可能拖垮整个集群。
表结构设计阶段就必须考虑 Key 的分布,避免 AUTO_INCREMENT 聚簇索引的陷阱。
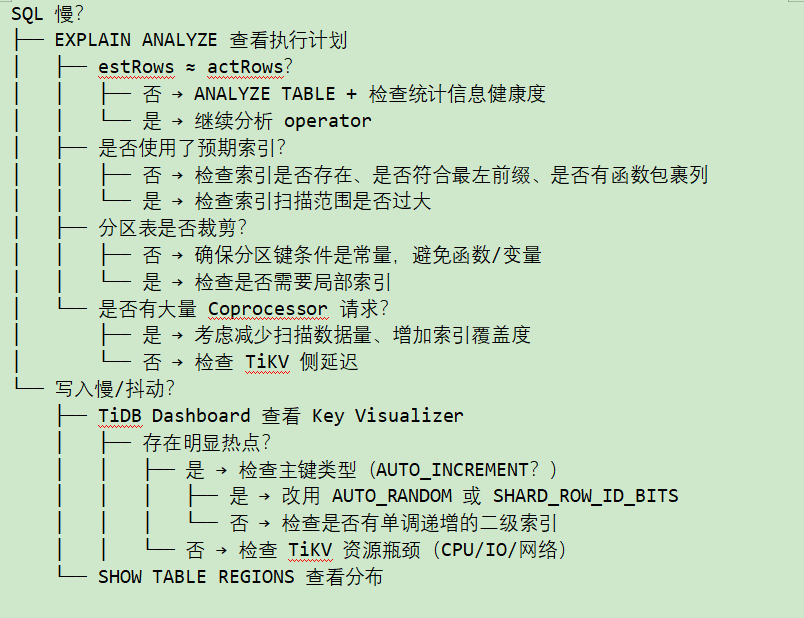
4.3 调优决策树
附录:常用诊断命令速查
A.1 统计信息相关
-- 查看表统计信息健康度
SHOW STATS_HEALTHY WHERE table_name = 'your_table';-
- 手动收集统计信息ANALYZE TABLE your_table;
-- 查看列统计信息详情
SHOW STATS_HISTOGRAMS WHERE table_name = 'your_table';
-- 查看自动收集配置SHOW VARIABLES LIKE 'tidb_auto_analyze%';
A.2 执行计划相关
-- 查看执行计划(含实际执行数据)
EXPLAIN ANALYZE SELECT ...;-
- 查看绑定执行计划(SQL Binding)SHOW BINDINGS;
-- 创建执行计划绑定(固定走某索引)
CREATE GLOBAL BINDING FOR SELECT * FROM t WHERE a = 1 USING SELECT * FROM t USE INDEX(idx_a) WHERE a = 1;
A.3 热点诊断相关
-- 查看表 Region 分布
SHOW TABLE your_table REGIONS;
-- 查看 Region 热点(TiDB 内置)SELECT * FROM information_schema.TIKV_REGION_STATUS WHERE table_name = 'your_table' ORDER BY written_bytes DESC LIMIT 10;
-- 查看 Store 负载分布SELECT * FROM information_schema.TIKV_STORE_STATUS;
A.4 慢查询分析
-- 查询最近慢 SQLSELECT * FROM information_schema.SLOW_QUERY WHERE query_time > 1 ORDER BY query_time DESC LIMIT 10;
-- 关注字段-- query_time: 总耗时
-- parse_time: 解析耗时-
- compile_time: 优化器生成计划耗时-
- cop_time: TiKV 执行耗时
-- process_keys: 处理的 key 数量
-- total_keys: 扫描的 key 数量(含旧版本)
A.5 系统参数参考
-- 查看当前会话/全局变量
SHOW [GLOBAL] VARIABLES LIKE 'tidb_%';-- 常用调优参数
SET GLOBAL tidb_auto_analyze_ratio = 0.5;
SET GLOBAL tidb_auto_analyze_start_time = '00:00 +0800';
SET GLOBAL tidb_auto_analyze_end_time = '06:00 +0800';
SET GLOBAL tidb_enable_pseudo_for_outdated_stats = OFF; -- 过期统计信息不使用伪统计