是的,正常情况下正在执行的sql可以查到,但是慢sql监控面板统计的都是已经执行完的sql,尚在进行中的只能到日志文件中查看
1 个赞
看一下TOPSQL,不过看起来有热块
1 个赞
看上去是遇到了热点问题

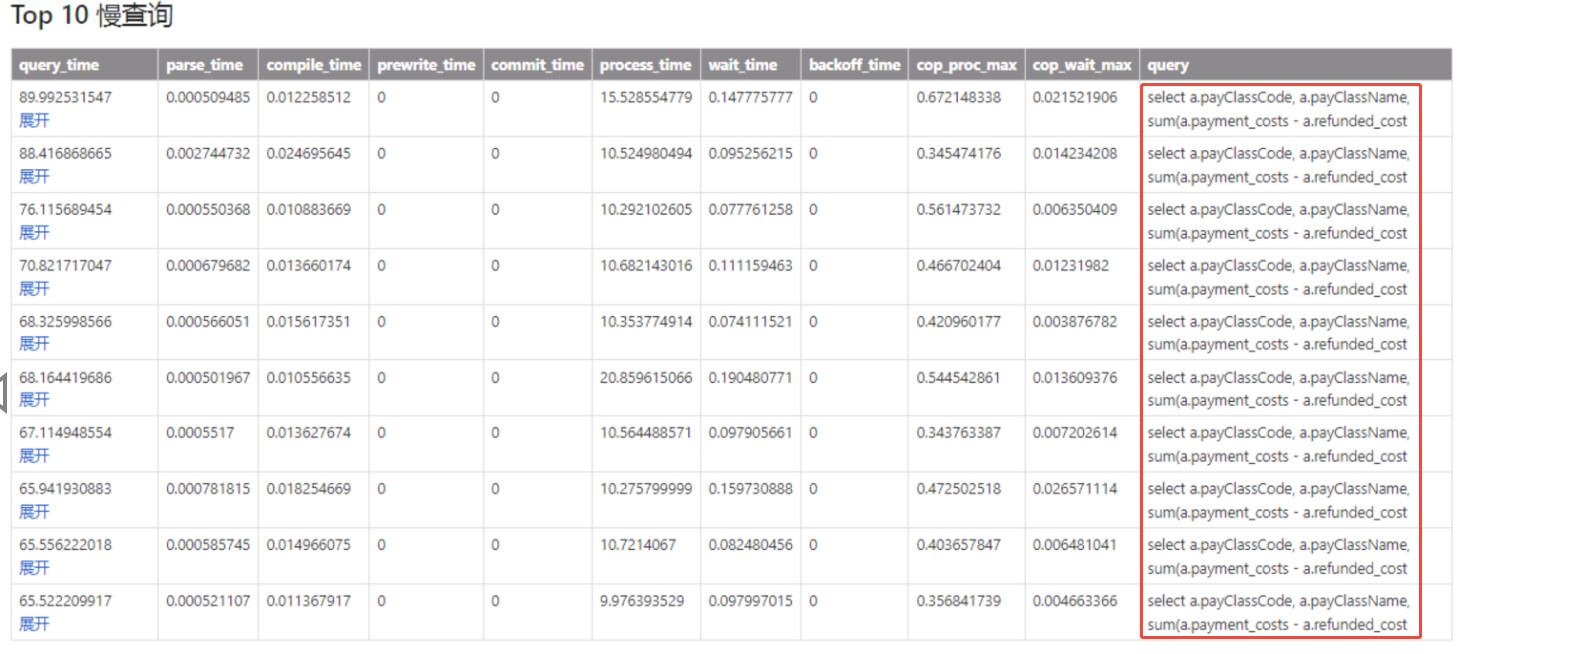
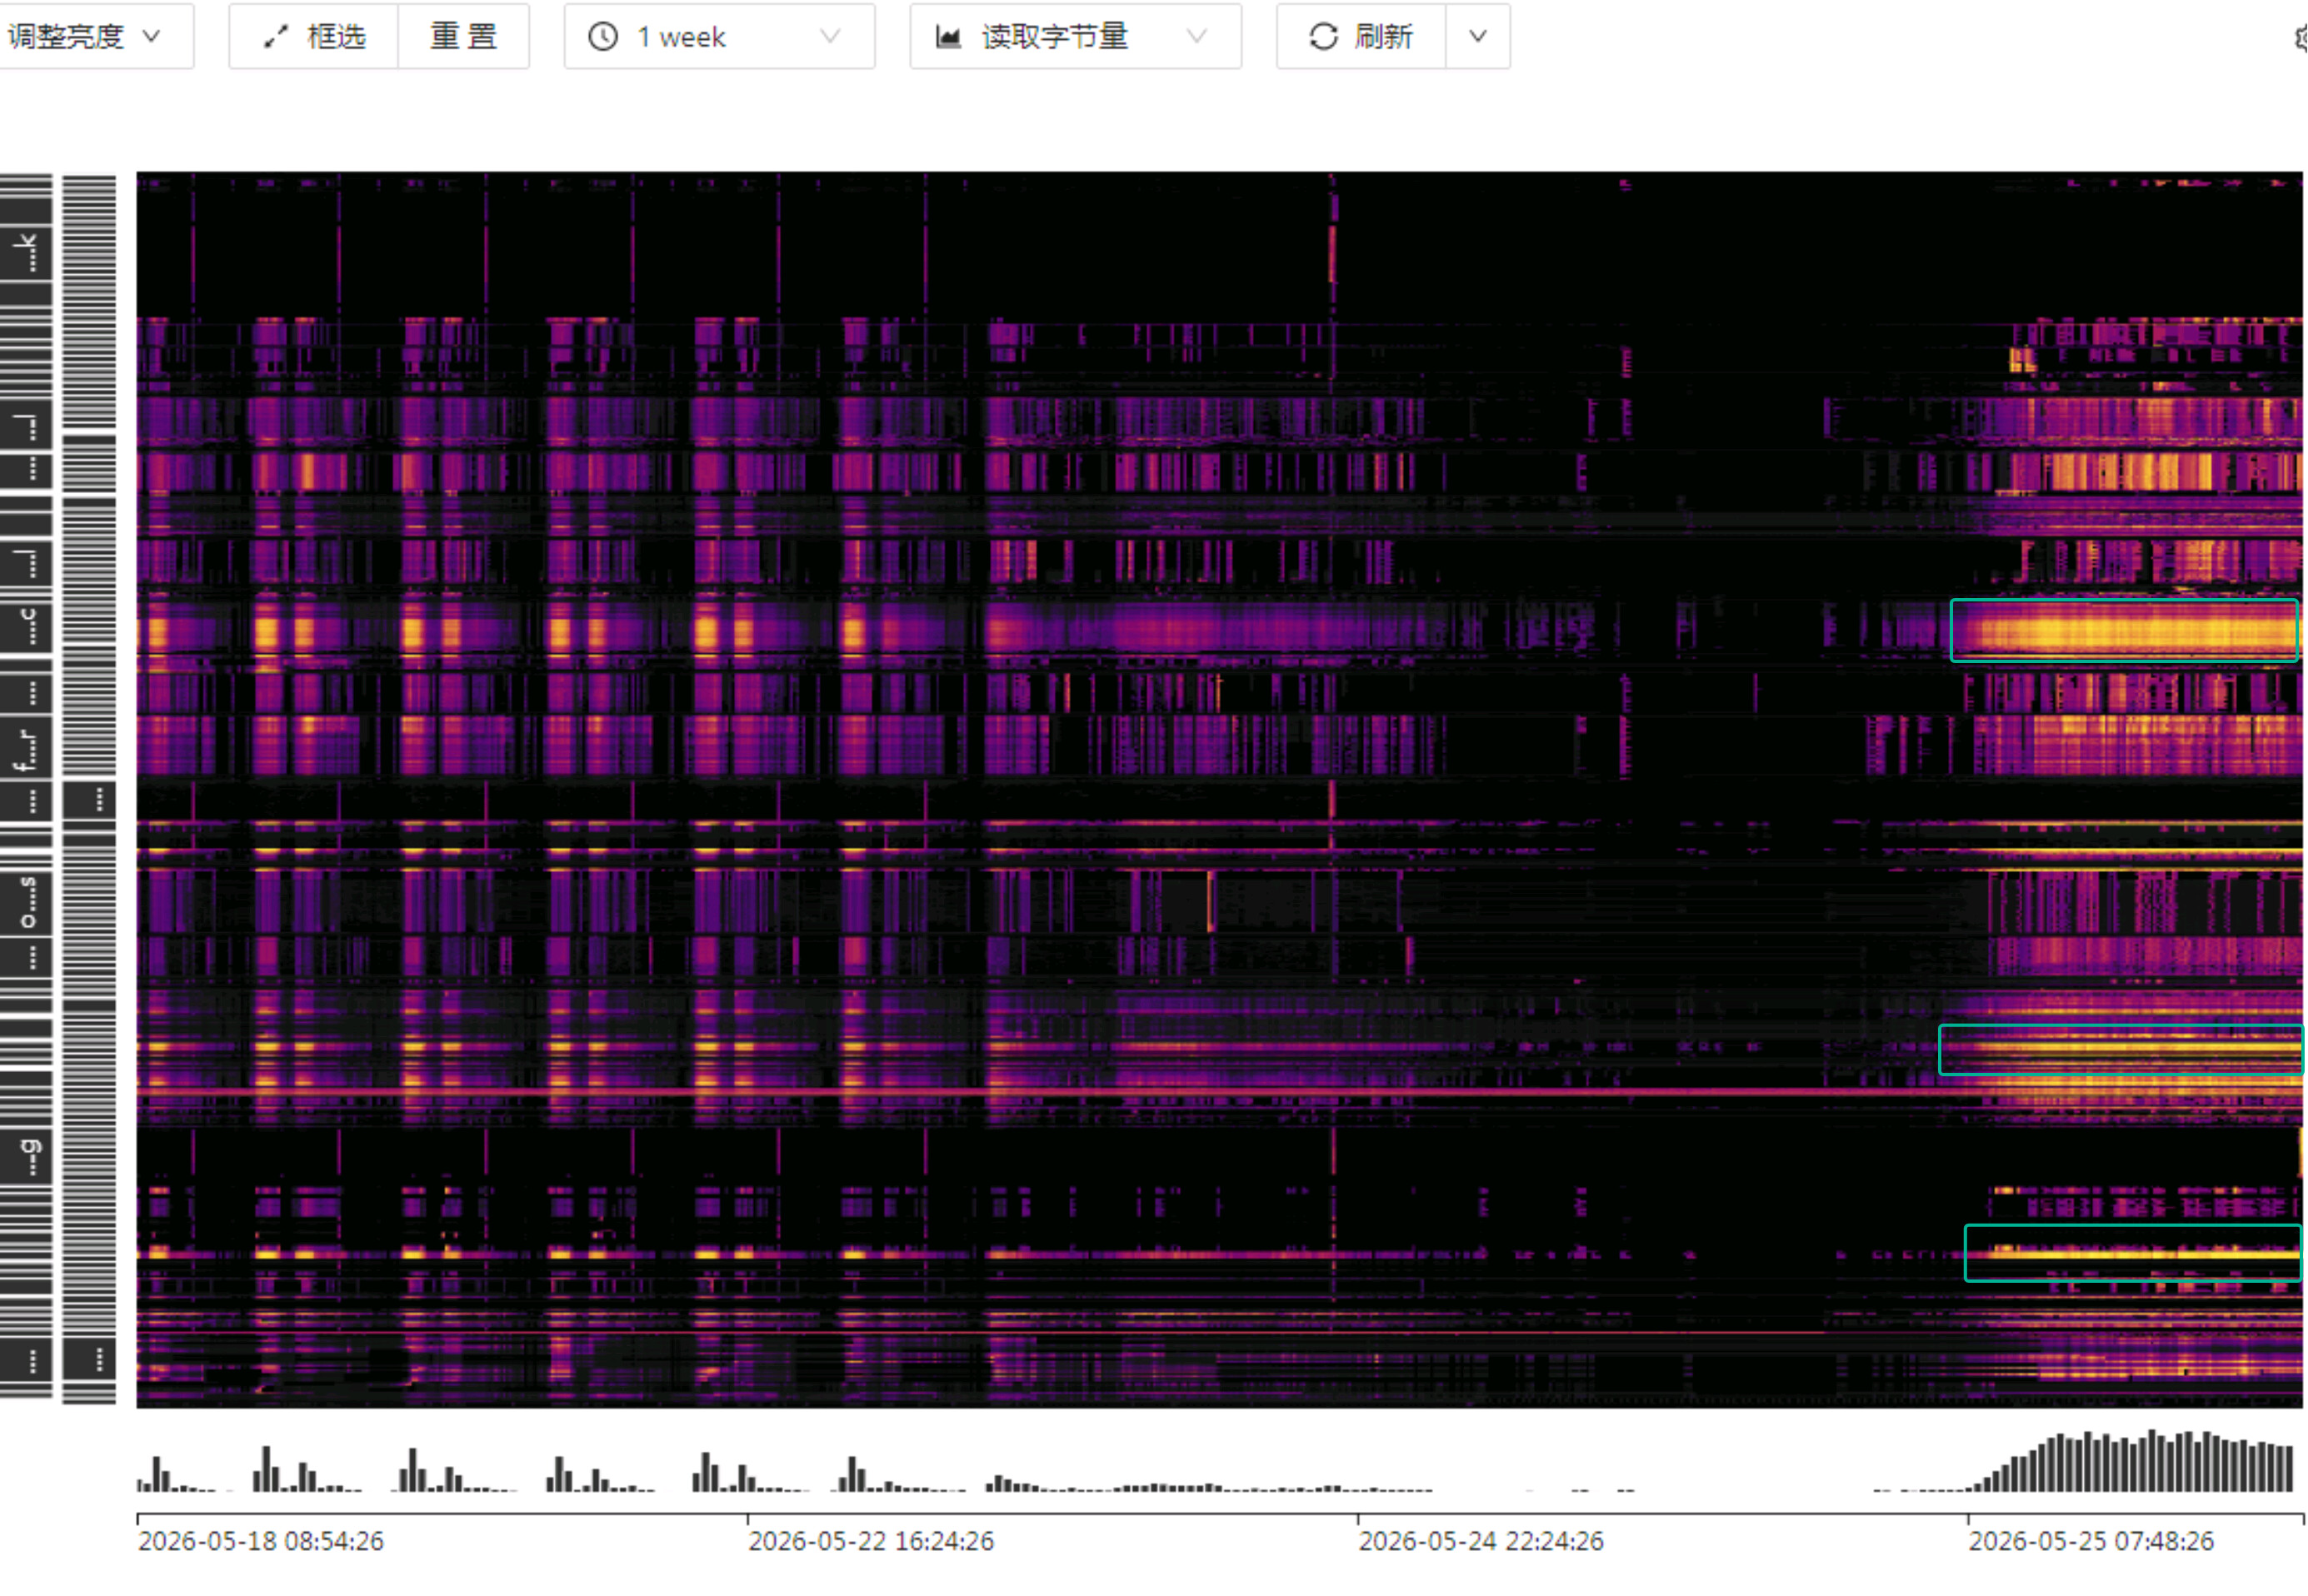
都有嫌疑。
这个图亮条,多了反倒抓不到重点。有一些表什么时候都是亮的(业务快的时候也亮),这些可以先排除。主要还是看,业务慢的时候,那些亮条是新出现的。
1 个赞
看看最热的sql执行计划
1 个赞
看上去没有明显的慢sql,是不是流量突然上长,延时有没有增加?
1 个赞
最后总结一句,tidb监控真娘的是鸡勒,完全无法确定是哪条SQL是导致CPU增长的,什么慢查询,什么SQL语句分析,什么TOP SQL,扯蛋,最终你会发现,这3个东西不能捕猎到一致点,最后你自己都迷糊了。
1 个赞
这句话说的比较贴切,出问题只能做问题定性,仔细分析还得靠内部字典
1 个赞
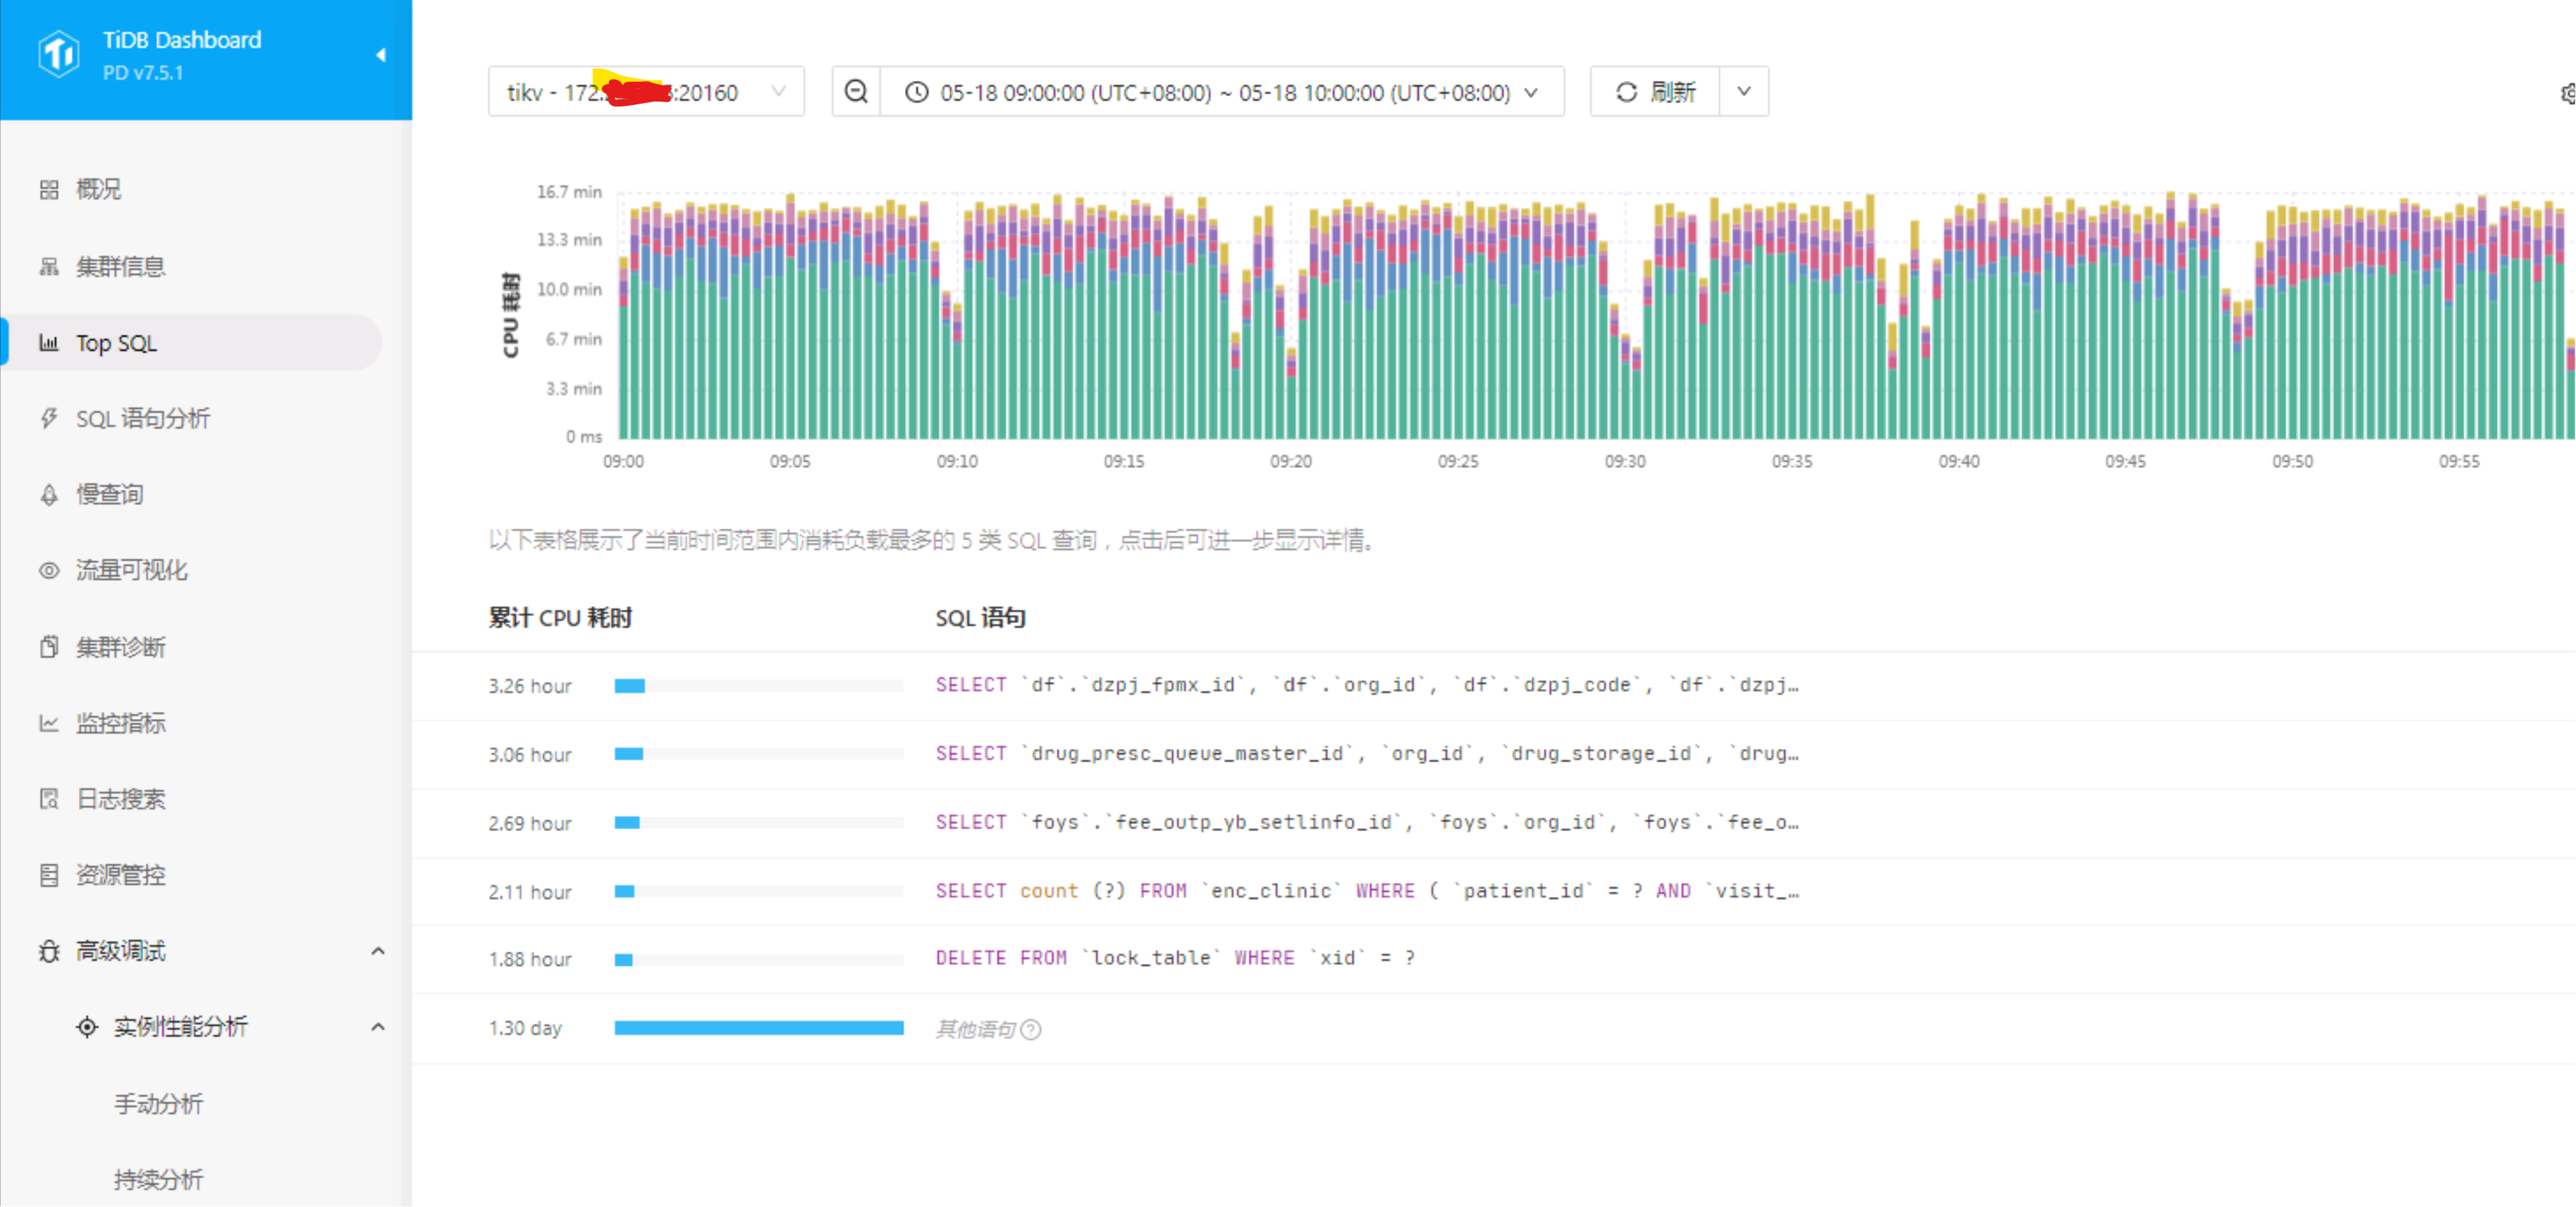
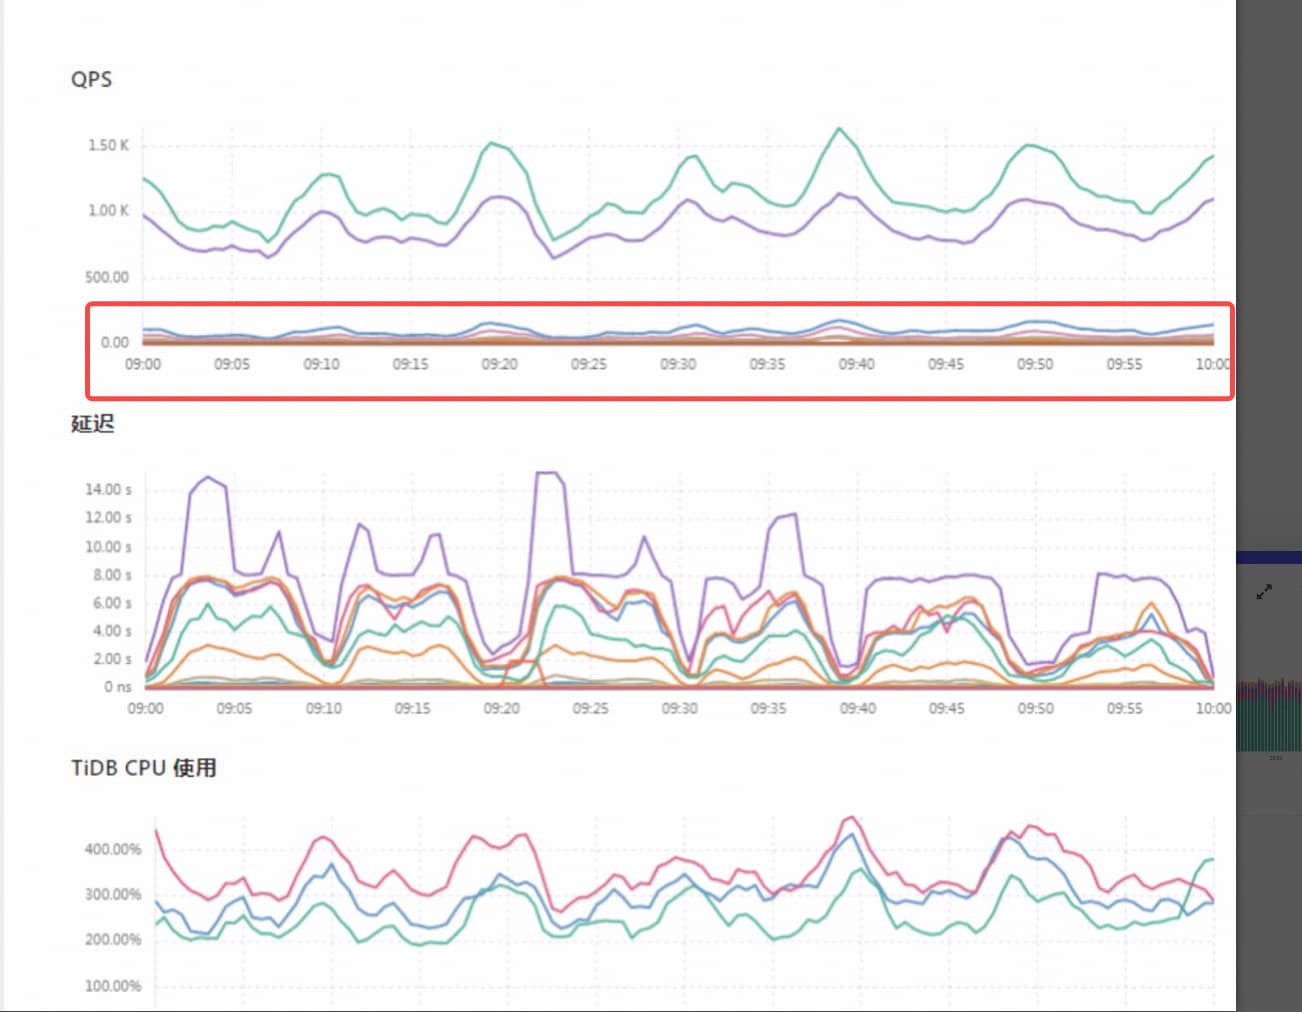
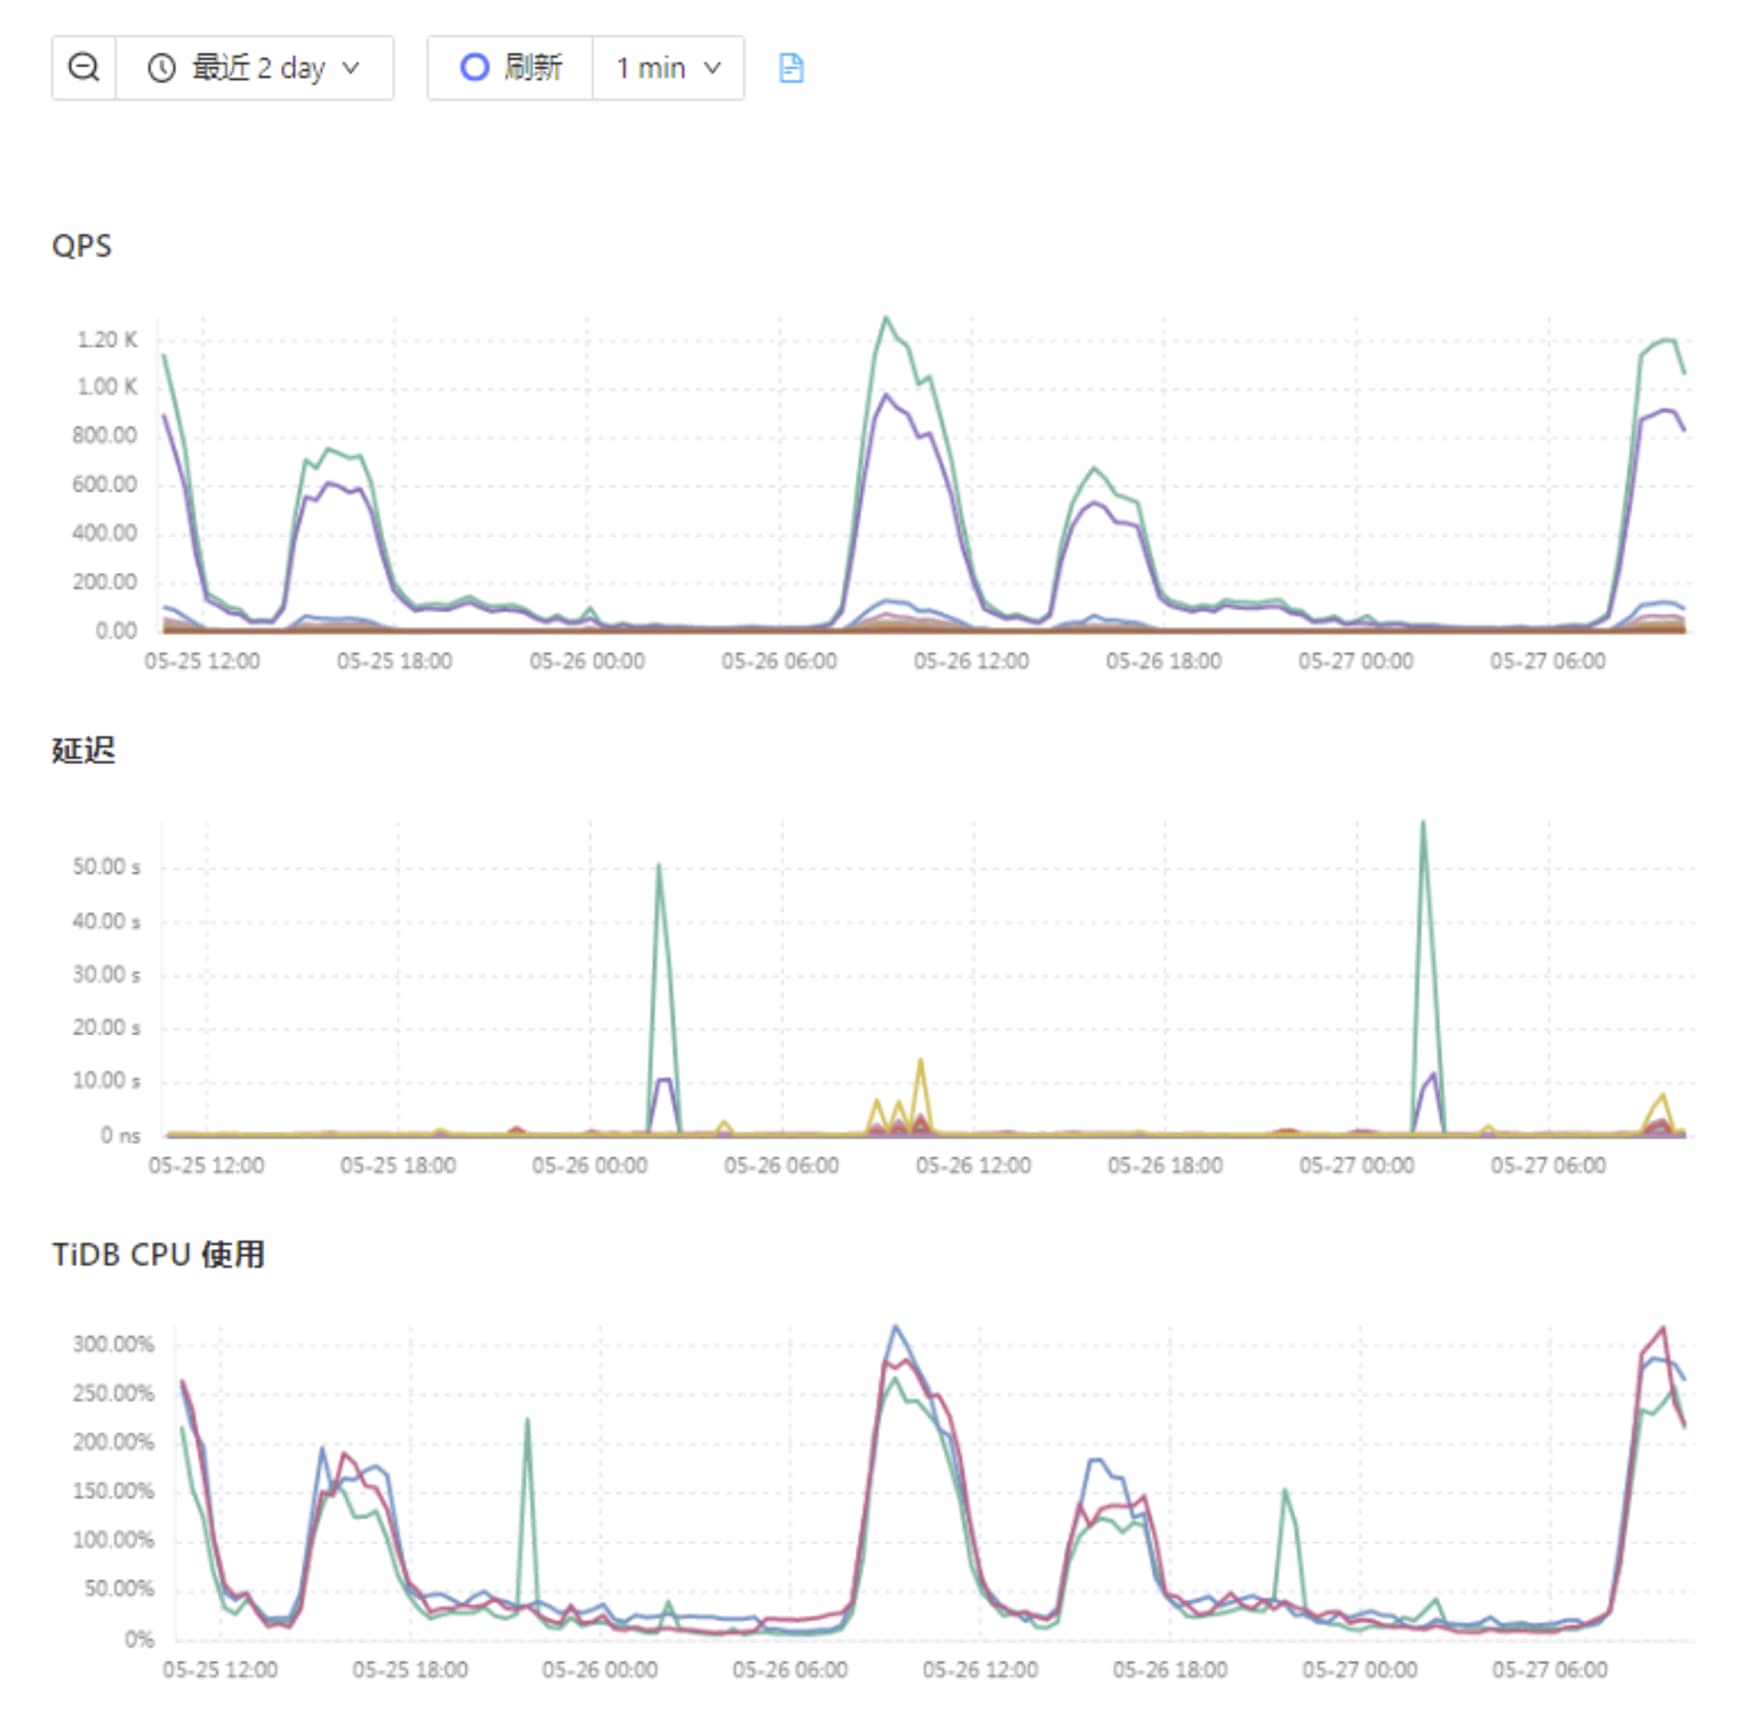
我是想问你,在 tikv cpu 飙高的对应时间前后,QPS 有明显上涨么。
如果有可能就是单纯 QPS 高导致的压力大。
监控上看一个 tikv cpu 高,而且是 read pool。那说明是读热点。
top sql 的图,tikv 选择的是 cpu 高的节点么,截图上来看,other 的含义是非 TOP 5 SQL,其他 SQL 占比 CPU 高。说明多数压力来自很多 SQL ,不是一个模式的 SQL。
有个老方法,你去对应 tikv 节点看日志,匹配关键字 slow-query .里面有一些 region 信息,看看 region 属于什么表的,反找对应表对应时间的 SQL。
看看查询条件和业务模型什么样的。
https://docs.pingcap.com/zh/tidb/stable/troubleshoot-hot-spot-issues/
下次遇到这个情况,热力图选择频次看看能不能看出啥。
1 个赞
TiDB的慢查询日志可以帮助你找到执行时间长的查询。你可以在TiDB配置文件中启用慢查询日志,并设置适当的阈值
1 个赞
使用 TiDB 的监控工具(如 Prometheus 和 Grafana)来查看系统的整体负载情况,特别是 CPU 使用率。然后可以通过Dashboard进一步确定topsql
1 个赞
TiDB 的 OOM 经常跟算子下推有关,比如 hash join 或 hash agg 在内存不足时不会 spill 到磁盘。从根本上说,建议从数据分布和查询模式入手,减少大表 JOIN 和全量扫描,利用 Region 级别的并行计算来分摊内存压力。
1 个赞
结合 Dashboard 流量监控视图,定位高读流量的数据表,再到 SQL 分析模块、慢查询日志 中,检索该表对应的执行语句,进一步排查问题。
1 个赞
show processlist 仅查看当前连接的单个 TiDB 节点的前端会话,无法跨节点查看整个集群。如果 SQL 路由到其他 TiDB 节点执行,当前节点自然看不到。
社区给出标准解决方案:使用集群级视图 INFORMATION_SCHEMA.CLUSTER_PROCESSLIST,可查看全集群所有活跃会话。
聚合查询如果没有覆盖索引,TiKV 需要逐行读取数据、计算,产生海量 CPU 运算。这是聚合类 SQL CPU 高的最常见原因。
1 个赞
向高手学习思考逻辑