一个好的问题描述有利于社区小伙伴更快帮你定位到问题,高效解决你的问题
【TiDB 使用环境】生产环境
【TiDB 版本】 6.5.5
【部署方式】机器部署
【操作系统/CPU 架构/芯片详情】
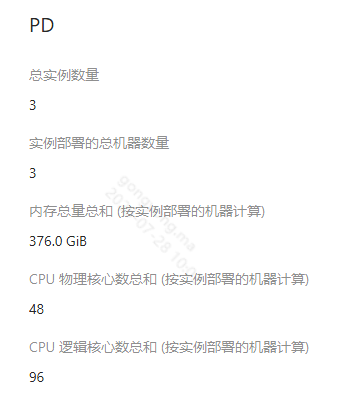
【机器部署详情】CPU大小/内存大小/磁盘大小
【集群数据量】
【集群节点数】
【问题复现路径】做过哪些操作出现的问题
昨天晚上一个pd server leader 所在的服务器迁移,进行了如下操作:
- 将pd leader的优先级参数由10改为1
tiup ctl:v6.5.5 pd member leader_priority pd-122 1 --pd 11.10.40.12:2379 - 等了一会,leader迁移走,停止这个pd server
tiup cluster stop xx --node 11.10.40.12:2379 - 之后服务器停机,服务器迁移大约40分钟,服务器启动后,pd server自动启动起来了,然后重新设置优先级,由1改为10,如下:
tiup ctl:v6.5.5 pd member leader_priority pd-122 10 --pd 11.10.40.12:2379 - 过了一会,pd全都挂了,三个pd server都显示为down
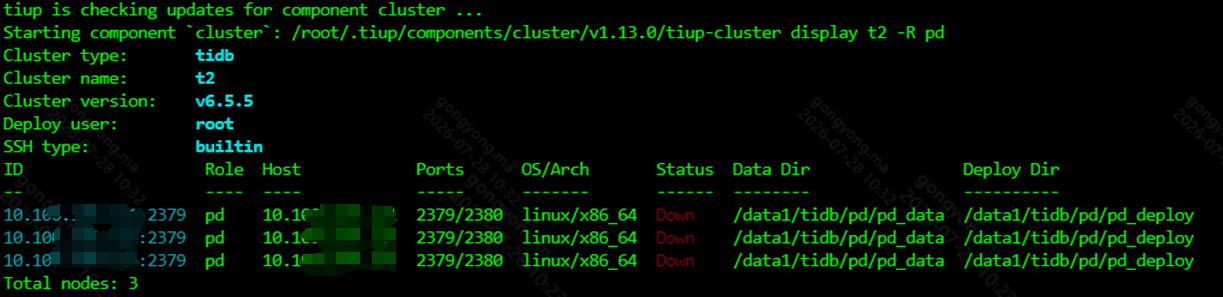
- 之后用tiup 操作启动或者重启,都不好使了,手动登录到pd server服务器,kill进程,恢复
- 但是之后还是挂掉,再杀 pd server进行,然后执行如下操作(将优先级改为1)后,没再挂掉
tiup ctl:v6.5.5 pd member leader_priority pd-122 1 --pd 11.10.40.12:2379
【遇到的问题:问题现象及影响】
整个集群挂了无法访问,业务侧报大量的pd server timeout
【资源配置】进入到 TiDB Dashboard -集群信息 (Cluster Info) -主机(Hosts) 截图此页面
【复制黏贴 ERROR 报错的日志】
[2026/07/27 22:00:49.025 +08:00] [INFO] [client.go:170] [“server starts to synchronize with leader”] [server=pd-121] [leader=pd-122] [request-index=34894806674]
[2026/07/27 22:00:49.025 +08:00] [ERROR] [client.go:174] [“region sync with leader meet error”] [error=“[PD:grpc:ErrGRPCRecv]rpc error: code = Unavailable desc = server not started: rpc error: code = Unavailable desc = server not start
ed”]
[2026/07/27 22:00:50.026 +08:00] [INFO] [client.go:170] [“server starts to synchronize with leader”] [server=pd-121] [leader=pd-122] [request-index=34894806674]
[2026/07/27 22:00:50.026 +08:00] [ERROR] [client.go:174] [“region sync with leader meet error”] [error=“[PD:grpc:ErrGRPCRecv]rpc error: code = Unavailable desc = server not started: rpc error: code = Unavailable desc = server not start
ed”]
[2026/07/27 22:00:51.026 +08:00] [INFO] [client.go:170] [“server starts to synchronize with leader”] [server=pd-121] [leader=pd-122] [request-index=34894806674]
[2026/07/27 22:00:51.026 +08:00] [ERROR] [client.go:174] [“region sync with leader meet error”] [error=“[PD:grpc:ErrGRPCRecv]rpc error: code = Unavailable desc = server not started: rpc error: code = Unavailable desc = server not start
ed”]
[2026/07/27 22:00:52.026 +08:00] [INFO] [client.go:170] [“server starts to synchronize with leader”] [server=pd-121] [leader=pd-122] [request-index=34894806674]
[2026/07/27 22:00:52.027 +08:00] [ERROR] [client.go:174] [“region sync with leader meet error”] [error=“[PD:grpc:ErrGRPCRecv]rpc error: code = Unavailable desc = server not started: rpc error: code = Unavailable desc = server not start
ed”]
[2026/07/27 22:00:53.027 +08:00] [INFO] [client.go:170] [“server starts to synchronize with leader”] [server=pd-121] [leader=pd-122] [request-index=34894806674]
[2026/07/27 22:00:53.027 +08:00] [ERROR] [client.go:174] [“region sync with leader meet error”] [error="[PD:grpc:ErrGRPCRecv]rpc error: code = Unavailable desc = server not started: rpc error: code = Unavailable des
【其他附件:截图/日志/监控】
