一个好的问题描述有利于社区小伙伴更快帮你定位到问题,高效解决你的问题
【TiDB 使用环境】测试环境
【TiDB 版本】8.5.1
【部署方式】机器部署
【操作系统/CPU 架构/芯片详情】欧拉系统/x86
【机器部署详情】16核/64G/4T机械硬盘
【集群数据量】
【集群节点数】1
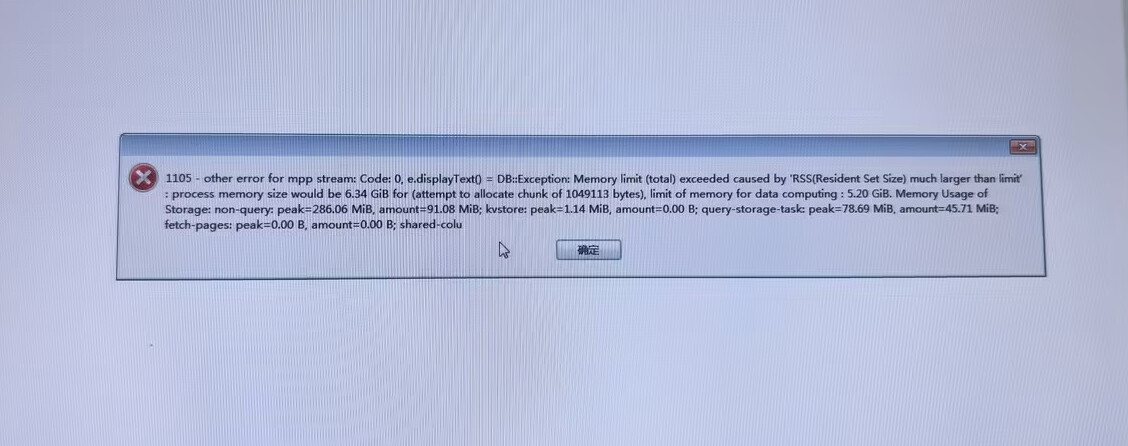
【问题复现路径】通过Navicat打开数据量2000的表,都开始报错。重启数据库后就正常。大概运行3个月,又会出现类似的情况
【遇到的问题:问题现象及影响】
【资源配置】进入到 TiDB Dashboard -集群信息 (Cluster Info) -主机(Hosts) 截图此页面
【复制黏贴 ERROR 报错的日志】
Memory limit (tota) exceeded caused by ‘Rs(Resident set size) much larger than limit’: process memory size would be 6.34 GiB for (atter
mpt to allocate chunk of 1049113 bytes), limit of memory for data computing : 5.20 GiB. Memory Usage of Storage: non-query: peak=286.06 MiB, amount=91.08 MiB;
【其他附件:截图/日志/监控】
菩提老祖
(菩提老祖)
2
一台机器 部署了tifkash 机械盘 数据量较大 oom
定期重启下 tidb
xfworld
(魔幻之翼)
3
上个集群资源分布看看,从 dashboard 里面可以拿到了,或者 tiup cluster 也可以
4T 机械硬盘 是极大的性能瓶颈,机械硬盘读取速度极慢,会导致大量的数据无法及时被处理或缓存,进而引发内存中堆积大量待处理的数据,最终撑爆内存
kang
5
这问题大概率是内存配置不合理,加上长期运行积累的内存泄漏。建议先调整TiDB内存限制参数,在tidb.toml或通过SQL设置:
SET GLOBAL tidb_mem_quota_query = '4294967296'; -- 4GB单查询限制
同时检查系统内存分配,在config添加:
[performance]
max-memory = 0.75  # 总内存的75%,约48GB
另外,测试环境单节点部署,建议监控内存使用趋势,用top -p <tidb_pid>定期观察。长期运行后报错,可能是Golang内存未及时释放,可以试试设置GOGC=100环境变量重启TiDB。如果还不行,考虑加个定时任务每天重启一次TiDB进程。
报错是 tidb_mem_quota_query / 实例内存限额触发,不是表只有 2000 行就该爆。Navicat 可能触发表结构/统计/全表相关额外查询,或实例被历史会话、统计任务、泄漏会话抬高常驻内存。建议:调合理 mem_quota、查 PROCESSLIST 与 Dashboard 内存;定期重启只能掩盖。机械盘+单机更要控制并发与大结果集。
system
(system)
关闭
8
此话题已在最后回复的 7 天后被自动关闭。不再允许新回复。