单表sql查询,优化器都选错执行计划
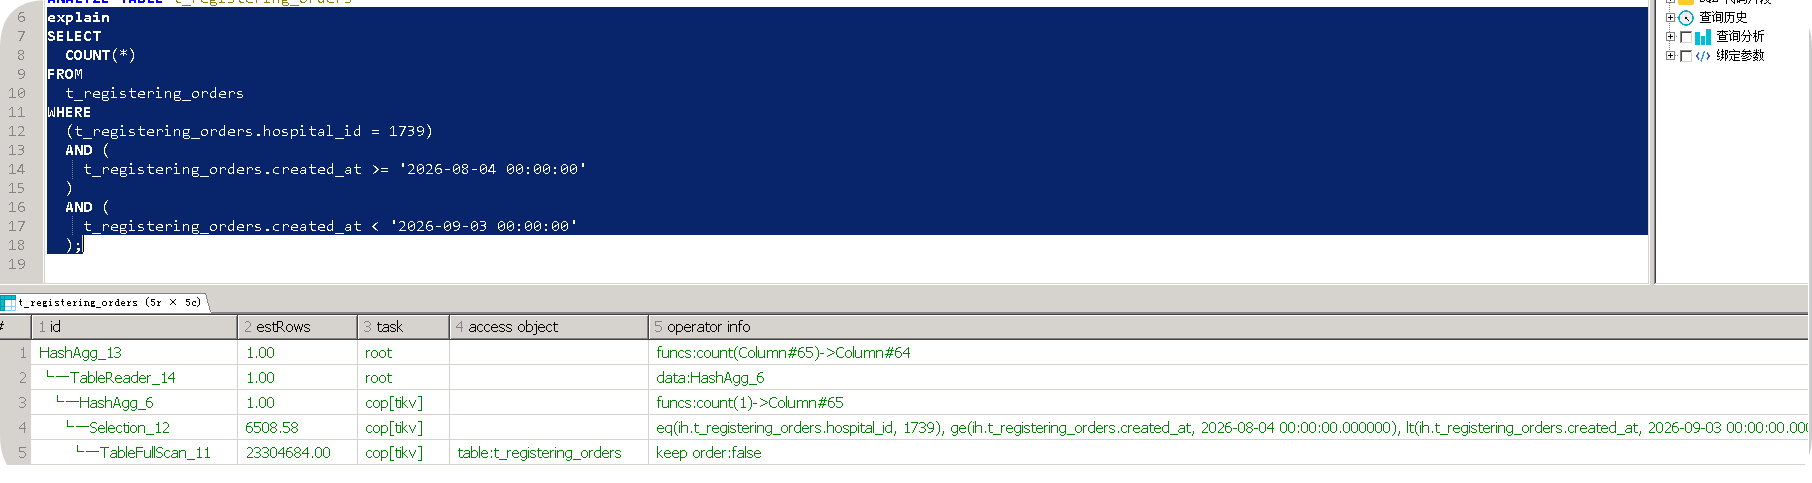
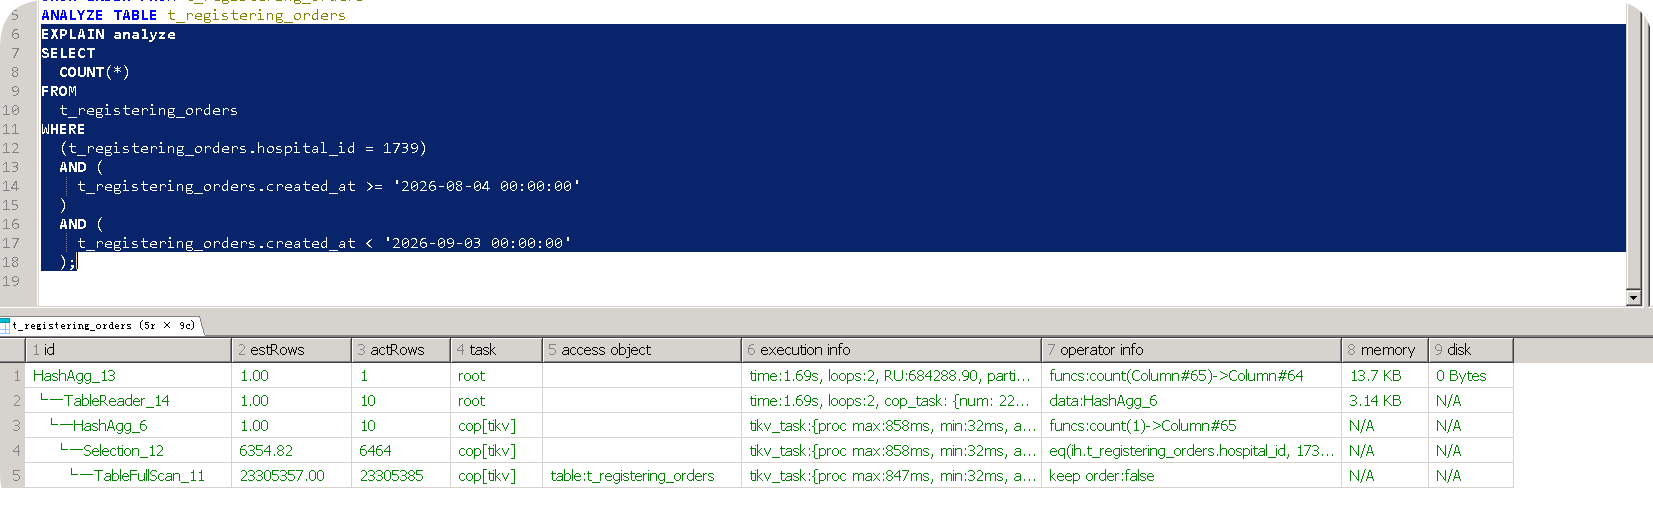
有索引,不走,反而走全表扫
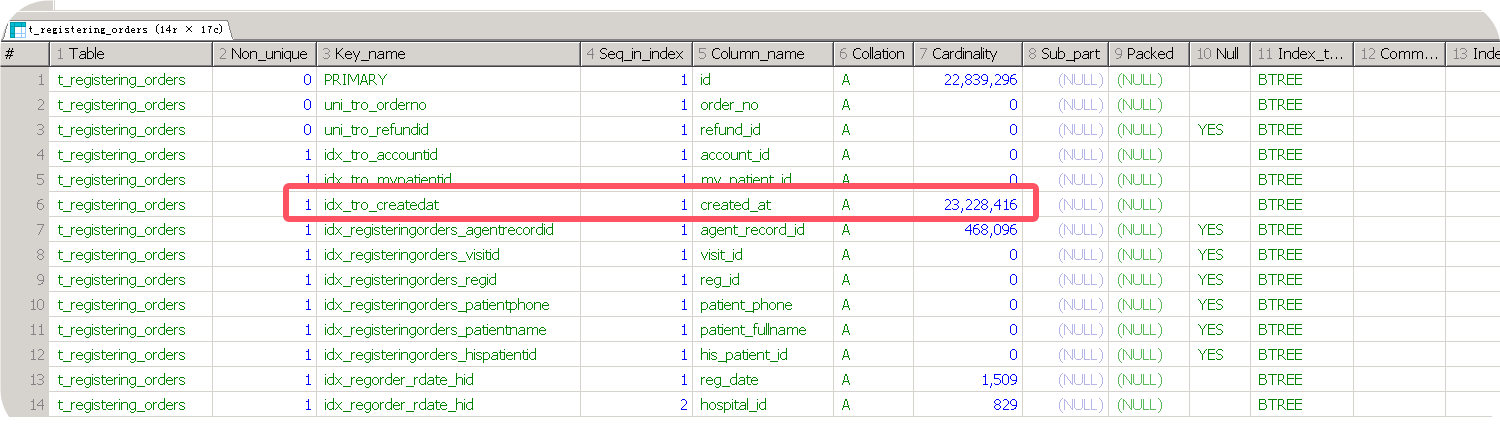
请问大佬们,这个问题如何解决(先不用hospital_id、created_at列的联合索引),为什么不选择created_at列索引?
单表sql查询,优化器都选错执行计划
改sql
SELECT COUNT(*) FROM t_registering_orders USE INDEX(idx_tro_createdat)
WHERE hospital_id = 1739
AND created_at >= ‘2026-08-04 00:00:00’
AND created_at < ‘2026-09-03 00:00:00’;
只能强制hint了。和数据库没关系。看直方图的评估吧。
你这走索引数据量也大,还不如走全表扫描了
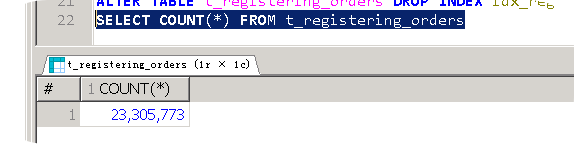
全表扫描 顺序读 2300 万行(单行成本很低)
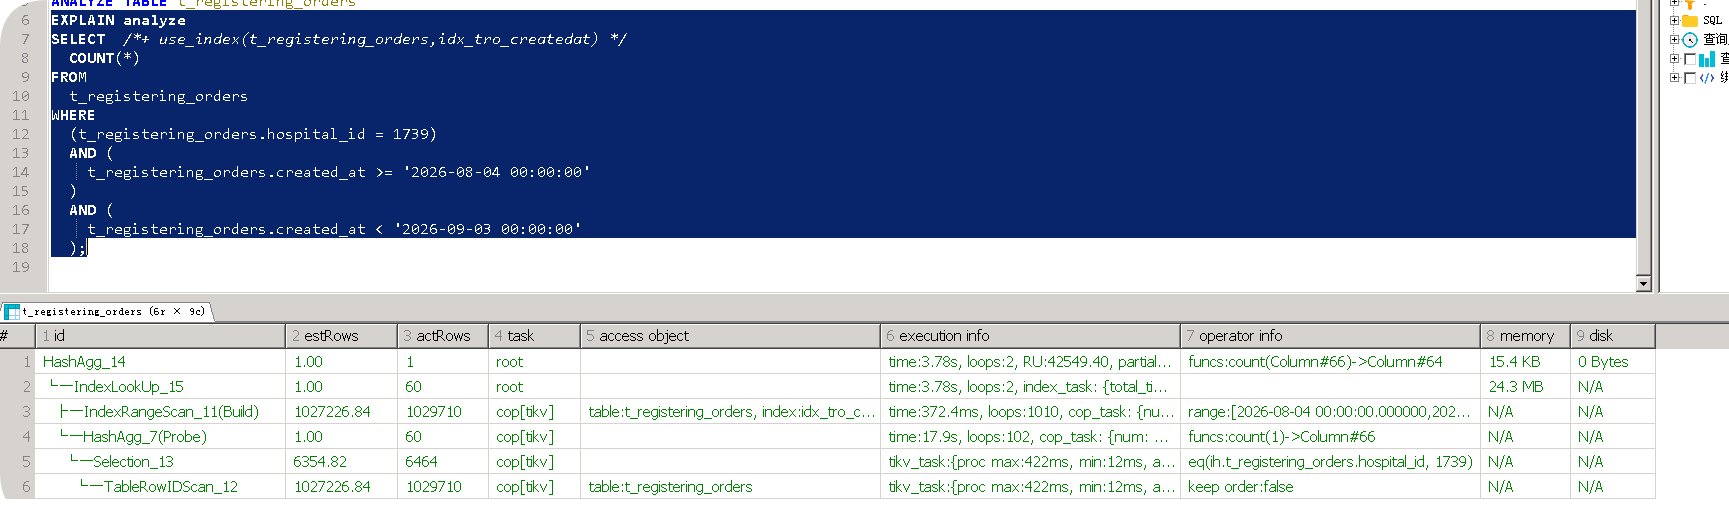
走索引 顺序读 103 万索引项 + 随机回表 103 万行(单次成本很高)
为什么指定索引,查询时间确实快很多
优化器考虑的不是查询时间,是资源消耗
优化器是要考虑资源,没错,但查询出结果时间很长,应用接受不了,没意义
优化器可能任务100W的数据回表产生的消耗更大。而且看执行计划的时间,full 是1s, index是3秒吧,而且index 占用的内存还多。
但是没找到是否有相关的参数可以限制比例之类的。
优化器的逻辑就是这样没办法,
正常就应该有个组合索引 就没这个问题了
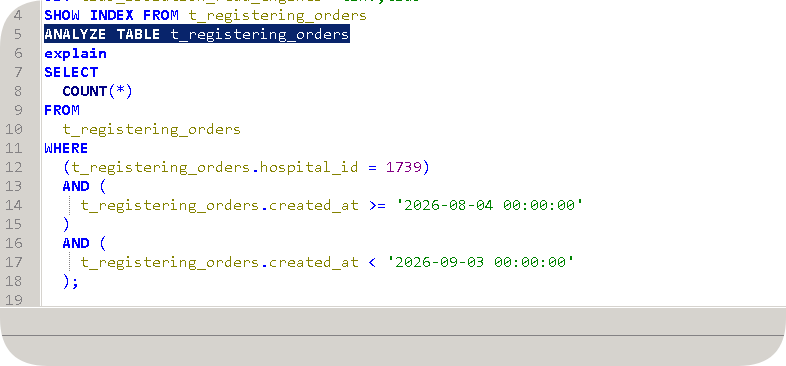
看下统计信息是不是不准,先跑下 ANALYZE TABLE 表名 刷新下。如果还不行,试试用 FORCE INDEX(created_at) 强制走索引验证下效果。另外检查下查询条件里对 created_at 有没有函数操作或隐式转换,比如 DATE(created_at) 或字符串比较,会导致索引失效。如果数据分布倾斜,优化器预估扫描行数少也可能选错,可以调下 tidb_opt_scan_choose 或直接 hint。
执行计划里写的 stats:pseudo 表示 TiDB 用的不是 “偏差的统计”,而是伪统计—— 也就是统计信息缺失、没加载或过期到失效,收集下统计信息看一下
如果只是统计数量,而且hospital_id、created_at 字段不为空,可以考虑直接count(hospital_id),通过 Index Merge避免回表。
搞个组合索引会比较好,或者绑定执行计划
弄个组合索引试试