【TiDB 使用环境】生产环境
【TiDB 版本】8.1.1
【部署方式】机器部署
【复制黏贴 ERROR 报错的日志】
【其他附件:截图/日志/监控】
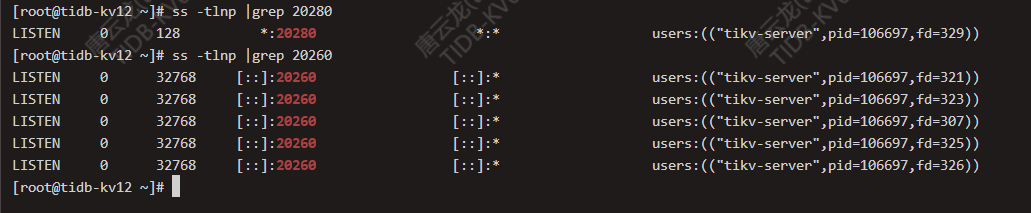
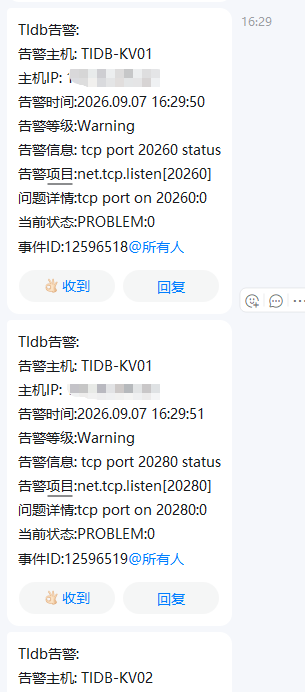
隔一段时间tikv01节点的20260和20280,tikv02节点的20160和20180端口就监听告警。查看端口还在,tikv03节点就从来没有告警。过大约5分钟就会恢复告警。日志里也没有什么信息,不影响业务,就是费解的很
【TiDB 使用环境】生产环境
【TiDB 版本】8.1.1
【部署方式】机器部署
【复制黏贴 ERROR 报错的日志】
【其他附件:截图/日志/监控】
tidb 本身的监控信息是否有不正常的情况?
没有呀,日志也没有啥问题,所以就很奇怪,反映上去,因为不影响业务,也没人管
TiKV 日志(tikv.log)里面有没有记录错误吗
看截图和描述,大概率是监控采集的瞬时抖动,不是端口真的掉了。TiKV 的 20xxx/201xx 是 gRPC 和 status 端口,如果进程活着但监控抓取超时,就会误报。
建议这么排查:
metrics/ 的 Prometheus 抓取间隔,默认 15s,如果网络偶发延迟,可能刚好错过抓取窗口。先看看系统日志里面有没有什么异常
是不是网络不稳定,有没有丢包
端口还在却告警,先看你用什么探的。自写脚本 nc 的话,dmesg 里 grep conntrack,两台机器多实例混部很容易 nf_conntrack table full,瞬时建连就失败;Prometheus 的话看 up 的断点是不是卡在 scrape 超时。已有连接不受影响,所以业务无感。
多半是探针超时
这2个机器和监控的机器负载高吗?负载高的话可能会出现误报
查看下系统日志里有没有异常