一个好的问题描述有利于社区小伙伴更快帮你定位到问题,高效解决你的问题
【TiDB 使用环境】生产环境 /测试环境
【TiDB 版本】
【部署方式】云上部署(什么云)/机器部署
【操作系统/CPU 架构/芯片详情】
【机器部署详情】CPU大小/内存大小/磁盘大小
【集群数据量】
【集群节点数】
【问题复现路径】做过哪些操作出现的问题
【遇到的问题:问题现象及影响】
【资源配置】进入到 TiDB Dashboard -集群信息 (Cluster Info) -主机(Hosts) 截图此页面
【复制黏贴 ERROR 报错的日志】
【其他附件:截图/日志/监控】
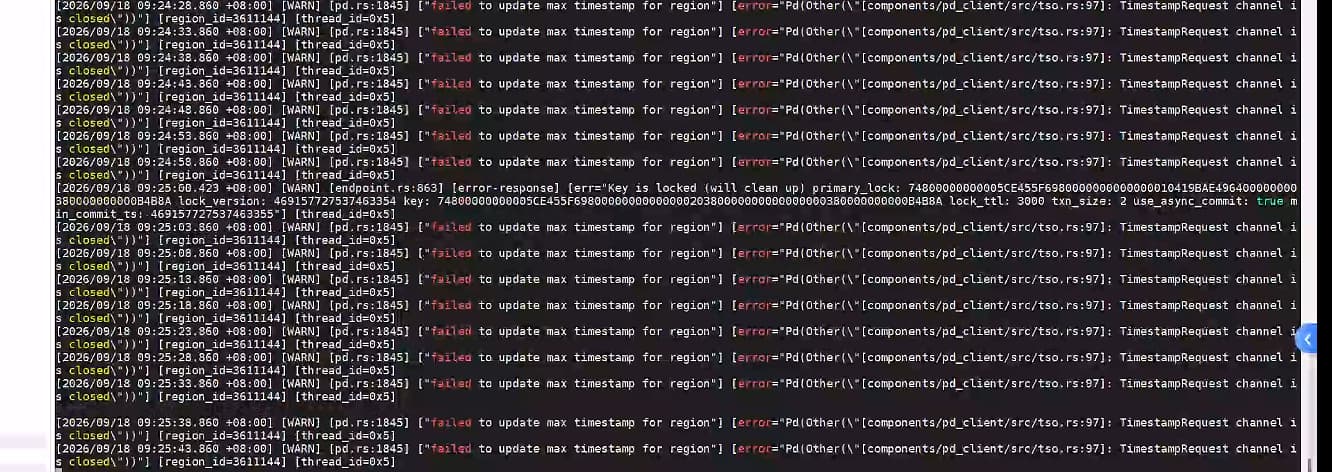
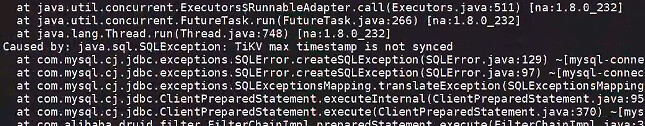
failed to update max timestamp for region
克里克里克
(Ti D Ber H052ej9m)
2
检查与pd的通信状态,pd是否正常,各个节点的时钟是否相同呢?
display 发现tikv掉线了一个,直接start tikv起不来,然后查看pd leader一直在迁移数据,将leader重启后,tikv启动正常,数据写入也正常了
不知道是不是触发啥bug了,只是掉线一个tikv,不应该影响业务写入的
克里克里克
(Ti D Ber H052ej9m)
5
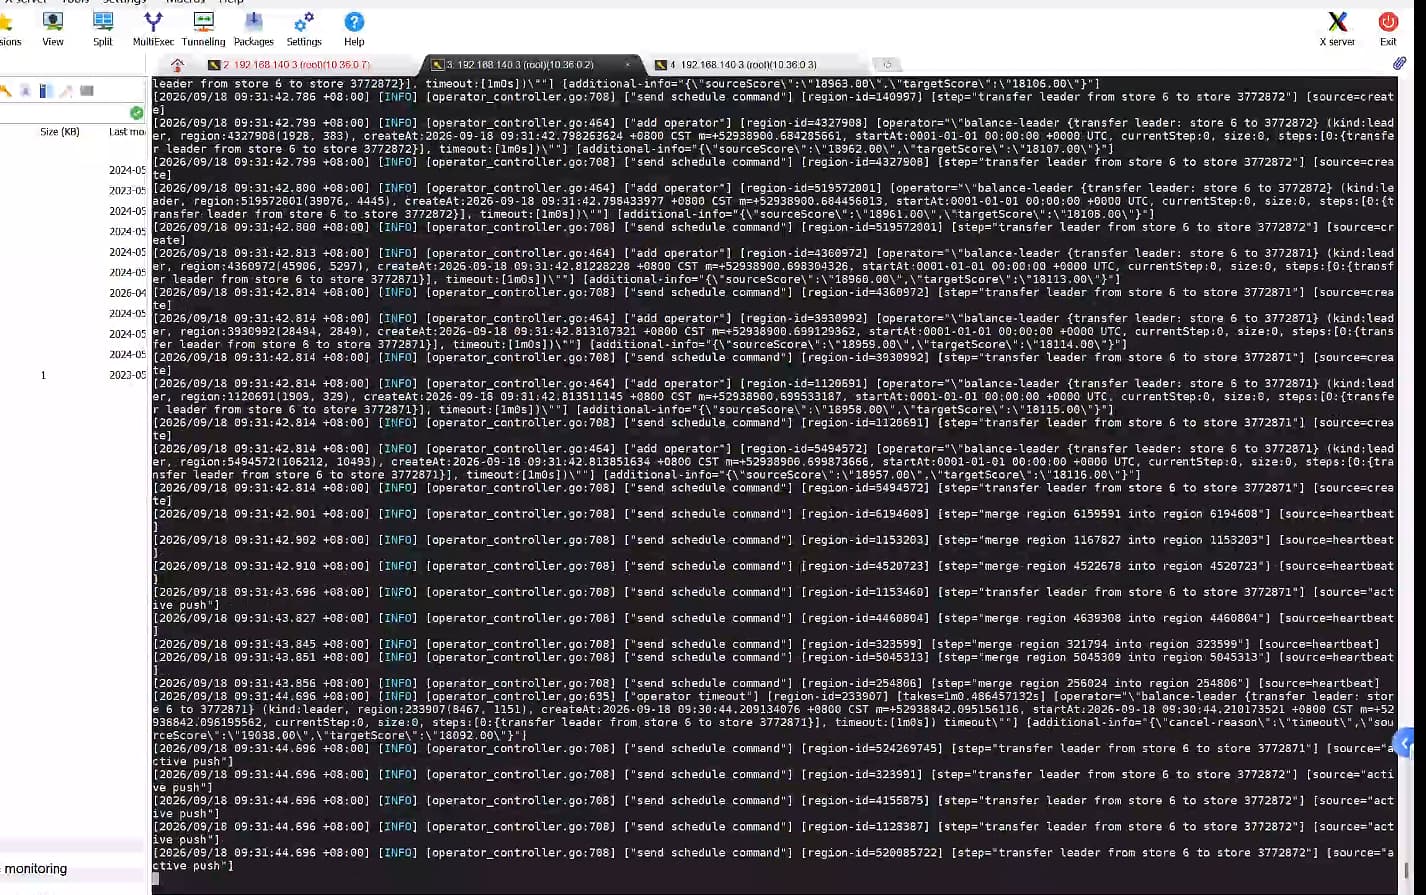
可以看看pd当时的日志以及负载,是不是也发生过切换,有可能是kv故障后,调度太多,pd资源被打满了??
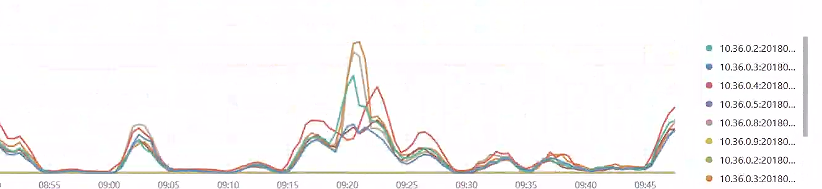
这是pdleader日志,看服务器资源io被打满了
克里克里克
(Ti D Ber H052ej9m)
7
pd要是有瓶颈了,肯定就是影响整个集群了,资源混布了?pd一般也没有太多IO的操作吧?
克里克里克
(Ti D Ber H052ej9m)
9
除非你的pd和kv混布了,那是有可能的,混布的话可以限制下调度的线程,宁可慢点,别跑死了。
要是单独部署的,就得看看pd资源打满是什么原因造成的了
wbslxw
(Ti D Ber Cl S0j Eng)
11
每个节点时间一致吗?感觉像是节点之间时间有偏差导致的
kang
14
这个报错一般是 PD 和 TiKV 之间的时间戳同步出了问题,常见原因有几个,可以按下面顺序排查:
-
先看 PD 和 TiKV 的时钟是否同步,建议所有节点都配好 NTP,timedatectl 看下时间偏差,超过几百毫秒就容易出这问题。
-
检查 PD 是否正常,pd-ctl -u http://pd:2379 member 看下 leader 状态,PD 频繁切主也会导致 max timestamp 更新失败。