【作品名称】如果数据库会说话——基于平凯 Loop × TiDB 的 AI 数据侦探
【选择的创作方向】使用场景呈现
【作品形式】AI 程序、视频、其他
【作品介绍/描述】
《如果数据库会说话》
——基于平凯 Loop × TiDB 的 AI 数据侦探
数据库里藏着大量信息:表、字段、数据、关系、标准和业务知识。但面对一个陌生数据库,人类往往需要花费大量时间理解“这张表是什么”“这个字段代表什么”“数据之间有什么关系”“哪些数据可以使用”。
如果数据库会说话,它会告诉我们什么?
《如果数据库会说话》就是一次关于这个问题的探索。
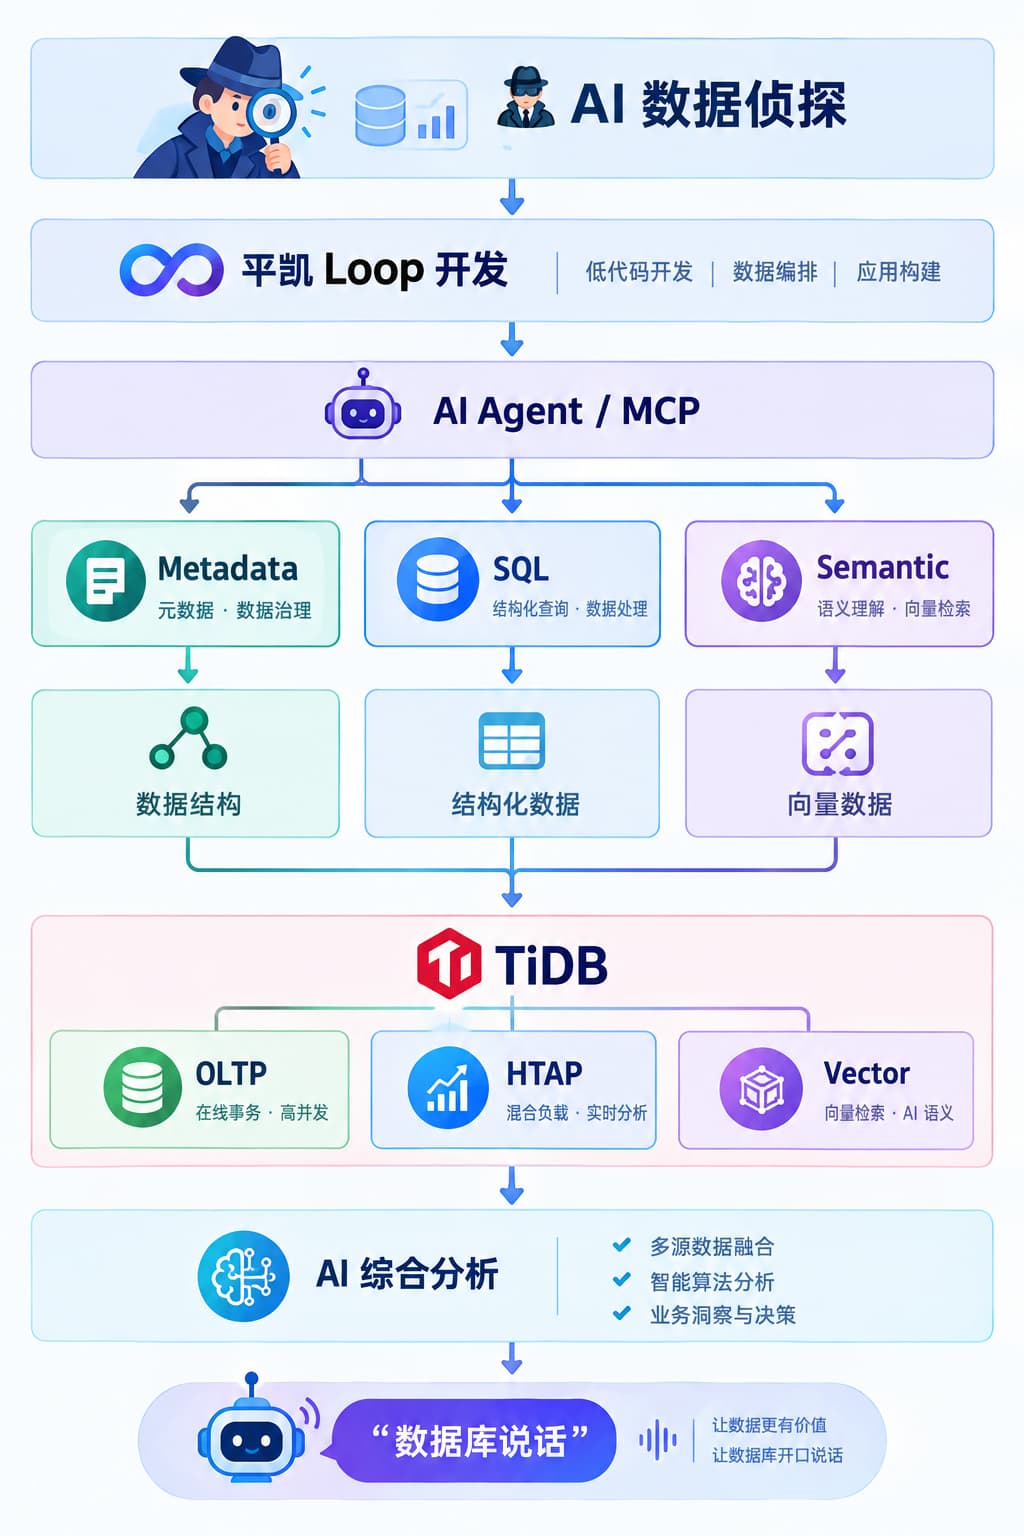
本作品使用平凯 Loop进行 AI 应用开发,以 TiDB 作为 AI 数据底座,尝试打造一个能够主动调查、理解和解释数据库的 AI 数据侦探。
用户只需要用自然语言提出问题,例如:
“帮我找出和糖尿病相关的数据。”
AI 数据侦探会像一个真正的“数据侦探”一样展开调查:首先发现数据库中的表和字段,理解数据结构;然后结合 TiDB 的 SQL 查询能力获取真实数据,通过向量搜索理解数据的语义,通过全文搜索和 Hybrid Search 查找相关信息;进一步分析数据之间的关系、发现数据质量问题,并最终将复杂的数据调查结果转换成人类能够理解的自然语言。
作品重点探索 “AI 如何真正用数据”,而不仅仅是让大模型生成一段回答。
在实践过程中,我们将数据库中的信息拆解为:
Metadata → SQL → Vector → Semantic → AI Agent
让 AI 同时理解“数据是什么”和“数据里有什么”。
其中,TiDB 承担 AI 数据底座的角色,将结构化数据、向量数据和分析能力结合起来;平凯 Loop 则帮助开发者快速完成从想法、原型到 AI 应用的迭代,让“做一个 AI 数据侦探”的想法能够快速变成可以运行和验证的真实应用。
作品还特别记录了使用平凯 Loop 的探索过程:从最初连接数据库、读取元数据,到让 AI 理解字段,再到实现 Text-to-SQL、向量检索、Hybrid Search 和数据分析。在不断试错和迭代的过程中,我们希望探索一个问题:
当 AI 不再只是“生成内容”,而是开始真正理解、查询和分析企业数据时,数据库会不会成为 AI 最重要的“知识来源”之一?
最终,我们希望通过这个作品表达一个简单的想法:
过去,是人类学习如何理解数据库;未来,也许可以让 AI 先去理解数据库,再把数据库讲给人类听。
这就是我们的 AI 数据侦探。
让数据库从“沉默的数据仓库”,变成一个能够被 AI 理解、调查和讲述的“数据世界”。
【作品链接/文件】
网页Demo:https://wzw.simmed.cn/