双区域多 AZ 架构,如果AZ1挂了,应用跑AZ2,这时候AZ2和AZ3的延迟比较大,比如距离很长,延迟有20MS左右,这时候,如果生产库性能要求很高的话,会影响生产库么
20ms 的延迟很低了… 如果是全球场景动不动就 200ms 以上的延迟
如果带宽不足,可能才是核心问题。凡是 TiDB 场景的服务,数据量基本都是超大
AZ1坏了,5副本,那日志要成功传到AZ3才可以算成功,这时候延迟20MS,应该很影响生产业务了吧
这个要看服务是不是也支持 AZ 自由转移,并且南北流量的转移也支持
或者说,AZ 所有的区域都有服务能合理的平衡流量和资源调度
不是很明白,现在坏了2副本,要3副本都写成功,才算成功吧,现在AZ2和AZ3延迟20MS,这种应该很影响性能了吧
我理解的是多区域多AZ本身就是针对灾备场景来的,是保证可用性,对性能一定是有影响的,同城和跨城的网络延时也是不同的。
而且,真故障了,是不是也可以调整副本数的。
如果这样的话,对于性能要求高的场景,好像可用性还是无法保证了吧。。。我也在想这个问题,如果调整成3副本的话,就应该是没有网络延迟影响了。。。
正常情况下leader都在同城,异常情况下就需要其他的相应的一整套故障处理流程,恢复故障机房,通常机房扩容等等。
而且真要搞的好,可能应用的入口不止是在AZ1的,AZ2也跑一部分等等。
亚马逊、阿里这种量级的也没说故障后一点波动也没有吧。。
就是要防止非正常情况,比如AZ1和AZ2网络断了,AZ1机房挂了,AZ2机房挂了,这时候,这个架构,是否能对应用无影响
是否对应用无影响,这应该是一整套故障处理流程来保证的,不止数据库,应用的调整、暂时限流等等。
不可能说机房挂了,后续什么也不做就靠数据库顶着。
我理解在机房故障这种层面,只考虑数据库,没有哪种数据库能确保对应用无影响,都会波动的,而且影响也会一直存在。
1 个赞
现在只考虑数据库层面
是的,1个az坏了大概率会影响用户体验,并且这种情况单靠库的高可用无法对应,需要服务、库、负载均衡等多方面综合对应,并且需要人为介入的
那应该没有哪家敢宣称只靠数据库就能顶得住吧,分布式的数据库原理都差不多。
只靠数据库的话,故障后,积累的应用的流量瞬间打过来,可能就打死了。
一定需要人为介入的,能保证影响范围短。
1 个赞
跨 AZ 的写延迟基本躲不掉。TiDB 一份数据 3 副本,写要过半(2 个副本)确认了才算提交:AZ1 正常的时候 leader 和第二个副本都在同城、低延迟,那个 20ms 的 AZ3 不怎么拖后腿;AZ1 一挂 leader 挪到 AZ2,最近的过半就成了 AZ2+AZ3,每笔写都得等这 20ms,写延迟肯定涨。这跟哪家分布式库都一样,Raft 过半的硬要求摆在那。想压延迟,可以按 label 用 Placement Rules 把多数副本摆在同城两个 AZ,远的那个 AZ 只做异步灾备、走 TiCDC 同步,别把 Raft 硬拽到高延迟区;读这边还能开 follower read / stale read 绕开跨城延迟。真要是两个 AZ 一起挂,剩一个副本不到过半,写会直接停、只能等恢复,双机房级容灾得把副本铺到更多故障域,或者干脆上双集群。
双集群是什么概念?
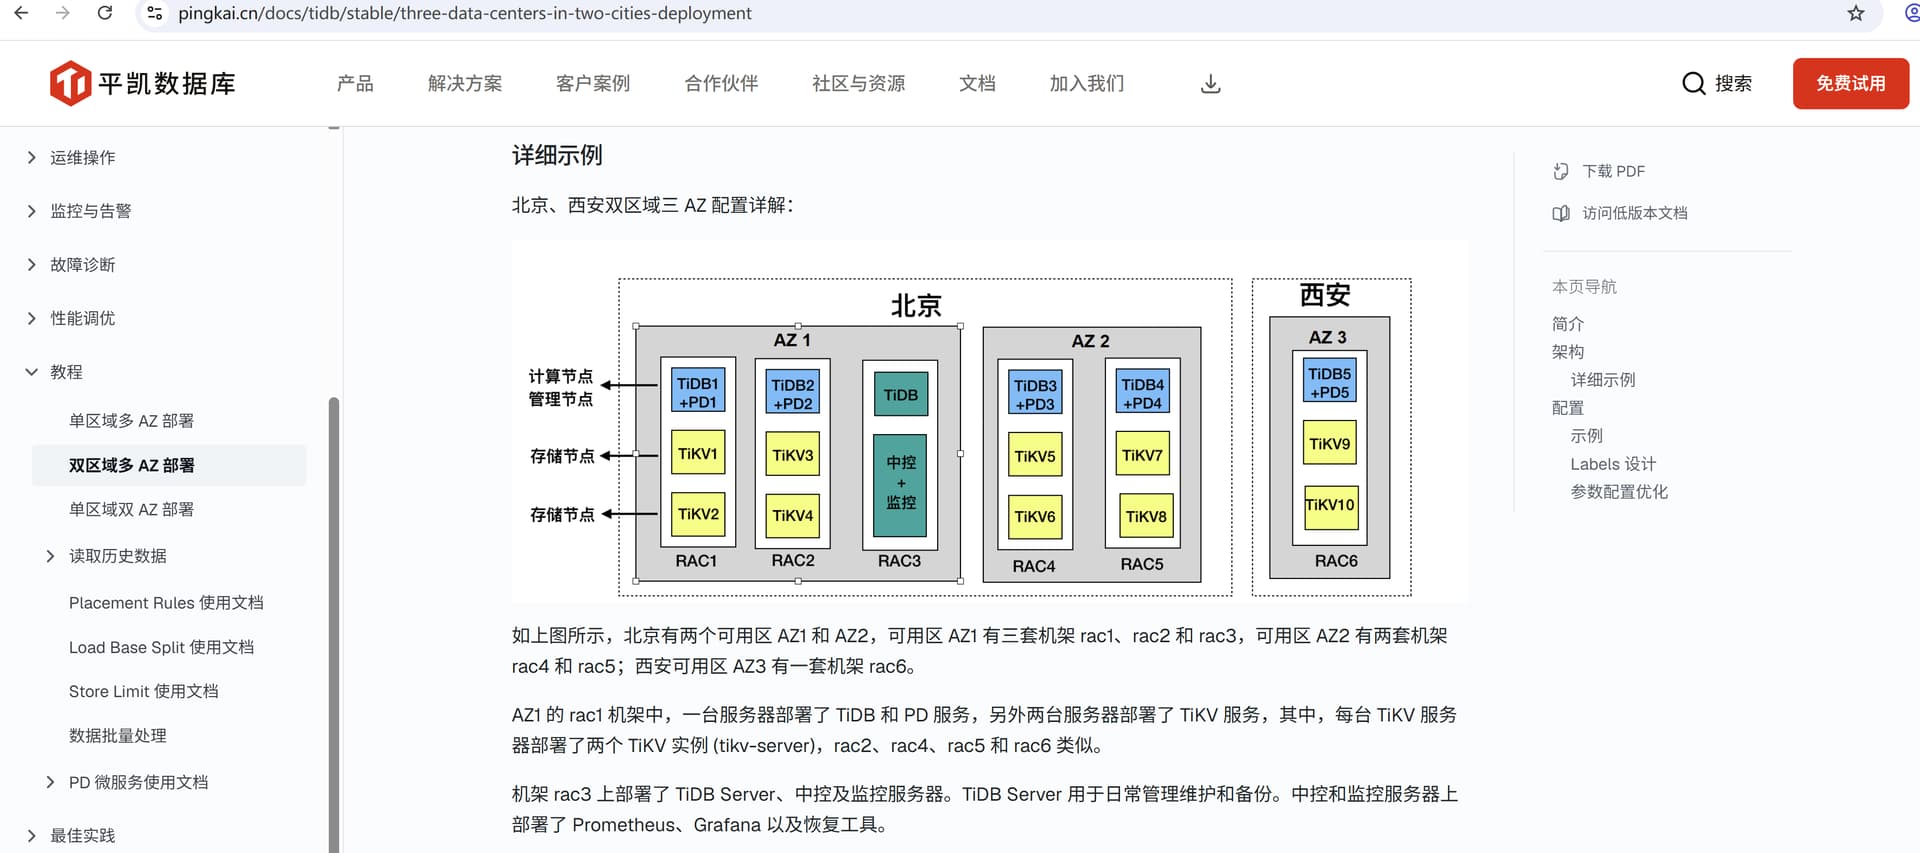
文档是 3AZ 5副本
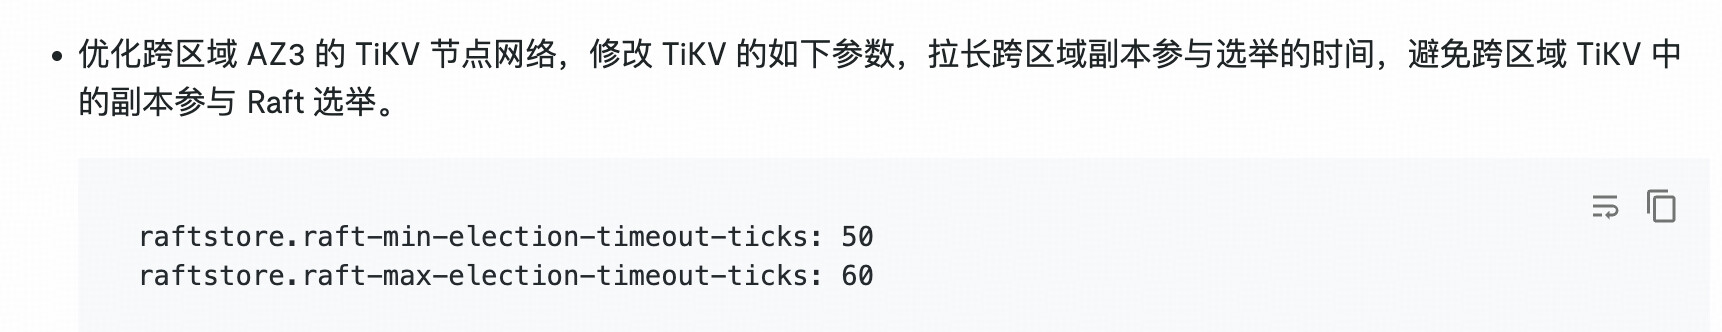
AZ3 正常情况下应该没有 leader
AZ1 故障前
AZ1 2 副本 + AZ2 2 副本 已满足 raft 多数
AZ1 故障后
AZ2 2 副本 + AZ3 1 副本 才满足 raft 多数,写必须跨 AZ3 延迟升高,读在 AZ3 没有 leader 的前提下可以只发生在 AZ2 应该不受影响
你这个就是文档里面说的了,理解了。。。。但是只要AZ1或者AZ2坏了,跨AZ3延迟都会影响业务性能了吧
就是有两个集群,有些 3AZ 是在同个集群的不同节点实现,比如 单个集群跨区,
有些容灾是同个 同城多中心,比如同城不同 az 用2套集群来实现
有些是多城多中心,比如在上海和苏州 有2个 tidb 集群,跨区同步
跨城市的2个集群,同步数据怎么处理?也会有一定的延迟吧?
AZ1 挂了必涨:5 副本过半是 3,AZ2 的 2 + AZ3 的 1 正好卡在过半,写都得等那 20ms。还有两笔时间账没人算:raft 选主默认 10~20s,PD 要等 max-store-down-time 默认 30min 才补副本。跨城双集群走 TiCDC,RPO 不是 0。