TiKV是否掉线了;
看看异常节点的IO情况;
看看store score;
看看Scheduler show;
一般突然间掉没了可能就是PD认为TiKV挂掉了。
tikv在线 Scheduler show 上只显示两个节点
只显示两个节点就是不在线了吧,tiup cluster display xxx 和 dashboard 里都看看集群状态呢
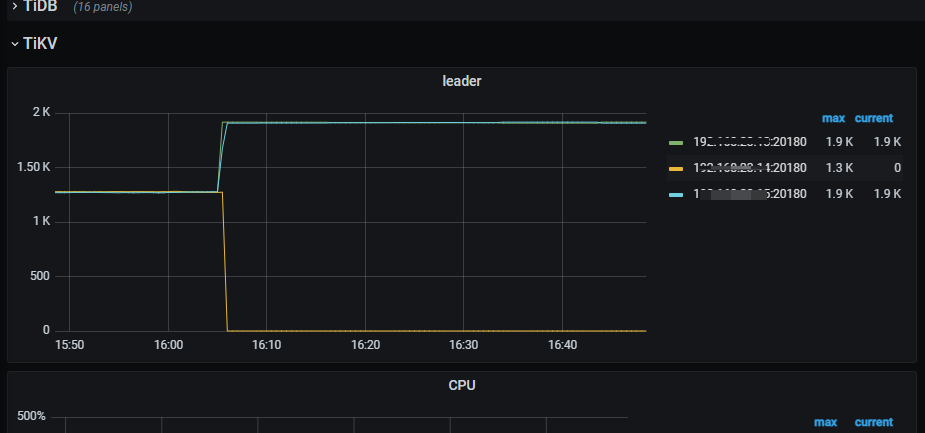
先在 pd-ctl 里跑 store 看第三个 store 的 state 和 last_heartbeat 还更不更新,这是判断的关键。你图上这个 leader 归零、另外两个节点也没涨,说明那一千多个 leader 不是被重新选走了,是整个 store 在 PD 眼里没了,基本不是慢节点或单点抖动,而是心跳断了或者 store 已经 offline/tombstone 了。
再上这台 TiKV 本地看 20180 的 metrics,tikv_raftstore_region_count 里本地还有 leader 而 PD 里是 0,那就是 TiKV 到 PD 的心跳网络问题,顺手确认下 pd 地址和防火墙。本地也是 0 就往磁盘和日志查,df -h 看盘满不满、iostat 看有没有 IO hang,tikv.log 里搜 region 相关报错,顺便看看 16:05 前后这台机器有没有重启、时间跳变或者做过缩容。
真救不回来就新机器扩一个 TiKV,等 region 补齐再 store delete 把坏的缩掉,别在原机器上反复折腾。
简单一点 可以通过先扩容在缩容来解决下,这样子会重新选举 leader 重新均衡
这个leader归零了,其余两个节点的leader是增长了的,过段是时间后此节点会恢复正常,这种情况每天都会出现,没有特别的规律,而且可能今天是这个节点,明天又会是另一个节点,三个节点都会出现这种现象
有可能就是机器短暂hang了或者心跳没了,但是很快恢复,所以kv也没重启
传日志吧。光靠一张图都是猜。
 感觉怎么这么像断网
leader 是 PD 主动迁走的,不是心跳断:evict-slow-store-scheduler 是默认调度器,判慢后给 store 打 evict-leader,leader 就掉 0
是的,通过日志查看是pd将tikv判定是慢节点,然后将leader转移到其他两个节点上了,我现在在找被判定为慢节点的原因,能给提供一些方向吗?
raftstore 每 100ms 探一次自己的延迟(inspect-interval),一次超过 100ms 记一次超时,超时率过 10% 就按 AIMD 把 slow score 翻倍,满 100 才随心跳上报 PD 去驱逐。所以去拉那台的 tikv_raftstore_slow_score 曲线,跟 Raft IO 的 append/commit/apply 耗时对齐看,多半是盘抖。
补一句,我前面是按「store 从 PD 眼里消失」判的,你这边实测是 evict-slow-store 把 leader 全迁走了、节点本身还是 up 的,这个更正一下。
找慢的原因先看 tikv_raftstore_slow_score 什么时候开始涨,再把那一刻跟 Raft IO 的 append、apply 耗时对齐。append 的 99 分位同时起跳基本就是盘,看 iostat 的 await/util,云盘 IOPS 打满、写缓存策略、坏盘都会这样;append 正常但 apply 高,多半是 CPU 被抢或者 compaction 撞上来,看 write stall duration 和 compact pending;两个都正常但心跳慢,那就是网络丢包,对一下这台机器到 PD、到另外两个 TiKV 的 RTT。
还有你说三个节点轮流出现、每天都来,这个特征更像周期任务把单台打满,对一下 slow score 起跳时间是不是固定的,比如备份窗口、整点 analyze、大查询或者监控采集,再把三个节点的 tikv.log 同一时段拉出来比一比,里面有 is slow 和 inspect 的打点。
倾向于网络问题
是不是tikv出现write stall了