
TiDB 的 pandas 数据分析实战案例
适用环境:Python 3.10+ / pandas 2026.x / TiDB v8.5.3 Serverless(MySQL 协议)
1️⃣ 开篇引言
💬 "pandas 我懂一点,SQL 也会一点,但它们怎么连起来用?"
如果你也有这个疑问,这篇文章就是为你准备的。
学完这篇,你能掌握:
- 用 Python 一行代码连上 TiDB(分布式 MySQL 兼容数据库)
- 把数据库里的订单表读成 pandas DataFrame
- 做分组聚合、排名、时间序列、缺失值处理
- 再把分析结果写回 TiDB
- 完整闭环:读 → 洗 → 算 → 存
为什么选 TiDB 来练手?
- 它兼容 MySQL 协议,所以 pandas 连 MySQL 的那套代码直接能用
- 弹性扩展,数据从几千行涨到几亿行,代码几乎不用改
- 免费 Serverless 版本,注册个账号 5 分钟就能在云端跑起来,不用本地装数据库
适用场景:电商订单分析、用户行为报表、财务对账、运营看板……凡是有「业务数据 + 分析需求」的地方都能用。
2️⃣ 知识点通俗讲解
2.1 一句话搞懂三者关系
TiDB 是「仓库」:负责把数据安全存好 pandas 是「厨师」:负责把数据加工成你要的样子 SQLAlchemy + PyMySQL 是「传送带」:把仓库里的货搬到厨房
整个流程就是:厨师(pandas)通过传送带(SQLAlchemy)从仓库(TiDB)取料,加工完再送回仓库。
2.2 类比:餐厅出菜
- TiDB 相当于后厨的 大冰箱,里面冻着各种原材料(表/数据)
- pandas 相当于 案板 + 刀,切、炒、炖都行
pd.read_sql()就是 取菜:把冰箱里的菜端到案板上df.to_sql()就是 回库:把加工好的半成品送回冰箱
核心思想:让数据库做它擅长的(存 + 筛选 + 关联),让 pandas 做它擅长的(灵活变换 + 统计可视化),各司其职。
3️⃣ 核心语法 / 规则详解
3.1 连接 TiDB 的三种姿势(推荐第一种)
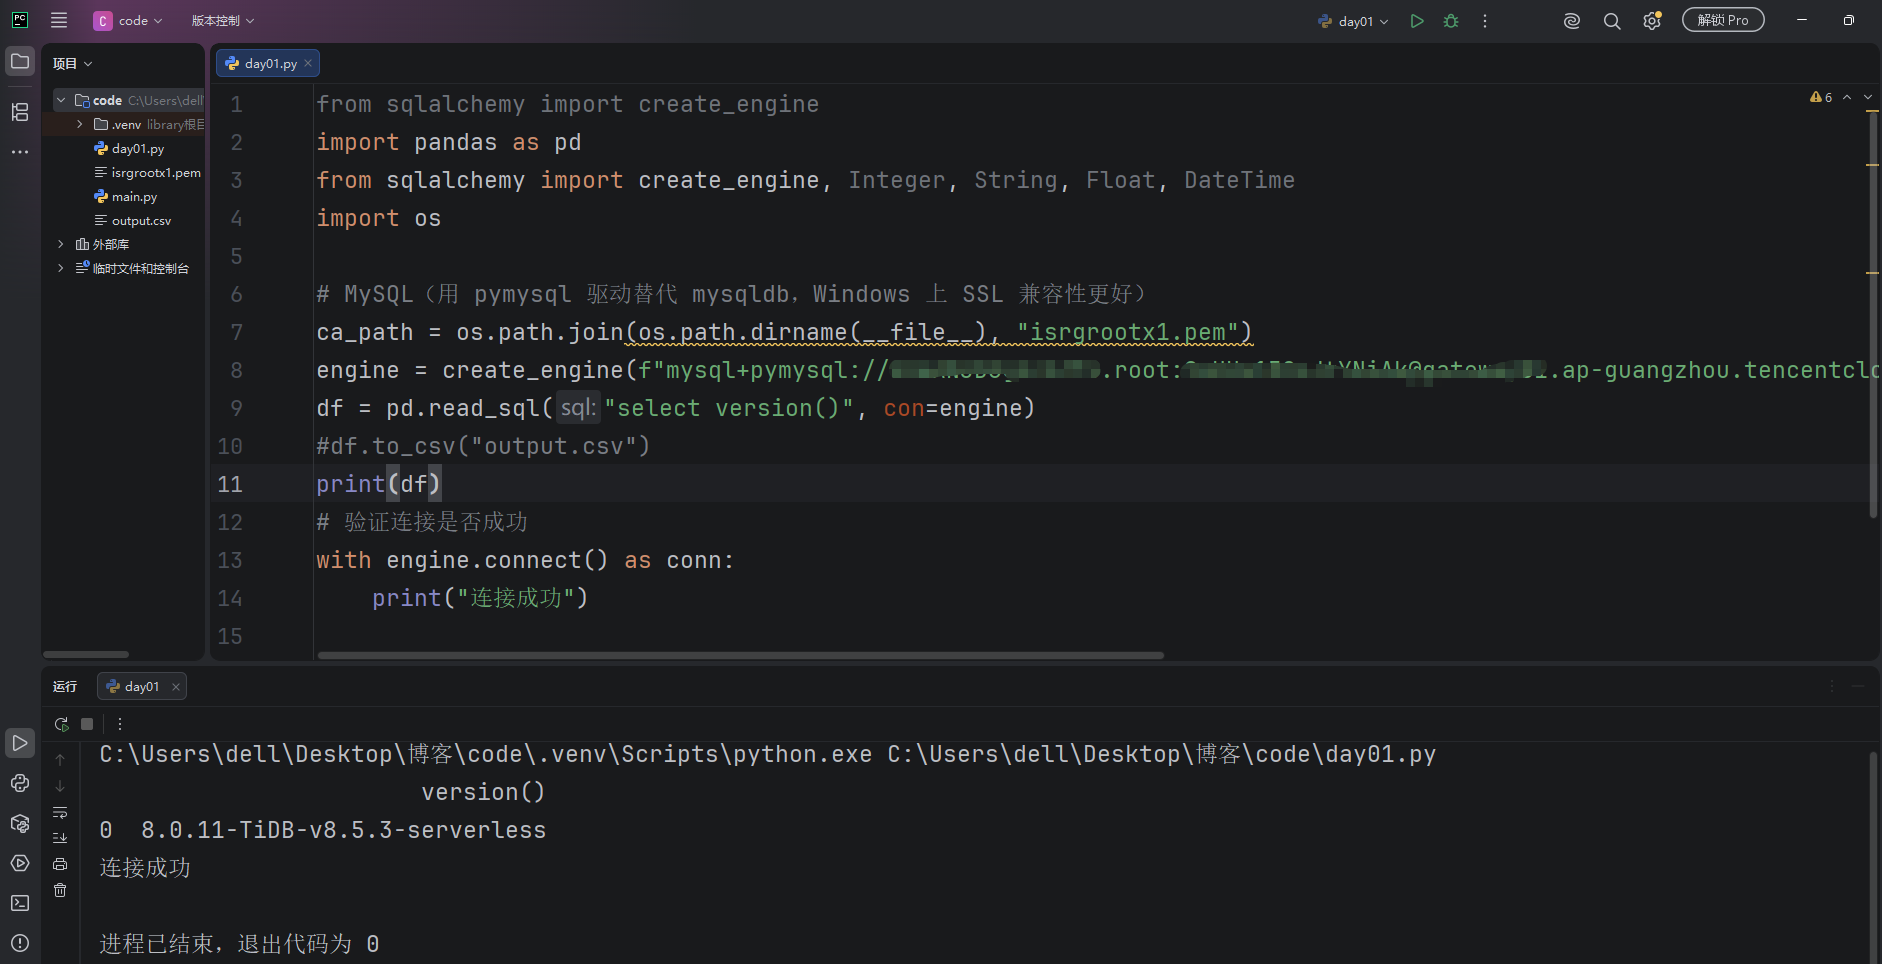
# ✅ 姿势一:SQLAlchemy + PyMySQL(pandas 官方推荐)
# MySQL(用 pymysql 驱动替代 mysqldb,Windows 上 SSL 兼容性更好)
ca_path = os.path.join(os.path.dirname(__file__), "isrgrootx1.pem")
engine = create_engine(f"mysql+pymysql://XXX.root:XXX@gateway01.ap-guangzhou.tencentcloud.pingkai.cn:4000/sys?ssl_ca={ca_path}&ssl_verify_cert=true&ssl_verify_identity=true")
df = pd.read_sql("select version()", con=engine)
#df.to_csv("output.csv")
print(df)
# 验证连接是否成功
with engine.connect() as conn:
    print("连接成功")
# ✅ 姿势二:带 TLS 加密(TiDB Serverless 公网访问必须)
URL = ("mysql+pymysql://user:pwd@gateway01.ap-southeast-1.prod.aws.tidbcloud.com:4000/test"
       "?ssl_verify_cert=true&ssl_verify_identity=true")
engine = create_engine(URL)
# ⚠️ 姿势三:直连 PyMySQL(不推荐,pandas 会报警告)
import pymysql
conn = pymysql.connect(host='...', user='...', password='...', database='...')
df = pd.read_sql("SELECT * FROM t", con=conn)  # 会有 FutureWarning
重点:
- 用
create_engine构造连接,pandas 才能稳定使用 - TiDB Serverless 默认 TLS 强制,公网访问必须加
ssl_verify_cert=true - 端口固定是 4000(不是 MySQL 的 3306)
3.2 读数据三板斧
# 测试数据
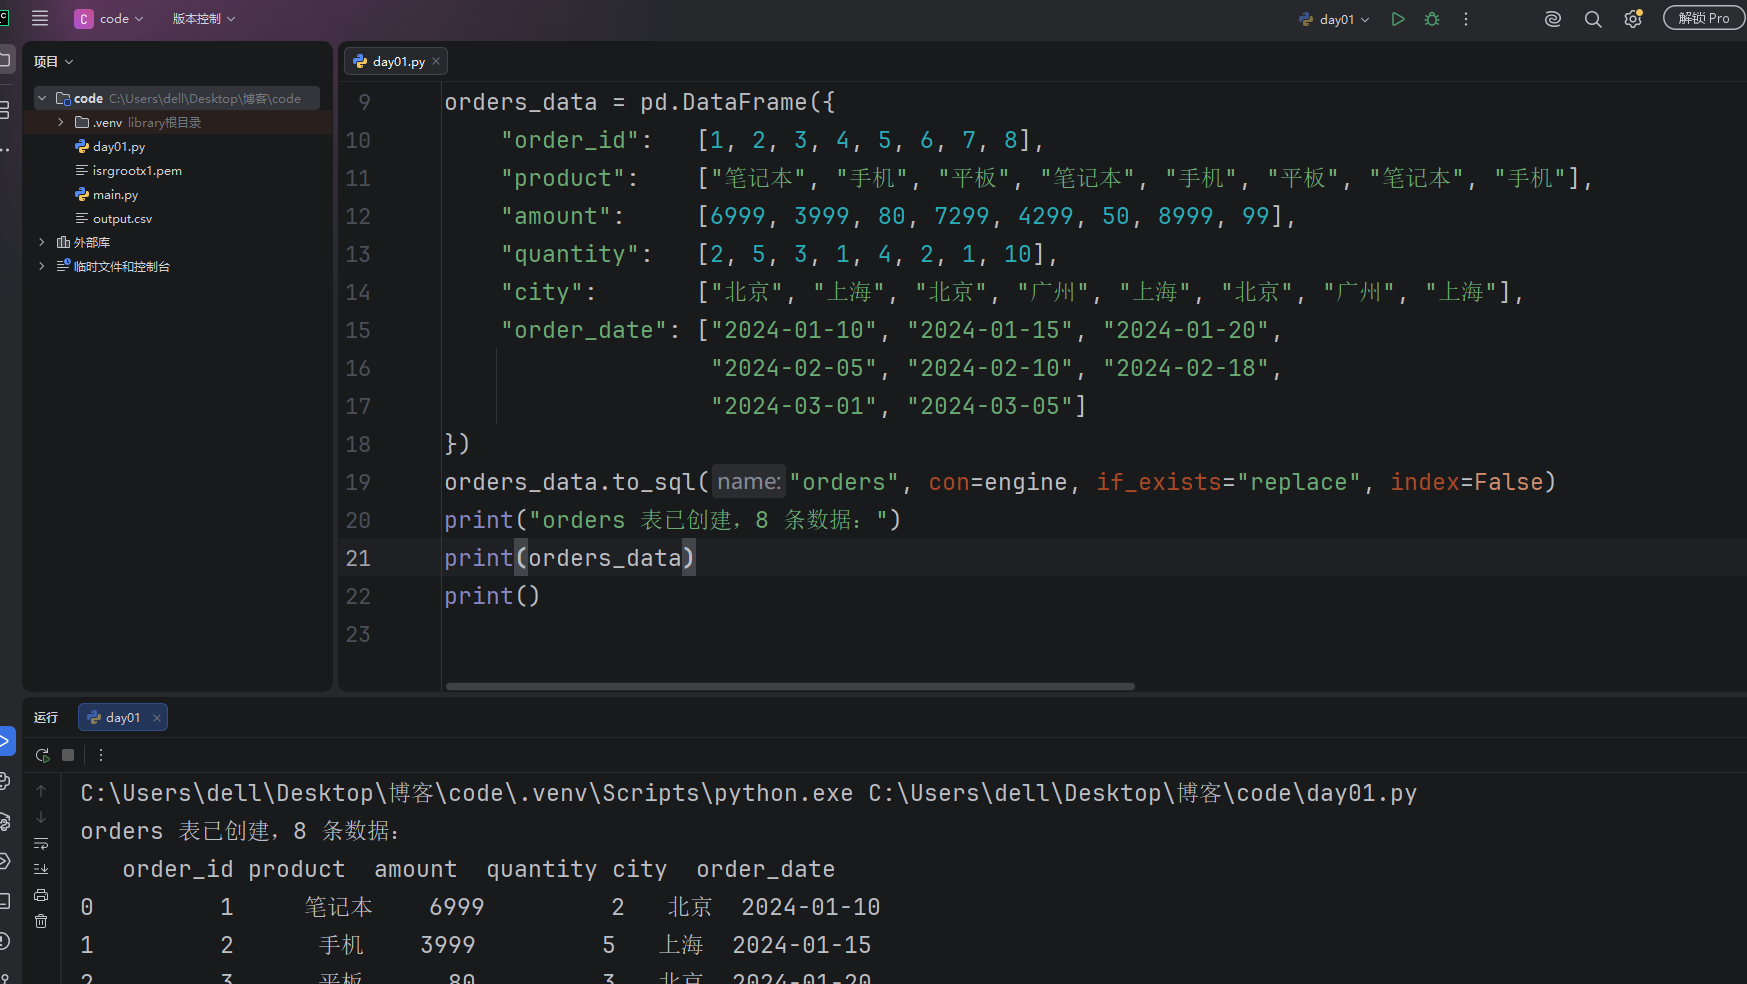
orders_data = pd.DataFrame({
    "order_id":   [1, 2, 3, 4, 5, 6, 7, 8],
    "product":    ["笔记本", "手机", "平板", "笔记本", "手机", "平板", "笔记本", "手机"],
    "amount":     [6999, 3999, 80, 7299, 4299, 50, 8999, 99],
    "quantity":   [2, 5, 3, 1, 4, 2, 1, 10],
    "city":       ["北京", "上海", "北京", "广州", "上海", "北京", "广州", "上海"],
    "order_date": ["2024-01-10", "2024-01-15", "2024-01-20",
                   "2024-02-05", "2024-02-10", "2024-02-18",
                   "2024-03-01", "2024-03-05"]
})
orders_data.to_sql("orders", con=engine, if_exists="replace", index=False)
print("orders 表已创建,8 条数据:")
print(orders_data)
print()
import pandas as pd
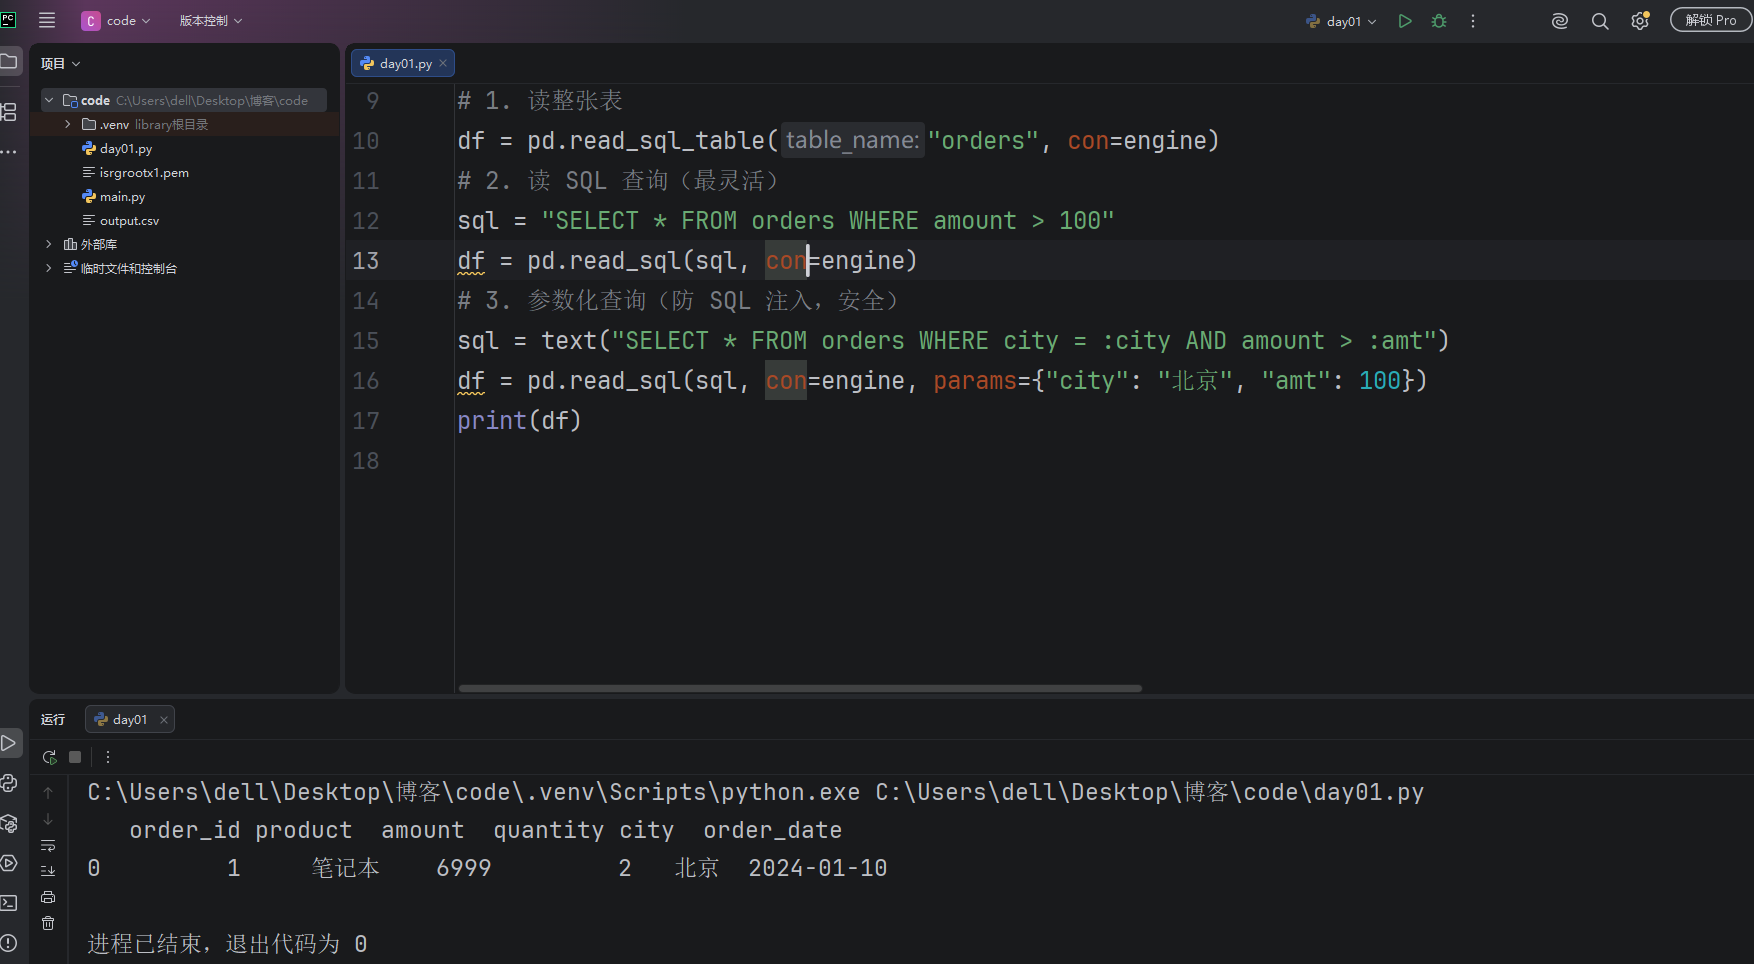
# 1. 读整张表
df = pd.read_sql_table("orders", con=engine)
# 2. 读 SQL 查询(最灵活)
sql = "SELECT * FROM orders WHERE amount > 100"
df = pd.read_sql(sql, con=engine)
# 3. 参数化查询(防 SQL 注入,安全)
from sqlalchemy import text
sql = text("SELECT * FROM orders WHERE city = :city AND amount > :amt")
df = pd.read_sql(sql, con=engine, params={"city": "北京", "amt": 100})
3.3 写数据一句话
df.to_sql(
    name="orders_summary",   # 目标表名
    con=engine,
    if_exists="replace",     # fail/replace/append 三选一
    index=False,             # 不写索引(通常保持 False)
    chunksize=1000           # 分批写入,防止一次性撑爆内存
)

if_exists 三种取值:
"fail":表已存在就报错(安全)"replace":删了重建(慎用)"append":追加进去(最常用)
4️⃣ 完整实战代码案例
🎯 场景:一家小电商想分析最近一周的订单——按城市统计销量、找出 Top 客户、按小时看订单趋势、最后把结果写回 TiDB。
4.1 第 0 步:先在 TiDB 建好测试数据
-- 在 TiDB 里执行这段 SQL,建个订单表
CREATE TABLE orders (
order_id INT PRIMARY KEY AUTO_INCREMENT,
customer_id INT NOT NULL,
city VARCHAR(50) NOT NULL,
amount DECIMAL(10,2) NOT NULL,
product VARCHAR(100) NOT NULL,
order_time DATETIME NOT NULL
);
-- 插入 12 条样例数据
INSERT INTO orders (customer_id, city, amount, product, order_time) VALUES
(1001, '北京', 299.00, '蓝牙耳机', '2026-09-28 09:15:00'),
(1002, '上海', 1299.00, '平板电脑', '2026-09-28 10:30:00'),
(1003, '广州', 599.00, '智能手表', '2026-09-28 14:20:00'),
(1001, '北京', 199.00, '手机壳', '2026-09-29 08:50:00'),
(1004, '深圳', 3999.00, '笔记本电脑', '2026-09-29 11:10:00'),
(1002, '上海', 899.00, '键盘鼠标套装', '2026-09-29 16:45:00'),
(1005, '成都', 499.00, '智能音箱', '2026-09-30 10:00:00'),
(1003, '广州', 1299.00, '平板电脑', '2026-09-30 13:30:00'),
(1006, '北京', 599.00, '智能手表', '2026-10-01 09:40:00'),
(1001, '北京', 3999.00, '笔记本电脑', '2026-10-01 15:20:00'),
(1007, '杭州', 299.00, '蓝牙耳机', '2026-10-02 11:15:00'),
(1002, '上海', 199.00, '手机壳', '2026-10-02 17:00:00');
4.2 Python 代码完整实现
import pandas as pd
import os
from sqlalchemy import create_engine, text
# MySQL(用 pymysql 驱动替代 mysqldb,Windows 上 SSL 兼容性更好)
ca_path = os.path.join(os.path.dirname(__file__), "isrgrootx1.pem")
engine = create_engine(
"mysql+pymysql://XXX:XXX@gateway01.ap-guangzhou.tencentcloud.pingkai.cn:4000/test",
connect_args={"ssl": {"ca": ca_path}},
)
# 验证连接是否成功
with engine.connect() as conn:
print("连接成功")
# ================== 第二部分:读取数据 ==================
sql = "SELECT * FROM orders"
df = pd.read_sql(sql, con=engine)
# 把 order_date 转成 datetime,方便做时间运算
df["order_date"] = pd.to_datetime(df["order_date"])
print(f"📥 读到 {len(df)} 行订单数据:")
print(df.head())
# ================== 第三部分:数据分析(5 个常用操作) ==================
# ---- 分析 1:按城市统计订单数和总销售额 ----
city_stats = (
df.groupby("city")
.agg(order_count=("order_id", "count"),
total_amount=("amount", "sum"),
avg_amount=("amount", "mean"))
.round(2)
.sort_values("total_amount", ascending=False)
.reset_index()
)
print("\n📊 城市销售排行:")
print(city_stats)
# ---- 分析 2:Top 产品(销售额 Top 3)----
top_products = (
df.groupby("product")["amount"]
.sum()
.sort_values(ascending=False)
.head(3)
.reset_index()
.rename(columns={"amount": "total_amount"})
)
print("\n🏆 Top 3 产品:")
print(top_products)
# ---- 分析 3:按月看订单趋势 ----
df["month"] = df["order_date"].dt.to_period("M").astype(str)
month_stats = df.groupby("month").size().reset_index(name="order_count")
print("\n⏰ 每月订单分布:")
print(month_stats)
# ---- 分析 4:找出「大单」订单(金额 > 1000)----
big_orders = df[df["amount"] > 1000].sort_values("amount", ascending=False)
print(f"\n💰 大单数:{len(big_orders)} 笔")
print(big_orders[["order_id", "product", "city", "amount"]])
# ---- 分析 5:计算每个城市占总销售额的比例 ----
total_sales = df["amount"].sum()
city_stats["ratio"] = (city_stats["total_amount"] / total_sales * 100).round(2)
print("\n📈 城市销售占比:")
print(city_stats[["city", "total_amount", "ratio"]])
# ================== 第四部分:结果写回 TiDB ==================
city_stats.to_sql("city_sales_summary", con=engine,
if_exists="replace", index=False, chunksize=500)
top_products.to_sql("top_products", con=engine,
if_exists="replace", index=False, chunksize=500)
print("\n✅ 分析结果已写回 TiDB")
5️⃣ 运行结果展示
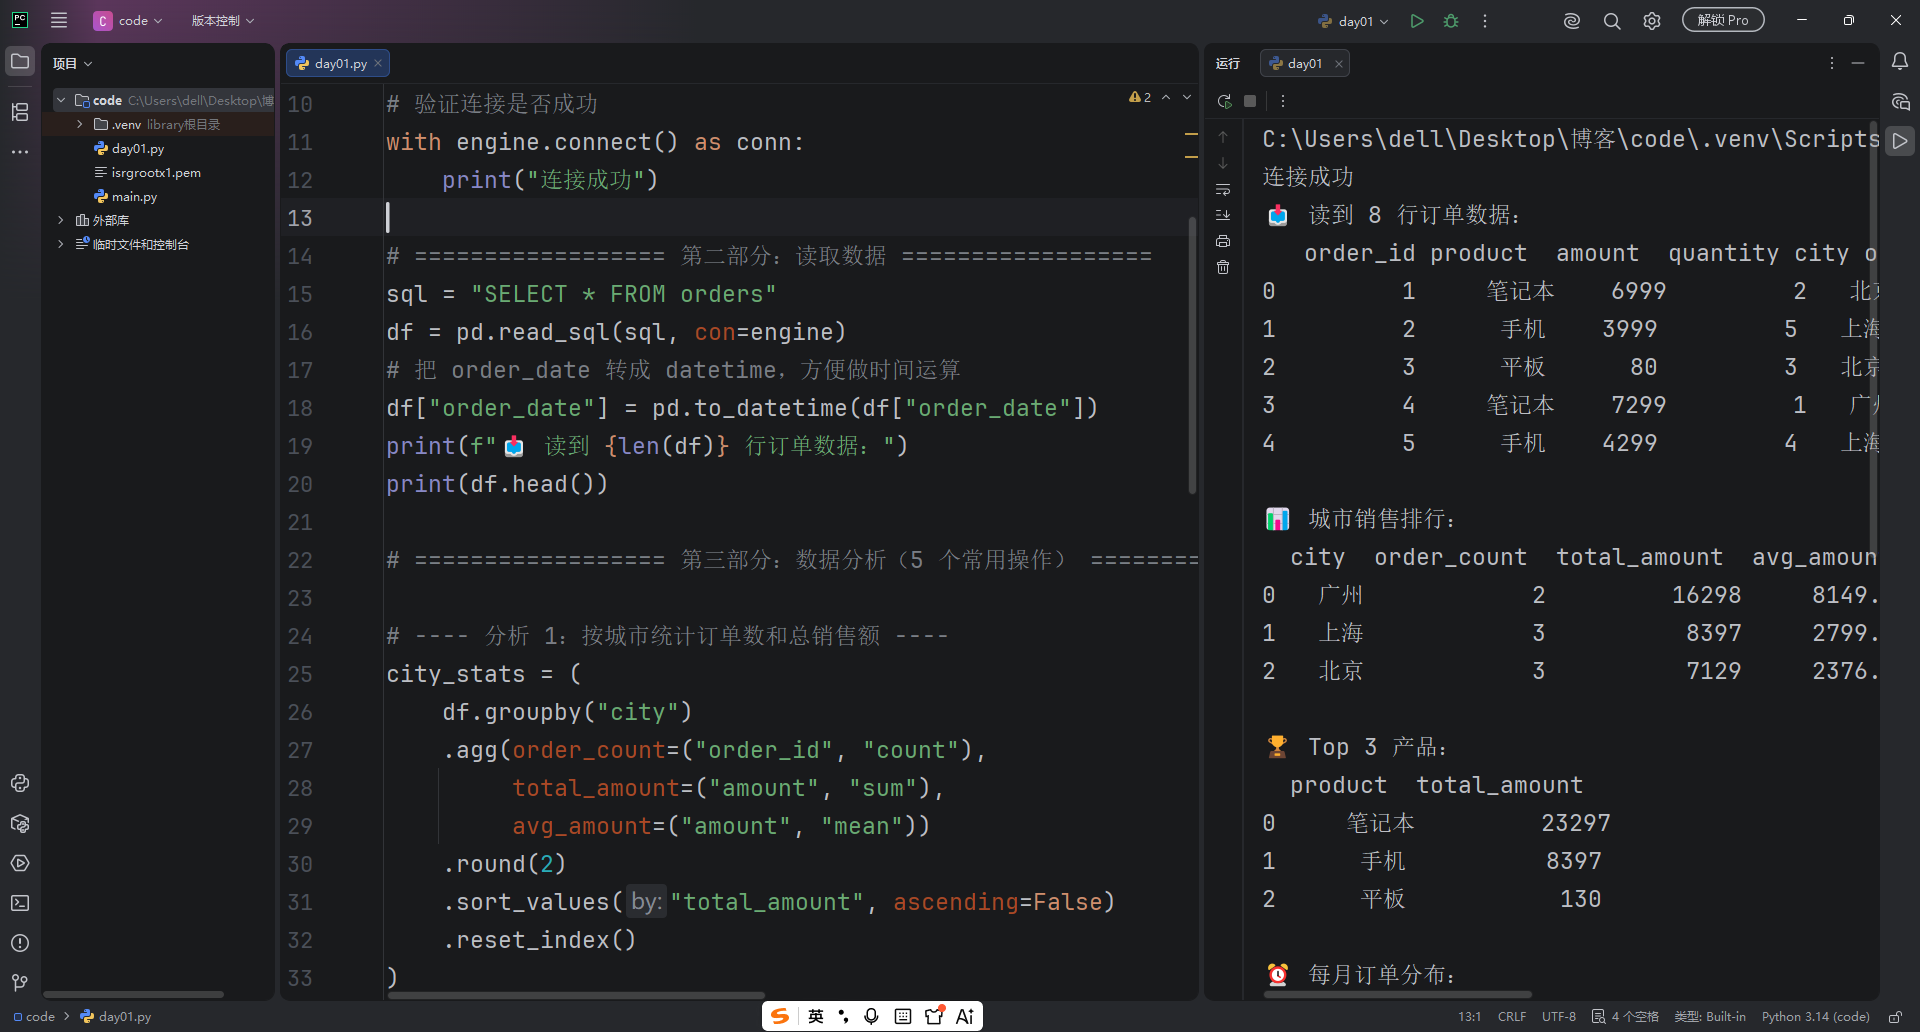

关键讲解:
groupby + agg是聚合的核心,一次可以算多个指标df["amount"] > 1000是布尔索引,相当于 WHERE 过滤dt.hour能直接抽出时间的小时部分,做时序分析必备to_sql会自动建表,第一次跑用 replace,后续用 append 更安全
6️⃣ 新手避坑指南(8 个常见坑)
🕳️ 坑 1:pandas 报警告 "only supports SQLAlchemy connectable"
原因:直接用了 pymysql.connect,pandas 不认这种连接 解决:必须用 create_engine() 包一层
🕳️ 坑 2:TiDB Serverless 公网连不上,报 TLS 错误
原因:TiDB Cloud 公网强制要求 TLS 解决:连接串加 ?ssl_verify_cert=true&ssl_verify_identity=true
🕳️ 坑 3:写入时报 table already exists
原因:默认 if_exists='fail' 解决:改成 if_exists='append'(追加)或 'replace'(覆盖重建)
🕳️ 坑 4:时间列读出来是字符串
原因:数据库存的是 DATETIME,pandas 默认可能当字符串读 解决:读取后立刻 pd.to_datetime(df["列名"]),或者 read_sql 加 parse_dates=["列名"]
🕳️ 坑 5:写入时中文乱码
原因:连接没指定字符集 解决:连接串末尾加 ?charset=utf8mb4
🕳️ 坑 6:大数据量内存爆了
原因:read_sql 一次性把表全读进内存 解决:用 chunksize=10000 分块读取,返回迭代器,分批处理
🕳️ 坑 7:密码里带特殊字符(如 @)
原因:URL 里 @ 有特殊含义 解决:用 urllib.parse.quote_plus(password) 转义,或把密码放环境变量
🕳️ 坑 8:pandas 索引被写进数据库变成一列
原因:默认 index=True 解决:绝大多数情况用 index=False
7️⃣ 核心知识点总结
口诀背起来 🔥
连库用 engine,读表用 read_sql 分组 groupby 配 agg,过滤用布尔索引 时间 dt 抽小时,to_sql 写回库 Serverless 必 TLS,chunksize 防爆内存
核心要点清单:
| 操作 | 一句话 |
|---|---|
| 建连接 | create_engine("mysql+pymysql://...") |
| 读表 | pd.read_sql(sql, con=engine) |
| 读表 | pd.read_sql_table("表名", con=engine) |
| 写表 | df.to_sql(name, con, if_exists, index=False, chunksize=...) |
| 分组聚合 | df.groupby("列").agg(新列=("旧列", 函数)) |
| 时间处理 | df["t"].dt.hour / dt.date / dt.dayofweek |
| 布尔过滤 | df[df["金额"] > 1000] |
| 参数化查询 | pd.read_sql(text(sql), params={"x": 1}) |
TiDB 在数据分析场景的 3 大优势:
- 弹性扩展:数据从几万行涨到几亿行,架构不用改
- 水平分区:大表自动切分,查询不会越来越慢
- HTAP 能力:交易分析一体,不用把数据搬到另一个系统