
一、向量与相似度:机器如何理解"像不像"
1.1 为什么计算机不能直接比较"相似"
先做一个生活实验:哈密瓜更像西瓜,还是更像篮球?
你几乎不假思索就能回答:更像西瓜(几何上、功能种类上)。
但机器面对一张哈密瓜的照片、一段"哈密瓜"的文字,它只是看到了一堆像素、一堆字符——它根本不知道"甜"是什么、"水果"意味着什么。计算机无法原生理解"谁像谁"。
所以要迈出的第一步非常朴素:把"相似"这件事,翻译成数字。让"相似的对象"在数字上"比较接近",机器才有得比较。(这里的特征只是辅助理解的比喻——真实模型并不会去数"甜度",它会从海量数据里自动学到更复杂的、人类难以命名的隐藏特征。)
1.2 Embedding:把对象变成一串数字
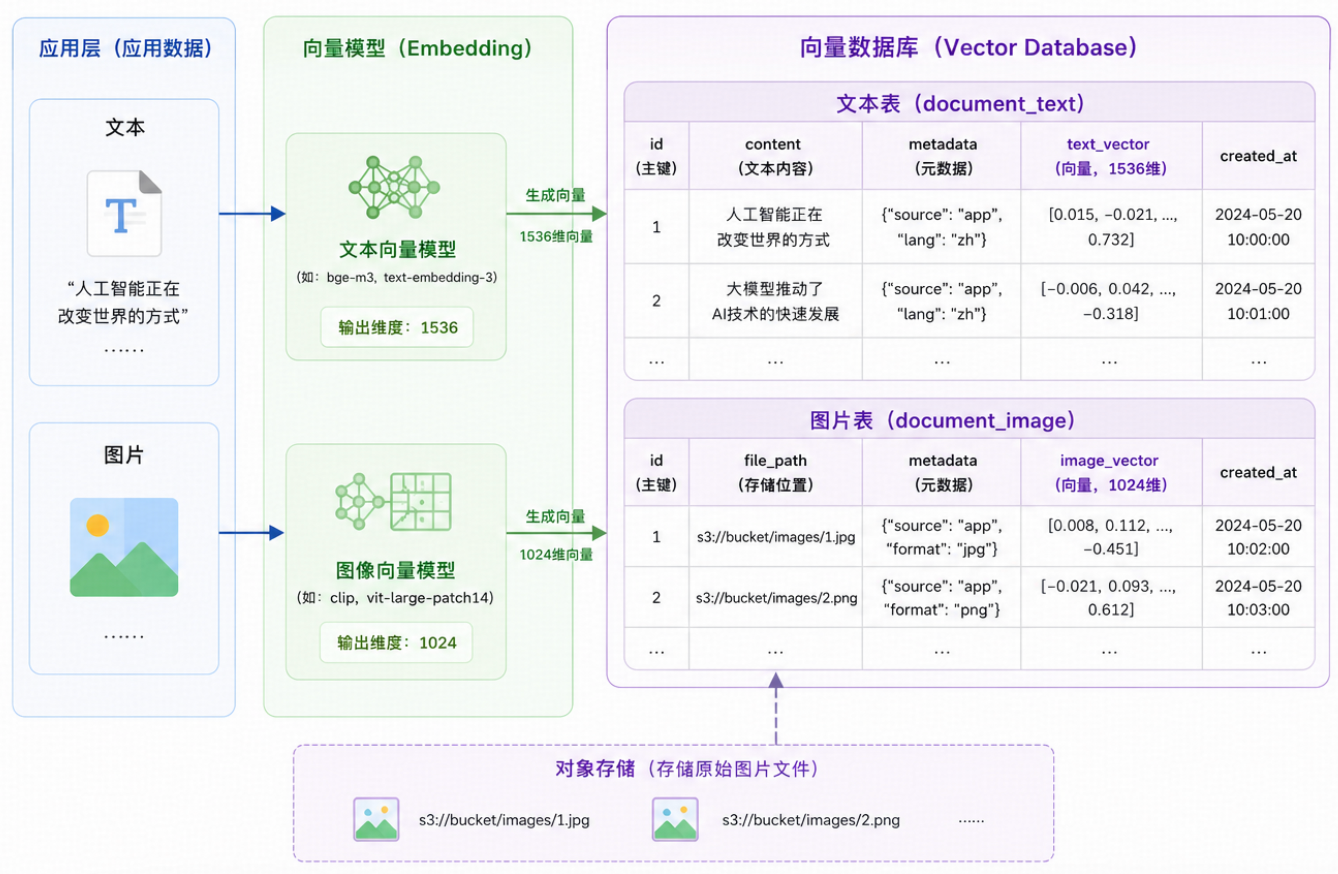
帮计算机完成不可理解的对象到可理解的数字翻译的,是一种叫 Embedding 模型的人工智能模型。
Embedding(嵌入 / 向量化):把任意对象(一张图、一段文字、一件商品……)映射成一个固定长度的连续数值数组。这个数组通常被称为向量(Vector),本质就是"一串浮点数",每个浮点数代表了一个维度的数值。维度越多,数组数据项越多。
一个典型的向量长这样(示意,真实维度高得多):
哈密瓜:[0.9, 0.9, 0.1]
西瓜:  [0.9, 0.8, 0.1]
篮球:  [0.1, 0.1, 0.9]
几个关键点:
- 高维向量:向量里数字的个数叫维度 D。真实向量的维度通常是几百到上千(如 768、1024 维)。维度越高,表达能力越强,但存储与计算也更贵。
- 它不是分类器:Embedding 不是给对象贴"水果/不是水果"的标签,而是学习一种适合比较的数字表示。同类别里的细微差异,也会被保留下来。
Embedding 模型的能力和"维度"差别很大,按适用领域大致分为几大类。以下是主流模型的速览:
-
通用文本 / 语义检索 / RAG(最常用)
- OpenAI text-embedding-3-small:1536 维(可降维,如 512/256)
- OpenAI text-embedding-3-large:3072 维(可降维)
- BGE(中英文、开源、RAG 常用):如 bge-large-zh 为 1024 维,bge-base-zh 为 768 维
- 阿里通义 text-embedding-v3 / gte:1024 维(gte 系列常见 768 维)
-
代码(检索代码库 / 代码问答)
- OpenCodeInterpreter、CodeBERT 等,通常 768–1024 维
-
图像(图片相似 / 图文检索)
- OpenAI CLIP:图像与文本各为 512 / 768 维
- SigLIP:768–1152 维
-
多模态统一(图文+文本+音)
- 各家统一向量多为 1024–2048 维 左右
文本语义模型主流落在 768–1536 维,多模态更高(能到 2K+),维度越高越能表达"细粒度语义",但存储(4 字节/维 × N 条)和检索成本都线性涨。
注:4 字节/维通常代表使用的是32位单精度浮点数(Float32, 7 位有效十进制数字,范围 ±1e-38~±3.4e38) 。
1.3 向量 = 高维空间里的一个点
有了数字,我们就能换一个更好用的视角:把一个 n 维向量,想象成高维空间里的一个点。
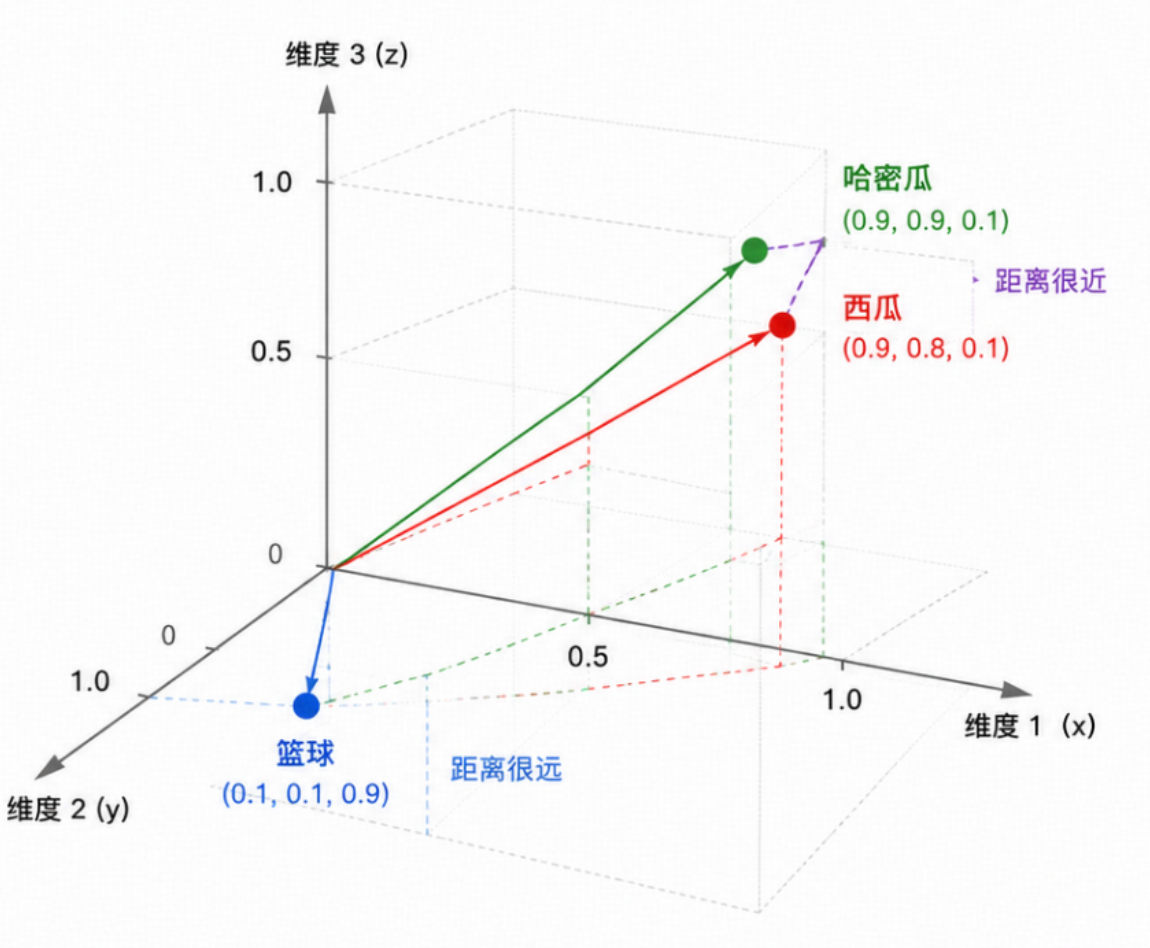
- 用上面三维坐标举例:三个数字就是空间里的三个坐标。
- 西瓜和哈密瓜的坐标挨得很近 → 它们在空间中位置接近;
- 篮球的坐标离它们很远 → 位置远。
于是,一句非常重要的话成立了:
相似的对象,在空间中位置接近;不相似的对象,位置相距很远。
"向量检索"的本质就是:在空间里找"离查询点最近的那些点"。 后续所有复杂机制,都建立在"离查询点最近的那些点"这个点上。这也是为什么我们总把向量思考成"空间的点 + 点与点的距离",它非常有助于后面理解各种检索算法。
1.4 相似度怎么算:三种主流度量
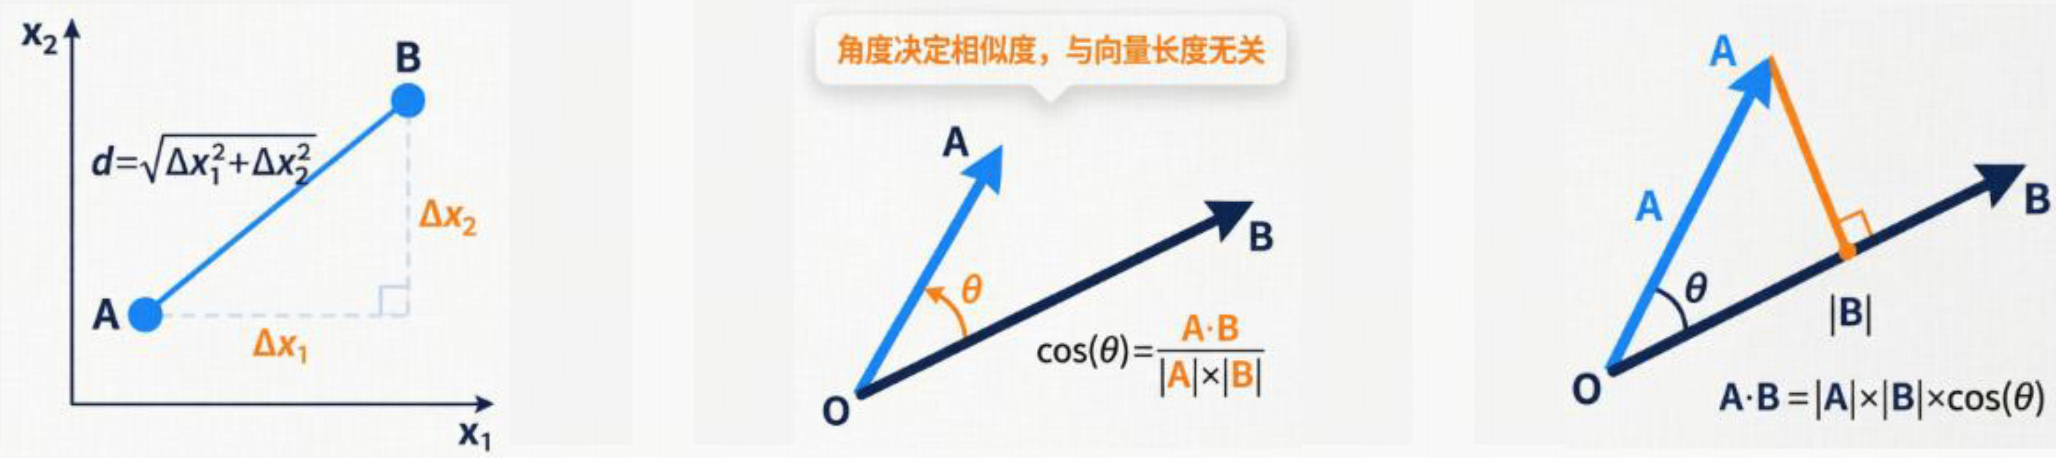
要比较两个向量像不像,基本方法有两类:算距离(越小越像),或算相似度(越大越像)。业界最常用的三种:
度量 |
判断依据 |
越大/越小越像 |
一句话 |
|---|---|---|---|
L2 欧氏距离 |
两点间的直线距离 |
越小越像 |
纯粹看"离得多远" |
余弦相似度 |
两个向量方向的夹角 |
越大越像 |
只看"方向是否一致",不看长短 |
内积(点积) |
方向与长度的综合 |
越大越像 |
同时受方向与长度影响 |
几个小提示:
- 余弦只看方向,所以"把整体放大 10 倍"不影响它——常用于文本语义。
- 内积没归一化,会受向量长度影响。
- 一个常用技巧:如果先把向量归一化成单位长度,那么"欧氏距离排序"和"余弦相似度排序"在结果上等价——业务选哪种,取决于你用的 Embedding 输出约定。
- 在数据库 SQL 里,这类函数常以"距离"命名(如
VEC_COSINE_DISTANCE),也就是距离越小越像。
1.5 检索的最小闭环
好,现在把前面介绍串成一个最简单可用的检索流程。当你给系统一个"查询对象"(比如一段要搜索的文字),把查询对象也 Embedding 成数字后,在库内检索流程如下:
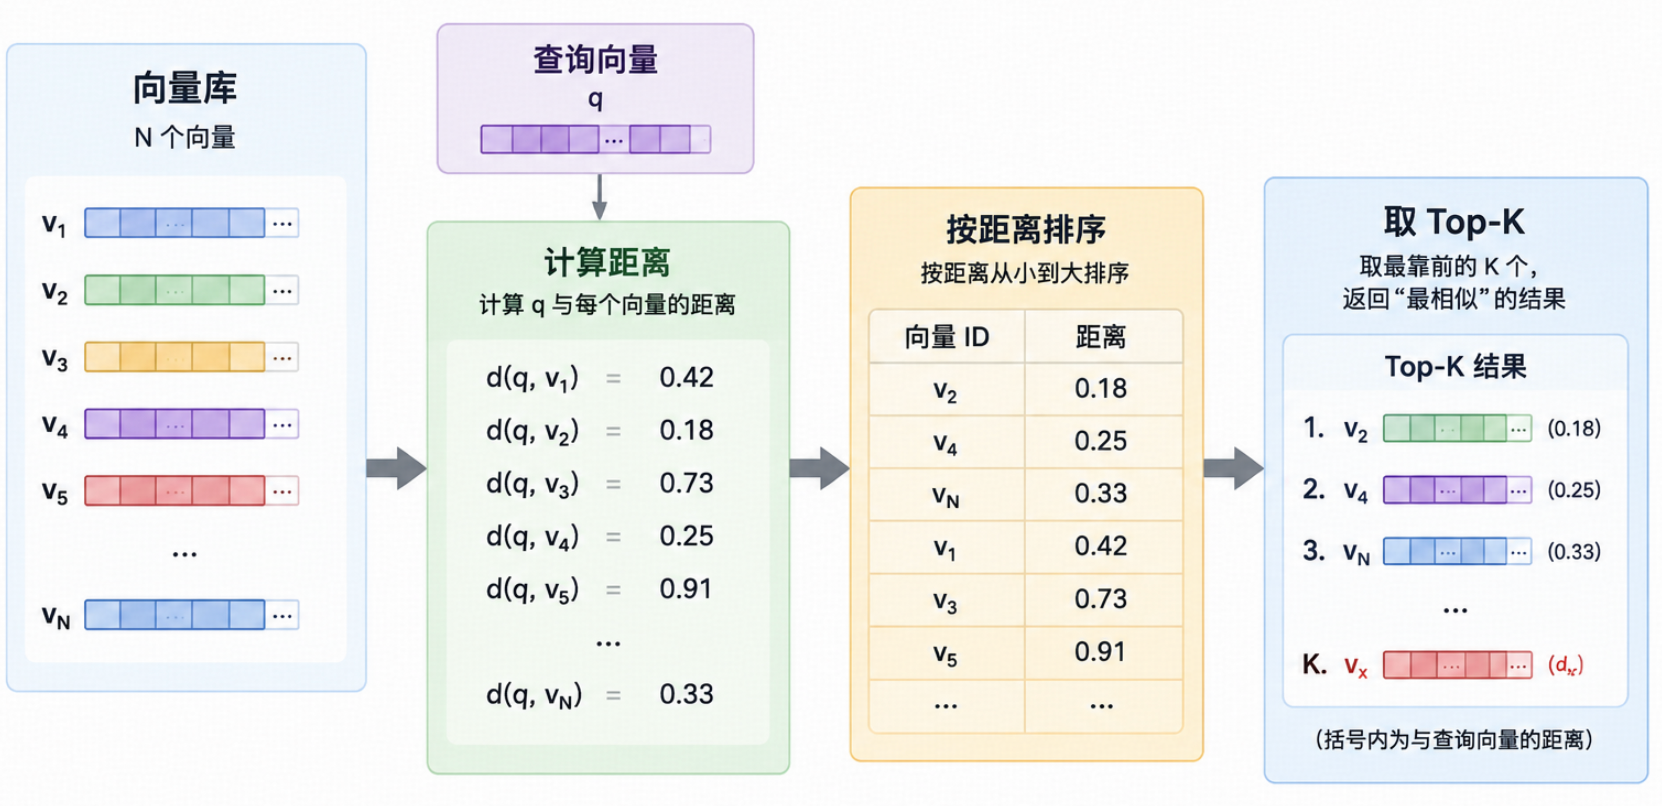
高频名词术语:
- 查询向量(Query vector):用户当前想搜索的那个对象,转成的向量。
- Top-K:最终返回的最相似的 K 个结果。
- 最近邻(Nearest Neighbor):与查询距离最近的那个向量。
向量是对象的数字表示,检索就是"算距离 + 取 Top-K"。
当"库里的向量"不是几个,而是几百万、上亿个时,逐个检查(全表扫描)这个"简单"的算法还跑得动吗?
二、向量检索技术
2.1 向量索引运用的架构思想
- 分治(Divide and Conquer)思想
分治是把一个大到一次处理不了的问题,反复切成小块的子问题,最后把小块结果合并回最终答案。
关键点在于:要么块太小不值一提,要么根本算不动,切小了才"算得动 + 算得快"。
分治的经典三步:
- Divide(分):把原问题切成若干更小的子问题;
- Conquer(治/解):递归地解每个小子问题(小到能直接解);
- Combine(合):把子问题的解拼回原问题的解。
Hash Join 是一种 "分治(build → probe)" 思想的体现,过程中分为两个阶段:
-
Build(建哈希表/建桶)—— 这是"分"
- 挑较小的表(通常叫"驱动表/小表")作为 build 表;
- 用一个哈希函数 hash(key),按连接键把它的每一行分到不同的哈希桶里;
- build 表被"切"成了多个桶,每个桶里都是"哈希值相同"的一撮行。
-
Probe(探测)—— 这是"治 + 合"
- 拿另一张大表(probe 表)的每一行,也对连接键做同样的 hash(key);
- 如果两行要能 join 上,它们的连接键必然相等;键相等 → 哈希值一定相等 → 一定落在同一个桶。所以 probe 的每一行只需要去它对应的那个桶里和 build 的行比,永远不用去别的桶。
- 最终汇总所有桶的连接键等同行得到最终结果集。
向量检索语境里的分治:
- IVF:把空间切成 nlist 个桶 → 只去"最像的少数桶"里精搜 → 合并结果取 Top-K。
- HNSW:把图分成稀疏到密集的层 → 从粗层快速路由到细层。
- SPFresh:把空间切成分区树(root → 多层 → leaf) → 定位到叶子再精搜。
把"对 N 个向量穷举"这个大问题,切成"先在小范围里找对路再精搜"的一堆小块,从而把复杂度从线性/天文数字,降到可接受的对数量级。
- 近似(Approximation)思想
近似思想是向量场景和原来的关系数据库场景一个较大的不同点,不追求"100% 正确"的答案,只追求"够接近、且代价小得多"的答案,用一点点精度损失,换巨大的速度和成本收益。
关键点在于:近似的根基是——在很多真实场景里,精确答案和够好的答案,对使用者来说没有差别;但精确的代价却贵得离谱。所以干脆"够好就行"。
结合分治来看,"分治"能帮你少算,但分治切块本身也可能带来误差(比如切块时把真·最近邻切到没被访问的桶里);而且真要做到全局精确(像暴搜那样一个不落)成本是不可接受的。于是我们用近似来接受"偶尔漏一点、但整体够准"。
具体的向量索引技术将会是"分治"和"近似"思想综合运用,用"分治"把大问题变小(少做比较计算),再用"近似"接受"变小过程中难免的那点误差"(漏一点没关系)。
2.2 暴搜(KNN):准确,但不可扩展
2.2.1 什么叫"精确最近邻"
刚才那个"最小闭环",如果我们老老实实和库里的每一项向量记录都算一次距离,这个最朴素的做法就叫暴搜(Brute Force),也叫精确 KNN(K-Nearest Neighbors)。
- K:要返回的最近邻居个数(也就是 Top-K 的 K)。
- 精确(exact):因为它真的把每个候选都比了一遍,所以返回的一定是全局真正最相似的那 K 个——没有任何近似损失。用后面要讲的指标说,就是 Recall = 1.0。
2.2.2 暴搜的成本结构
暴搜每次查询的成本很直接,可以用一个公式概括:
总成本 ≈ N × D
- N:候选数量(要比较多少对象)
- D:向量维度(每个对象上有多少数字要算)
看两张具体的账:
- 1 万个向量:每次 1 万 × D 次运算——单次检索毫无压力。
- 1 亿个向量:每次 1 亿 × D 次运算——在延迟和成本上都是天文数字,完全不可接受。
问题的本质是:成本随 N 线性增长,而真实场景的 N 是百万到亿级,而且是高并发的检索。这就是全文的起点——"检索慢"的根源,就是全文暴搜的算法复杂度 O(N·D)。
2.2.3 暴搜的角色:它是"标尺",不是"方案"
虽然暴搜在大数据规模下没法用,但它有一个极其重要的角色:当"标准答案"。
因为它是精确的,所以当我们评价任何一个"更快的算法"时,都需要一个"到底对不对"的参照。这个参照就是暴搜的结果。 你在后面的 Recall 公式里会再见到它——它一遍遍充当那个"真实 Top-K"的裁判。
2.3 ANN:用"近似"换"速度"
2.3.1 为什么要走近似这条路
既然全量暴搜跑不动,直觉上的解法是:能不能别把力气花在不可能是答案的那些向量上?
于是出现了 ANN(Approximate Nearest Neighbor,近似最近邻):
不保证返回全局最近的那个,只保证返回"足够近"的候选。用可控的精度损失,换取数量级的速度提升。
核心思想:通过预先组织(建图、聚类、分区……),在查询时跳过绝大部分不可能是最近邻的向量,只在小范围候选里精搜——从而把 O(N·D) 死死压住,让成本只在"极小比例那批"上发生。
这也是为什么我们反复强调那句:所有向量索引的努力,本质都是"减少比较一些向量"。
适用场景很广:大规模向量检索、对延迟敏感的搜索/推荐、以及当下最热门的 RAG(检索增强生成)知识库检索——这些场景里,检索要先于大模型生成,因此延迟敏感,而召回只需"够用",天然适合 ANN。
2.3.2 召回率 Recall:怎么衡量"近似损失了多少"
既然 ANN 不再保证精确,我们就需要一个指标衡量"它漏了多少"。这个指标叫 Recall(召回率)。
它的定义(向量检索语境):
recall = | ANN 返回的 Top-K ∩ 暴搜(真实)的 Top-K | / K
逐词拆:
- 暴搜的真实 Top-K:用精确 KNN 算出来的"真·最相似 K 个",当作标准答案;
- ANN 返回的 Top-K:近似算法实际返回的 K 个;
- ∩(交集):两边重合的有几个;
- 分母 = K:理想情况下应全部重合。
看两个数值:
- recall = 1.0:和暴搜完全一致,毫无精度损失。
- recall = 0.95:只漏掉了 5% 的真·最近邻——换来的是数量级的速度提升。
于是工程上形成一个共识金线:在"recall ≥ 0.95"的前提下,追求最快。
2.3.3 怎么"知道"Recall 的数值
当看到某产品宣称的召回率时,会有一个自然的疑问:Recall 要和"真实 Top-K"比,可真实 Top-K 要用暴搜才算得出——暴搜在大库上不是跑不动吗?那 Recall 到底怎么来的?
答案分为评测和生产环境两种:
-
离线评测(最常用的来源):拿一个可控的标准数据集,抽一批查询向量。测试报告中常讲的召回率,如 0.95,是在离线评测集上、以暴搜为基准、统计平均出来的数字,不是运行时实时算的。
- 先用暴搜算出真实 Top-K(这时的库规模是可控的,能跑);
- 再用 ANN 跑一遍拿它的 Top-K;
- 按公式求单条 recall;
- 最后把整批查询的 recall 取平均 → 报告"该数据集 + 该组参数下 Recall = 0.95"。
- 注意:离线压测(read_only 场景)测出的 0.95,不等于上线后恒定不变——上线后一旦有写入、有后台维护竞争,实际召回会跟着波动。
-
生产环境的"近似真值":真实线上库太大,没法每次真跑暴搜。实务里通常用抽样 + 后台对照——随机抽少量查询,临时用暴搜核对一下估算 recall;或用"标签/预期相似对"来间接判断召回是否退化。线上并不能实时自证 Recall,只能靠离线评测 + 抽样推断。
常见的测试数据集说明如下:
向量检索论文(HNSW、Faiss 等)刷榜时必用的标准集,维度、规模、距离度量都固定,便于横向对比:
数据集 |
内容 / 领域 |
维度 |
规模 |
常用距离 |
SIFT1M |
图像 SIFT 特征 |
128 |
1M |
L2 |
GIST1M |
图像 GIST 特征 |
960 |
1M |
L2 |
SIFT10M |
同 SIFT 特征、更大 |
128 |
10M |
L2 |
偏"文本/语义/生产真实场景"的集(新一点,也更贴近 RAG)。更有业务真实性,更贴近真实向量库生产中会遇到的数据形状:中高维(768–1024)、余弦度量、量级到千万。测的是"在真实语料上 768+ 维 + 余弦"下的工程行为,即"embedding 模型的输出向量 + 语义相似度":
数据集 |
领域 |
维度 |
规模 |
常用距离 |
Cohere(embed 向量) |
文本(Cohere embed-v3 产出) |
768 |
1M / 10M |
余弦 |
BioASQ |
生物医学 QA / 文本 |
1024 |
1M |
余弦 |
768D-1M |
通用 embedding 特征 |
768 |
1M |
余弦 |
常见的测试工具说明如下:
VectorDBBench 是一个向量数据库横向评测(benchmark)工具,最初由 Zilliz(Milvus 背后的公司)开发并开源,定位类似"向量数据库界的 ANN-Benchmarks / 数据库界的 sysbench"——专门用来在同一个测试配置下,横向对比多个向量数据库的性价比(Recall、延迟、吞吐)。支持标准向量数据集,SIFT(128 维)、GIST(960 维)等经典图像特征集,Cohere(768 维,文本向量)用户也可自定义数据(自己的向量文件 + 自己的度量:L2 / 余弦 / 内积)。
2.3.4 精度 vs 速度:贯穿全文的总权衡
把上述内容综合在一起,会得到一个贯穿全篇的权衡 trade-off:
- 暴搜 → 精度满分、速度最差;
- ANN → 用一定 Recall 损失,换数量级速度。
工程上的问题就变成了:同样的"近似换取速度"的目标,不同算法用了什么不同的"组织方式"。
2.4 三种加速路线总览
2.4.1 共同目标:减少比较一些向量
在进入细节前,先把这一整段的主旨钉住:
HNSW、IVF、SPFresh 殊途同归——都在降低"每次查询要算多少距离"这个成本,差别只在于它们预先怎么组织向量、查询怎么绕开没用的部分。
2.4.2 三条路线,一句话版
- 路线 1 聚类索引(IVF):先分桶归类,查询只进"最像的少数几个桶"里搜。
- 路线 2 图索引(HNSW):把向量连成一张可导航的网,查询沿网抄近路逼近目标。
- 路线 3 空间分区(SPFresh):把空间动态切成一片片区域,先定位区域再区内精搜。
2.4.3 一把贯穿始终的"比较尺子"
为了不迷失在细节里,建议脑子里始终拿这五个维度去对照每个算法:
维度 |
要回答的问题 |
|---|---|
结构形态 |
它把向量"组织"成了什么(桶 / 图 / 分区树)? |
查询怎么走 |
它是"过滤再搜"还是"导航逼近"? |
漏扫根源 |
它会在哪一步漏掉真·最近邻? |
主核心控制量 |
调哪个参数能让它更准/更快? |
内存性格 |
它把内存花在了哪、省在哪? |
后续三小节,分别用这把尺子把三种路线量一遍。
2.5 路线1:聚类索引(IVF)
2.5.1 基本思想与结构
k-means 是什么?
k-means 是最经典的无监督学习算法之一,目标是:把没有标签的数据点,自动分成 K 个组(簇),让"组内点尽量相近、组间尽量分开"。
-
无监督的含义:数据不带标签,算法自己从数据分布里发现结构,只负责"把相似的聚在一起",至于每组代表什么语义要靠人解读。(区别于"监督学习",后者用带标签数据学"输入→标签"的映射。)
-
怎么做(4 步迭代):
- 随机定 K 个初始簇中心;
- 把每个点划给离它最近的簇中心(归属);
- 每个簇成员取平均值得到新质心;
- 重复前两步直到质心几乎不再移动(收敛)。
- 其中"归属"与"质心"互相影响、迭代收敛——归属变了质心变、质心变了又调整归属。
-
两个特点:需预先指定 K(分几组要人定);结果可能因随机初始化有波动(可用 k-means++ 等选更好的起点)。
IVF(Inverted File,倒排文件索引) 是最经典、最"符合直觉"的加速方案。它的思路一句话:既然是空间里的点,那就把空间先"切块"。
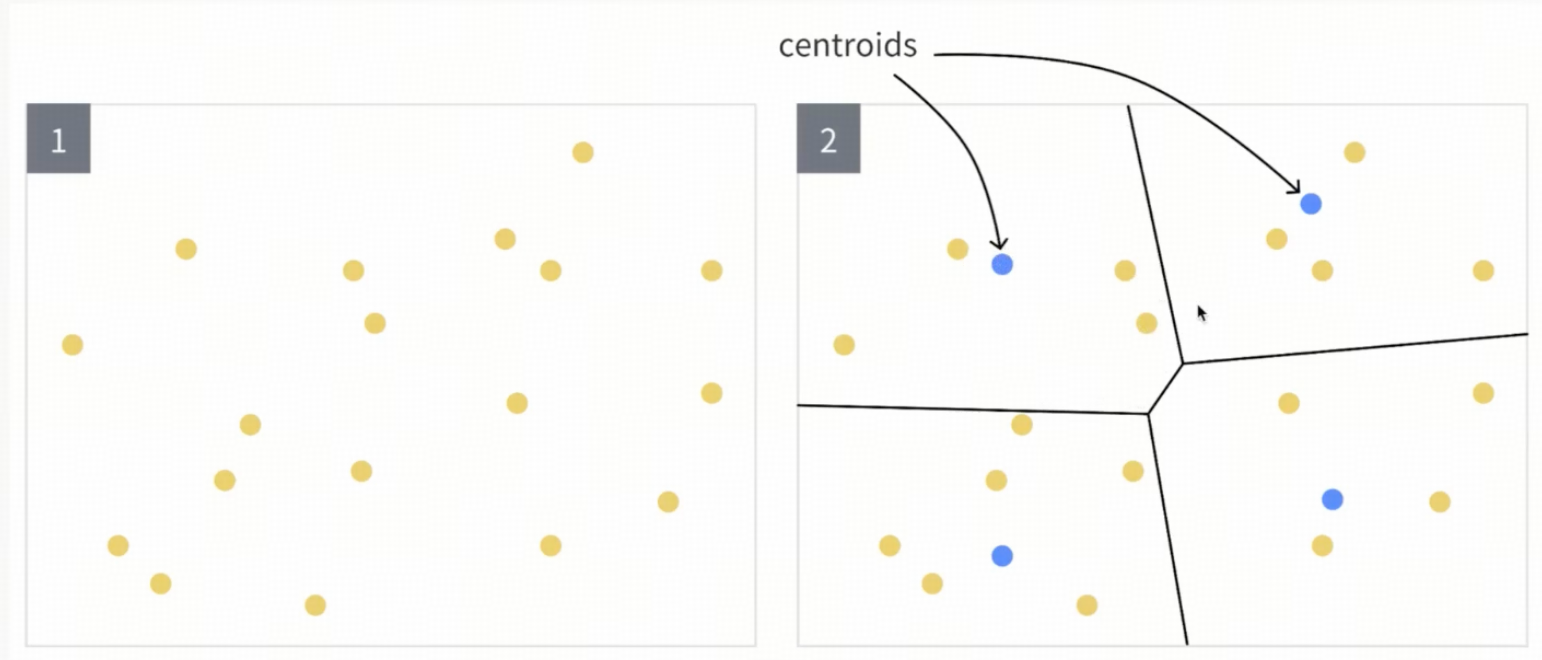
用 k-means 聚类:
- 事先把库里的向量(数量为 N)聚成 nlist 个簇(桶);
- 每个簇算一个簇中心(质心/代表向量);
- 库里的每一个向量,都归到离它最近的簇中心那个桶(有
N/nlist个成员)里。
查询时不用全库搜索比对,用最近的质心对应的桶进行搜索:
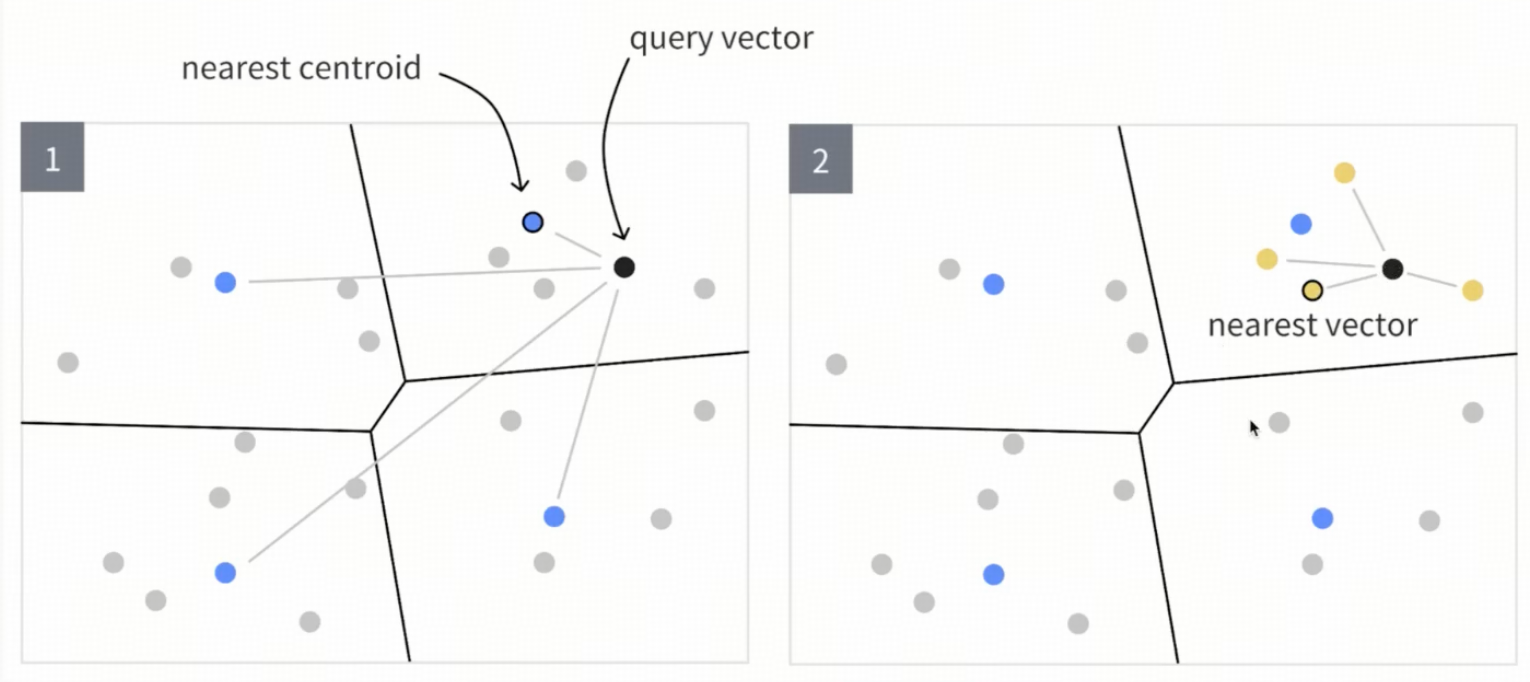
- 用查询向量和这 nlist 个簇中心比,找出离得最近的 nprobe 个桶;
- 只在这 nprobe 个桶内部,逐个和候选向量精算距离;
- 排序取 Top-K。
成本估算:原来扫 N 个,现在先扫 nlist 个簇中心(很快),再扫约 N/nlist × nprobe 个桶内候选——N 大时能省下好几个数量级。
2.5.2 聚类索引为什么"内存友好"
这是 IVF 的一个重要性格标签。它的内存用法是"分层的":
- 常驻内存的,是"瘦身"部分:nlist 个簇中心 + 每桶一张倒排清单。这些很轻。
- 真正占大头的向量本体,可以放到磁盘或更外部的存储——搜到对应桶后,再按清单去取那批向量算距离。
换句话说:IVF 不必把全部原始向量常驻内存,内存主要用来养"能定位的那层导航(簇中心+索引清单)",所以相对内存友好、也更好扩展。代价是如果向量在盘上,搜桶时要读盘,会有 IO 开销。这也是它比后面要讲的"整图进内存"的 HNSW 在延迟上略逊但更能支持大数据量的原因。
2.5.3 倒排表(Posting List):把数据结构讲清楚
倒排表关键在"倒排"两个字——它和我们习惯的存储方向相反:
- 正排(以对象为主线):记录"每个向量,它属于哪个桶"。
- 倒排(以桶为主线):反过来记录"每个桶里,装了哪些向量"。
一个桶的倒排表,大概长这样(示意):
桶 #3(簇中心 C₃):
    向量ID: v_102, v_556, v_778, ...
    位置/偏移: (文件, 偏移量) ...
也就是说,倒排表 = 以桶为主索引、列出"这个桶里有哪些向量 + 它们存在哪里(ID / 偏移)"的一张清单(可以认为是桶内成员位置距桶中心的索引)。
查询时它的作用就很清楚了:定位到某个桶后,照着倒排表里的清单去取这批向量的真实数据来算距离,而不必到全库翻找。正是这张轻量清单,让"内存不养全部向量、又能精确地按需取数"成为可能——它和簇中心一起,"簇中心管粗定位、倒排表管把桶内真实数据捞出来",构成 IVF 的完整导航。
2.5.4 查询流程与两个核心控制量
IVF 的查询流程就是:
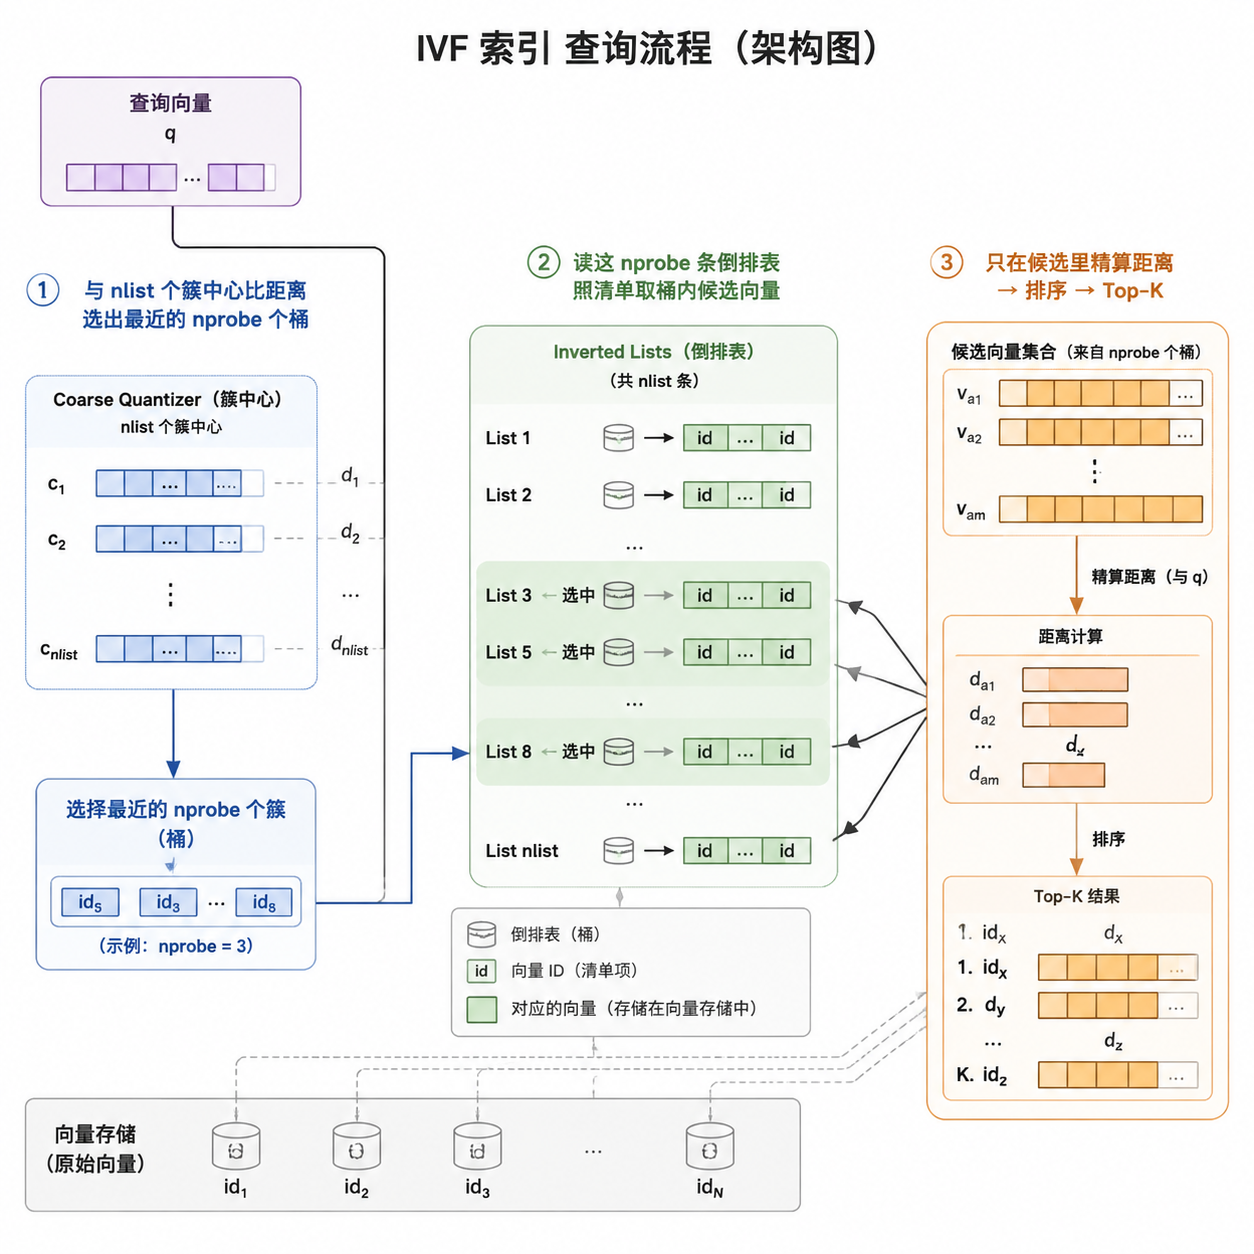
查询向量 q
- 与 nlist 个簇中心比距离,选出最近的 nprobe 个桶
- 读这 nprobe 条倒排表,照清单取桶内候选向量
- 只在候选里精算距离,排序得到 Top-K
这里的两个核心控制量,直接影响 Recall 与速度:
- nlist(桶数 / 分的粗细):切得越粗,每桶越大、越慢但越不容易把相近切散;切得越细,桶多但桶小。分得太细时,同类的相近向量可能被切到不同桶,反而容易"找错桶"。
- nprobe(查几个桶):越大 → 纳入精搜的桶越多 → 越不容易漏(Recall 越高),但越慢。 nprobe = nlist 时就退化成全扫了。
2.5.5 IVF 的漏扫:为什么"站错队"就会漏
理解漏扫,先抓住 IVF 漏的结构性格——它属于"过滤型"漏:查询只在少数桶里精搜,只要真·最近邻所在的桶没被你选进来,它就根本没机会上榜。
丢分的三种来源:
- 粗定位站错队(最主要):选桶是按"查询离哪些簇中心近",但真邻居可能"离查询近、却离查询所选的簇中心远"——它所在桶不在 nprobe 里,从根上就被排除了。这就是"分治/分桶过滤"的天然代价:近似从"桶粒度"就开始了。
- 聚类切得不贴合:如果 k-means 把本来很近的向量切散到不同簇,也会逼你调大 nprobe 去追。
- nprobe 太小:探得少,自然漏得多。
补救方向:调大 nprobe、细化 nlist(配合更大的 nprobe)、或做向量预处理让聚类更贴合真近邻。只要把 Recall 拉回 ≥0.95 那条工程线,一切可接受——毕竟换来的是数量级提速。
2.6 路线2:图索引(HNSW)
2.6.1 基本思想与结构
"组织方式"——不切块,而是建图(Graph)。
HNSW(Hierarchical Navigable Small World,分层可导航小世界)是目前最主流的基于图的 ANN 索引。
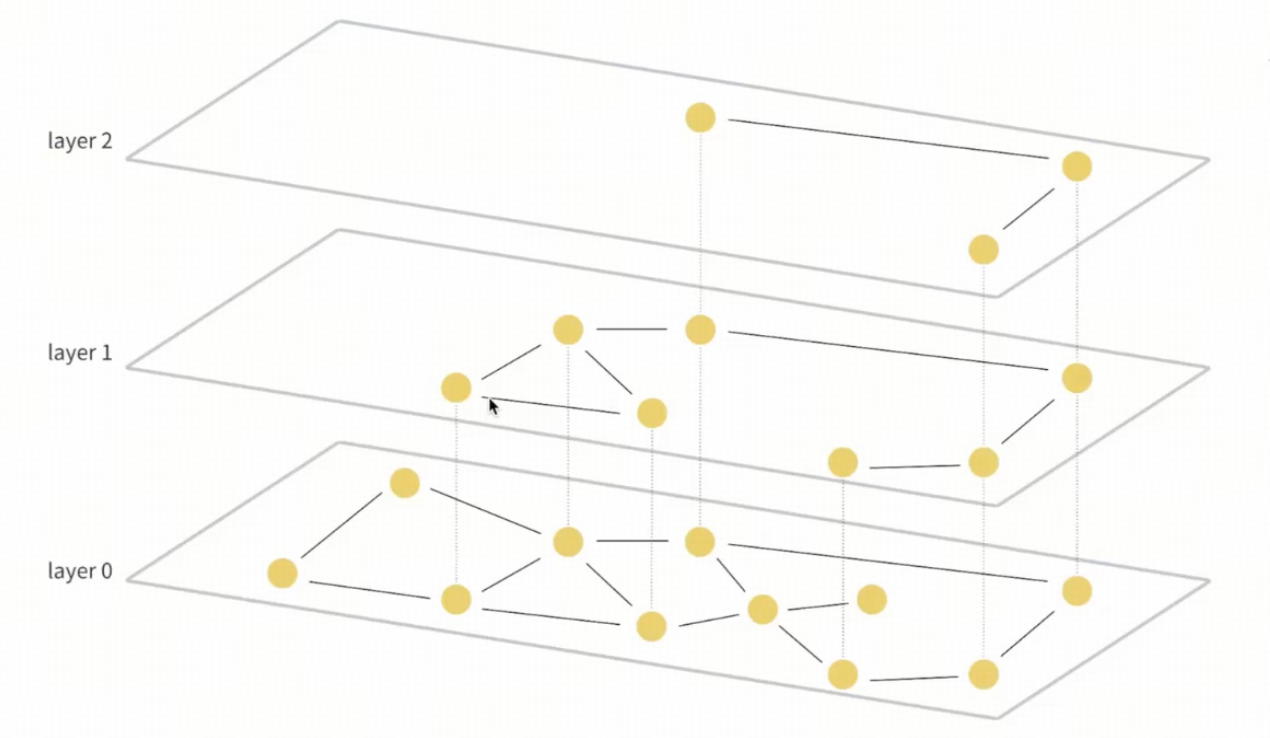
它的形态是:把每个向量当作图上一个节点,相近的向量之间连一条"邻居边",形成一张网。HNSW 在构建时有两个参数影响索引图的质量。
在构建索引时, M 参数 控制图中每个节点建立的双向链接(邻居)的最大数量,它决定了图结构的密度。M 值越大,图的连通性越好,检索的召回率和准确率越高,但同时也会增加内存消耗和索引构建时间。
插入节点后在构建索引时,ef_construction 参数用于搜索候选邻居的队列大小。它决定了索引图的质量。该值越大,算法的搜索视野更广,它能在一个更大的候选池中进行筛选。这意味着它不仅能找到最近的点,还能找到那些虽然稍微远一点,但处于不同方向、能通往其他数据簇的“桥梁节点”,构建出的图结构越优,检索精度越高,但代价是索引构建时间显著增加。
这张网不是平的,而是分层的:
- 底层:节点稠密,记载最精细的邻居关系;
- 越往上越稀疏:顶层只有少数"幸运节点",互相连成长距离的"脊梁"。
为什么要分层?它是借用了跳表(Skip-List)的思想:顶层节点稀疏,像"高速公路"一样负责长距离快速路由;底层节点密集,负责细粒度精搜。
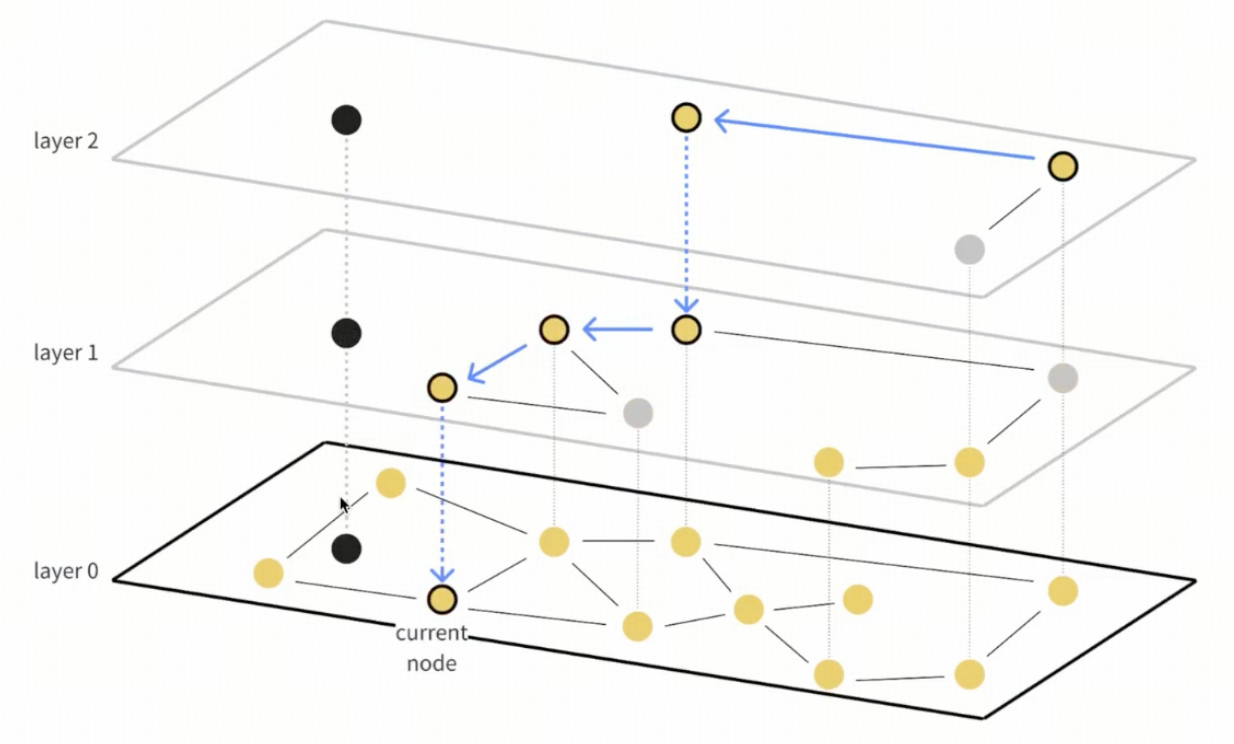
查询向量由上图的黑点表示,从顶层出发,能"跳"着快速接近目标区域,再逐层下沉精确定位。
2.6.2 查询怎么"走"
HNSW 的搜索方式可以理解为"沿着网抄近路":
- 站在当前节点,看它所有邻居里谁离查询向量最近,就往那个邻居跳;在当前层找不到更近的,就下潜到下一层继续;一直走到最底层,返回找到的最近点。
- ef_search 参数是 HNSW 的搜索方法在执行查询(检索)时,动态维护的候选邻居列表大小。该值越大,搜索精度和召回率越高,但查询延迟也会随之增加。
2.6.3 图索引为什么"吃内存"
HNSW 一个非常鲜明的性格就是占用内存资源。原因在于:
- 为了极低的查询延迟,它倾向于把整张图结构 + 全部向量都常驻内存,搜索全程在内存里跳指针;
- 内存里除了向量本体,还要额外存图的结构开销(每条边 = 一个指针/邻居 ID),加上多层有冗余节点,开销更高。
一句话:HNSW 是用"大量常驻内存"换"极低延迟"——优点很明显(快、稳、准),代价是数据量一大(亿级)往往内存放不下/成本爆炸。这正是它和"向量可放盘/量化压体"的 IVF、SPFresh 在内存性格上的分水岭。
2.6.4 HNSW 的漏扫:为什么"走偏"就会漏
图索引漏扫的原因和 IVF 完全不同——IVF 是"过滤型"漏(桶没选对),HNSW 是"寻路型"漏(路走歪了、到不了)。
几张典型的"走丢"画面:
- 局部最优陷阱(最常见):贪心每步只往"当前最近方向"走,一旦走进一个"谷底"(四周邻居都不如当前点近),就停了——可真正的全局最近邻在"另一座山头",根本没被探索到。
- 跳过头:上层一跳很远,如果这一跳越过了真·最近邻所在区域,下层又从跳落点开始搜,就错过去了。
- 图本身连通不足:构建时每个节点只连有限个邻居(受构建参数限制),若真·最近邻本来就没被连上"就近的边",就没有路能导过去。
准确度的优化措施:
-
关于
M和ef_construction(治本):- 微调建议:调大这两个参数,本质上是增加了“冗余边”和“全局视野”。更多的边意味着即使某条路断了,还有备用路线(提升鲁棒性);更大的候选列表意味着建图时能挑出那些虽然当前不是“绝对最近”,但能连通其他数据簇的“桥梁节点(Hub Nodes)”。
-
关于
ef_search(治标):- 微调建议:调大
ef_search的本质,是让算法在底层搜索时“允许犯错”。当算法不小心走进了“局部最优陷阱”时,因为候选队列足够大,它还有余力去探索队列里其他稍远一点的节点,从而有机会“跳出谷底”,找到真正的全局最优解。
- 微调建议:调大
2.6.5 图索引的"增量困境"
HNSW 的缺点:
- HNSW / IVF 更适合"建好后基本不动"的静态场景。因为一旦有插入/删除,原本精心安排的图结构(邻居关系)或分桶会被打乱,要恢复质量往往需要重建或大范围修改。
- 可真实业务里,向量库往往是持续写入的(不断有新文章、新商品、新向量进来)。
这就提出了一个需求:能不能有一个索引,既能快速检索,又能"带着写入"长期维护、不用动不动重建?
—— 这正是 SPFresh 要解决的问题(空间分区 + 动态 Split/Merge)。
2.7 路线3:空间分区——SPFresh 的算法根基
2.7.1 与 IVF 的"同"与"不同"
严格来说,SPFresh 和 IVF 在"大类"上是同一条路——都属于"先把空间/向量按相似组织成块,再定位到块、在块内精搜"的分区(聚类)型索引。
但它们有本质差别,这个差别直接决定了两者适用的场景:
IVF(静态分桶) |
SPFresh(动态分区) |
|
|---|---|---|
桶/区怎么定 |
建库时一次 k-means,之后基本固定 |
树状分区,随写入动态 Split/Merge |
写入来了 |
结构基本不动,质量会逐渐下降 |
持续整形,长期保持可用的质量 |
增量维护 |
不方便,改变多需重建 |
主要能力项(增量 + 后台 Fixup) |
设计取向 |
"建好就能查" |
"边写边查,永远 Fresh" |
所以更准确的表述是:SPFresh 是给你"想持续写入"的业务准备的、能动态自愈的空间分区索引。下面把它的算法形态讲清楚。
2.7.2 基本形态:root → 多层 partition → leaf
SPFresh 的基本组织是一个树结构,可以类比 B+ 树索引:
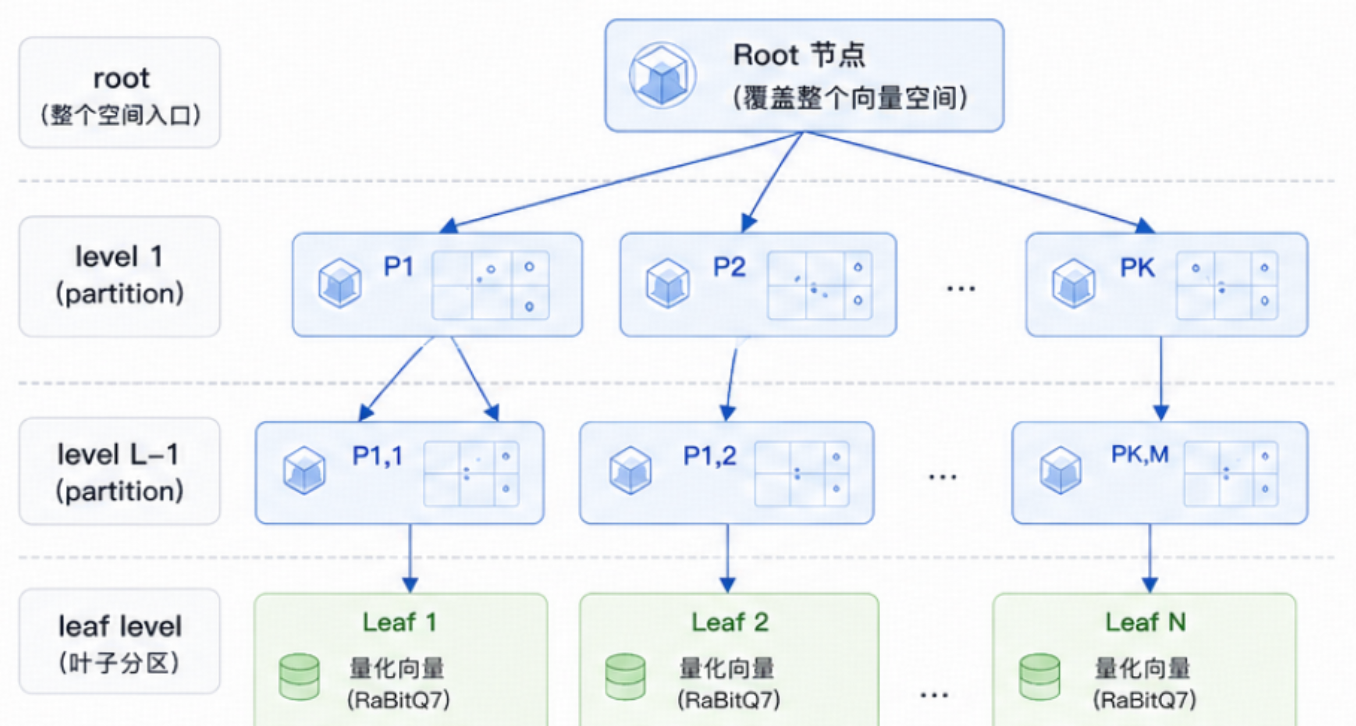
- root / 内部节点:负责把空间自上而下逐层细分,形成一棵"粗定位导航树"。查询从 root 出发,逐层判断"该往哪个分区走"。
- leaf(叶子分区):树的末端,是真正"装向量"的实体单元。
查询的大方向也就清楚了:顺着树从 root 逐层下沉 → 落到目标 leaf → 在 leaf 那片里精搜。 这跟 HNSW "从顶层一路下潜到底"的架势很神似——两者都是在用"层级导航"来减少比较。
2.7.3 量化技术
在工程实现里叶子分区其实不存完整向量,而是存量化过的数值来做快速粗筛,真实向量存在基表、需要时回表取。量化用更少的比特去表示一个向量/权重的过程,用可控的精度损失换取更小的存储 + 更快的计算。原始向量是 Float32(32 位浮点,即 4 字节/维),量化就是把这个精度压缩。量化的方法:
- 降比特:比如把每个维度从 32 位压到 8 位(int8,1 字节),或 4 位、甚至 1 位(二值化)。
- 怎么压:因为向量各维数值都有个大致范围,可以按范围"分档",用较少的位去记录"它落在哪一档"。
- 常见增益:8 bit → 存储减到 1/4;4 bit → 减到 1/8;同时因为位数少,批量计算(配 SIMD 向量指令)能一次算更多,算得更快。
所以量化技术在向量索引上的优势正是 SPFresh 让叶子存量化版、真向量留基表的原因。
2.7.4 为什么要"多层"分区?
单层的两难:
- 若叶子切太粗 → 每片还塞着几十万向量,查询落进去仍要扫一大片 → 省不了多少。
- 若树叶切很细 → 要覆盖同样空间,分区数会指数级膨胀,root 一下挂几千、上万个叶子 → 查询从 root 出发,又变成"在大量叶子里大海选"——把"比较慢"换成了"查找慢"。
多层的好处——"逐层做小判断,代替一层大海选":想象在城市里找一栋楼:若只有一个"国家→街道"的两级,很粗;真正的地址是"国家→城市→区→街道→门牌"——每一步只需判断"往哪个方向走一小步",几步就到,而每一步判断都极其便宜。
数学上这也说得通:如果能被切到 M 个叶子,那么逐层二分的定位成本约是 O(log M) 次便宜判断,而一层摊开要 O(M) 去找对那个叶子。当 M 很大(几万叶片)时,log 与线性是天壤之别——这就是分层检索快的数学根源(和二分查找、跳表分层同一个原理)。
分层还得到"局部性"的红利:树分层后,任何单点变化(一个叶子爆满要分裂),只需要动它那一支,其它兄弟分支不受影响。这让你能"增量、局部地"维护整棵树。
2.7.5 动态维护:Split / Merge 与"轻量重平衡"
SPFresh 既然服务"持续写入",就必须有一套让树长期保持"不撑爆、不空转"的机制。这就是它维护的核心:
Split(分裂)—— 叶子写太满时:
- 某个 leaf 因为不停写入,超出容量上限(
max_partition_size); - 触发 Split:把它一分为二,变为两个更小的叶子(必要时在树里插入新的内部分区节点);
- 分裂后,两个新子分区都要重新算各自的质心(簇中心),并把成员向量就近重新归属——离哪个子分区质心近就跟哪个走。
Merge(合并)—— 数据被删空/变少时:
- 反向操作:某个叶子长期被删、变得太稀疏(低到
min_partition_size),就把相邻稀疏叶子合并回去,回收空壳、保持树不臃肿。
关于"轻量重平衡",有个容易理解偏的细节:这里的"质心 + 向量迁移"并不是"新质心定死了、向量被硬搬过去",而是归属与质心双向迭代收敛——向量就近归属决定质心、质心又反过来引导归属,直到稳定(本质是一次小规模、局部的重聚类,类似 k-means 里的小步迭代)。而且优化目标是**"迁移量最小"**:只搬"溢出/越界"的那一小部分,尽量不惊动整个分区。
于是 Split/Merge 是这样被压"轻"的:
- 局部:只作用于出问题的那一支(分层的局部性红利);
- 少搬:只迁边界附近少量向量;
- 异步后台:真正的搬移与 Fixup 可以交给后台慢慢消化,不阻塞在线搜索(工程篇会讲)——这里先知道"它能做到增量、轻量、可后台"即可。
这套"用分裂/合并让分区长期均衡、结构保持稳定"的机制,正是 SPFresh 免于动不动全量重建、从而能持续在线服务的原因;它的正式名字是轻量增量重平衡。记住它的目标:让每次维护都只动局部一支、迁移最少、还能后台慢慢做。
2.7.6 小结:为"频繁写入"而生的动态索引
SPFresh 是一种面向频繁写入的动态空间分区索引:它把向量组织成一棵会随数据"生长/收缩"的多层分区树(root → 多层 partition → leaf),查询沿树定位到叶子再精搜;写入过多就 Split、偏空就 Merge,并用轻量增量重平衡让维护只动局部、可后台化——因此它能长期带着写入运行而不用重建。
它相比 HNSW、IVF 最大的不同,就是把"持续更新 + 可维护"当成了设计目标本身。这也正是 TiDB 的 SPFresh 向量索引选择它来落地"可写向量库"的理由——至于这一切在真实数据库进程里到底怎么被编排、partition 与原始向量如何分离存储、后台 Fixup 如何收拾烂摊子,就是我们**下一篇(工程实现)**的主场了。
2.8 三种索引的对比与选型
2.8.1 特性对照表
维度 |
路线1 IVF(聚类) |
路线2 HNSW(图) |
路线3 SPFresh(动态空间分区) |
|---|---|---|---|
结构形态 |
静态分桶 + 倒排表 |
静态分层近邻图 |
动态分区树(root→多层→leaf) |
查询怎么走 |
定位最近 nprobe 桶 → 桶内精搜 |
沿邻边贪心/从顶层下潜 |
顺分区树定位到 leaf → 区内精搜 |
漏扫根源 |
过滤型:真最近邻所在桶没进 nprobe |
寻路型:贪心走偏/走停/跳过 |
贪心走偏/质心代表性不足/信息陈旧等 |
主要核心控制量 |
nlist / nprobe |
ef_search / 图连通度 |
分区大小 / 重平衡参数 |
内存性格 |
友好:向量可外部化,养"导航层" |
吃内存:整图 + 向量常驻 |
仅用于轻量级索引 + 按需回表 |
增量/维护 |
不方便,变多需重建 |
不方便(增量困境) |
关键能力项:Split/Merge + 轻量重平衡 |
2.8.2 内存使用差异
内存是算法选择时主要的资源限制:
- IVF:内存只养"簇中心 + 倒排清单"这层瘦导航,向量本体可放盘 → 友好、耐大。
- HNSW:为了极低延迟把整张图结构和向量全塞内存 → 最快但最贵,不适合超大数据。
- SPFresh:内存需求主要集中在质心索引(Centroids Index)以及可能的元数据/过滤索引上,工程上结合叶子不存完整向量(放量化压缩版)的优化手段 → 在数据大 + 长期运行场景里内存压力最小。
一句话:图索引用内存换延迟,聚类/分区索引把内存留给"导航层"来求扩展,SPFresh 又借量化+回表把"导航层自身"也做得很瘦。
2.8.3 何时选谁
没有银弹,只有场景匹配:
- 库不大、要极致的低延迟,且能接受较高内存成本、数据不太变 → 图索引(HNSW)。
- 库很大、想要内存友好、快速上手,数据相对静态 → 聚类索引(IVF)。
- 数据量大、而且持续在写入、希望不必重建就能长期在线维护 → 需要一个动态空间分区索引——这正是 SPFresh 出现的理由。
2.8.4 本章小节:
关键结论:
- 暴搜很准但 O(N·D),大库必死;ANN 用可控精度换数量级速度,用 Recall ≥ 0.95 当质量线。
- 三条路线都是"减少比较一些向量",姿势不同:IVF 切块过滤(nprobe 管召回)、HNSW 建图导航(beam 管召回)、SPFresh 动态分区(会自愈)。
三、上篇总结
到这里你已具备的知识范围。
- 向量层:对象 → Embedding → 高维向量 = 空间点;
- 相似度层:L2 / 余弦 / 内积,检索 = 算距离 + 取 Top-K;
- 性能层:暴搜 O(N·D) 的不可扩展性 → ANN 与 Recall;
- 算法层:IVF(聚类/倒排)、HNSW(图)、SPFresh(动态分区)三条路线的原理、漏扫与核心控制量——每个在架构文档里会遇到的算法名词,你都有了第一性理解。
下篇我们将进入工程实现。