


没有warning,AI的分析,tidb的hint不是强制性的,如果认为成本太高,可能就忽略了。
现在就是想构造出来看看执行计划看看cost是不是真的差距太大,因为当前就只有CPU是差一些的。
14 天前
只说参数,如下配置,语法上是对的。没有实际reload。
monitoring_servers:
- host: 1.2.3.4
ssh_port: 22
port: 9090
ng_port: 12020
deploy_dir: /tidb/tidb-deploy/prometheus-9090
data_dir: /tidb/tidb-data/prometheus-9090
log_dir: /tidb/tidb-deploy/prometheus-9090/log
external_alert…
15 天前
应该不能直接修改本地文件吧?
tiup cluster edit-config ,修改monitoring_servers这里的内容吧?
改本地 reload 得加–skip-restart,要不一重启就被覆盖了。
16 天前
info级别的日志,如果影响不大忽略吧。
另外,可以看看系统里是不是很多limit的语句,是否limit没有下推到TiKV层。
16 天前
[image]
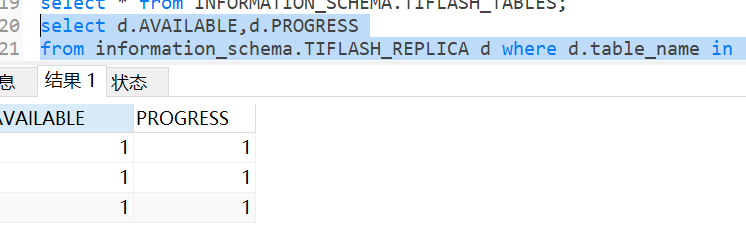
副本是有的,否则tidb_isolation_read_engines=‘tiflash,tidb’,执行查询就会报错l.e。
重新收集统计信息是可以走TiFlash的,RU和执行的效率都比index range快。但是当前为了切从库稳定,从库默认是从主库导出统计信息load进来的,使用主库的统计信息。
18 天前
从库有TiFlash,架构和主库一样的,就是cpu核数变成64了。
将tidb_isolation_read_engines去掉tikv,是可以走TiFlash的,但是这样改影响就大了。
现在想对比下从库走TiFlash的消耗和现有的执行计划消耗资源的差别,但是在从库hint不出来。
18 天前
这个参数只是用于限制是否会往store进行调度,region score是用来判断是否迁出。应该是available来触发惩罚的。
不过,AI算了下,说你的异常得分属于V1 的方式。。。
19 天前
region-score-formula-version 得分是V1还是V2的?两种计算得分的方式不同。
另外,这两个store是新扩的,还是历史的,region个数是由多到少?还是其它?
20 天前
除非你的pd和kv混布了,那是有可能的,混布的话可以限制下调度的线程,宁可慢点,别跑死了。
要是单独部署的,就得看看pd资源打满是什么原因造成的了
21 天前
没有更多内容了