
TiDB 全局排序
Note
- 目前,全局排序过程会消耗 TiDB 节点大量的计算和内存资源。在如用户业务应用运行时在线添加索引等场景下,建议为集群新增 TiDB 节点,并为这些节点配置
tidb_service_scope变量,然后连接到这些节点创建任务。这样,分布式框架会将任务调度到这些节点,从而将工作负载与其他 TiDB 节点隔离,减少执行ADD INDEX、IMPORT INTO等后台任务对用户业务应用的影响。- 使用全局排序功能时,建议使用至少 16 核 CPU 和 32 GiB 内存的 TiDB 节点,以避免 OOM。
Note
该功能不适用于 平凯数据库云服务 Starter 和 平凯数据库云服务 Essential 实例。
概述
TiDB 全局排序功能提升了数据导入和 DDL(数据定义语言)操作的稳定性和效率。它作为 TiDB 分布式执行框架(DXF) 的通用算子,在云端提供全局排序服务。
目前,全局排序功能支持使用 Amazon S3 作为云存储。
使用场景
全局排序功能提升了 IMPORT INTO 和 CREATE INDEX 的稳定性和效率。通过对任务处理的数据进行全局排序,提升了向 TiKV 写入数据的稳定性、可控性和可扩展性,为数据导入和 DDL 任务带来更优的用户体验和更高质量的服务。
全局排序功能在统一的 DXF 内执行任务,确保数据在全局范围内高效并行排序。
限制
目前,全局排序功能不会作为查询执行流程中负责排序查询结果的组件使用。
使用方法
要启用全局排序,请按照以下步骤操作:
-
通过设置
tidb_enable_dist_task为ON启用 DXF。从 v8.1.0 开始,该变量默认开启。对于 v8.1.0 及以上版本新建的集群,可以跳过此步骤。SET GLOBAL tidb_enable_dist_task = ON;
-
将
tidb_cloud_storage_uri设置为正确的云存储路径。参见示例。SET GLOBAL tidb_cloud_storage_uri = 's3://my-bucket/test-data?role-arn=arn:aws:iam::888888888888:role/my-role'
Note
对于
IMPORT INTO,你也可以通过CLOUD_STORAGE_URI选项指定云存储路径。如果tidb_cloud_storage_uri和CLOUD_STORAGE_URI都配置了有效的云存储路径,则对于IMPORT INTO以CLOUD_STORAGE_URI的配置为准。
实现原理
全局排序功能的算法如下:
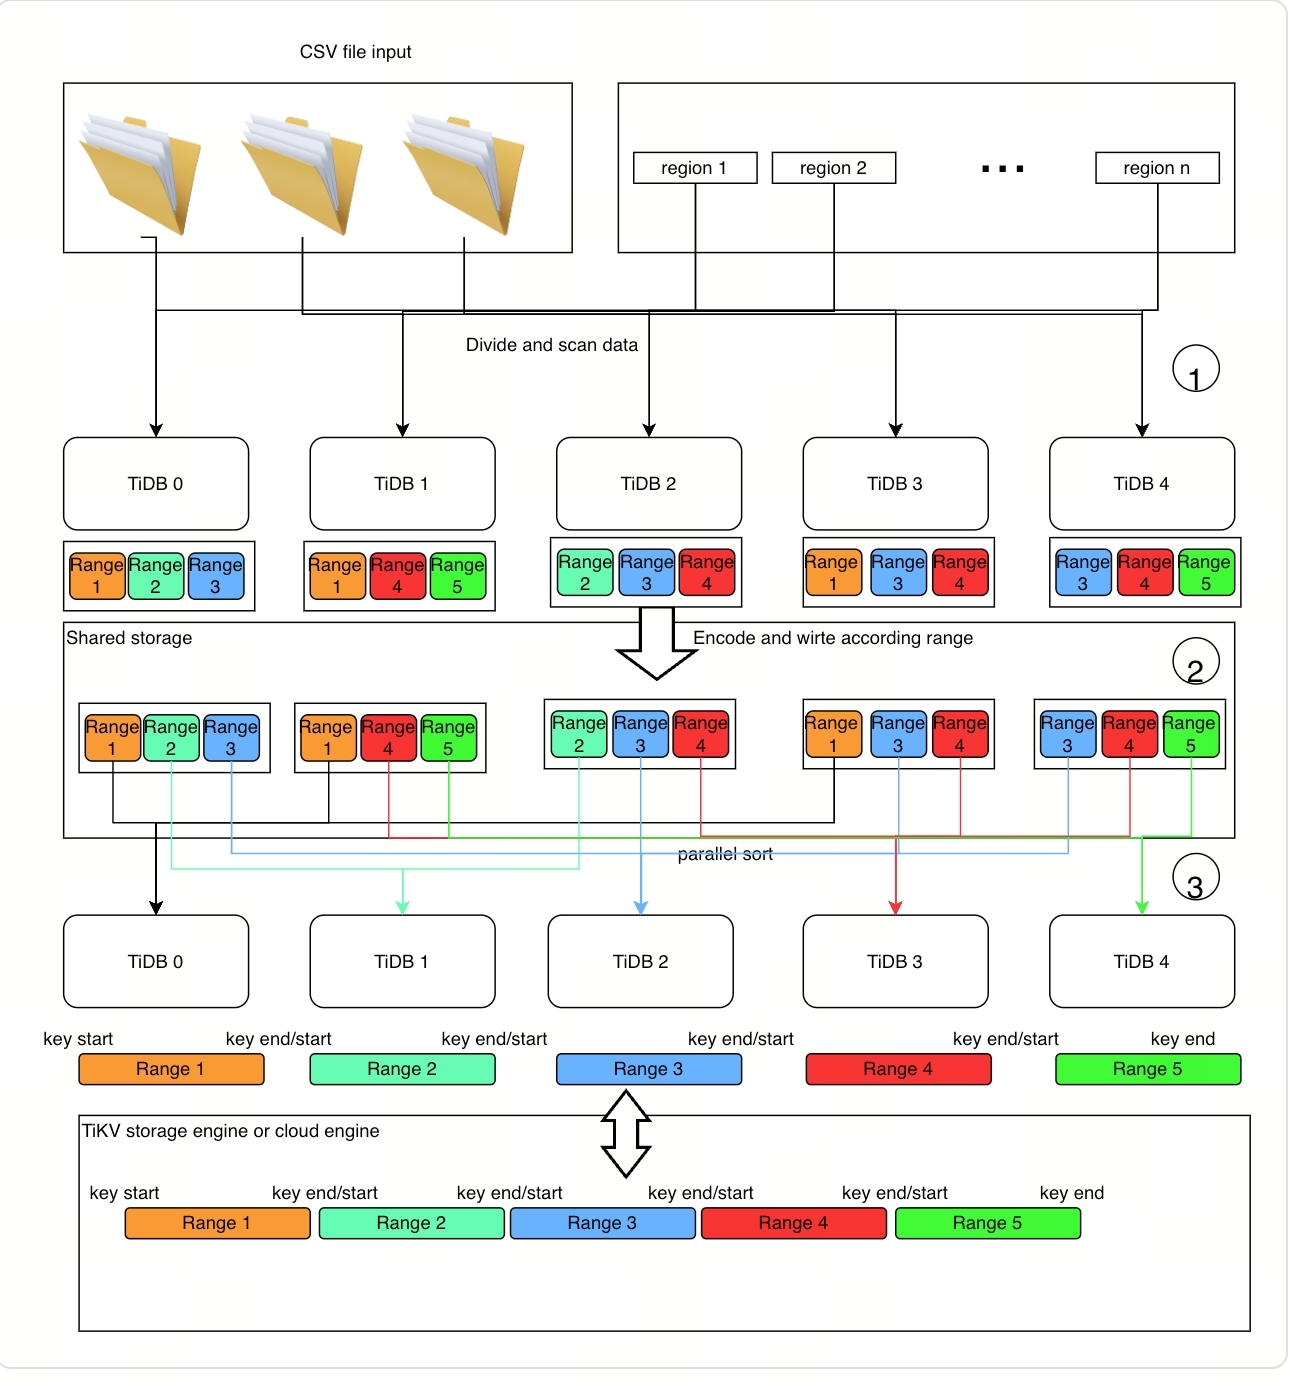
具体实现原理如下:
第 1 步:扫描并准备数据
-
TiDB 节点扫描特定范围的数据后(数据源可以是 CSV 数据,也可以是 TiKV 中的表数据):
- TiDB 节点将其编码为 Key-Value 对。
- TiDB 节点将 Key-Value 对排序为若干块数据段(每个数据段在本地已排序),每个数据段为一个文件,并上传到云存储。
-
TiDB 节点还会为每个数据段记录一组实际的 Key-Value 范围(称为统计文件),这是实现可扩展排序的关键准备。这些文件会与真实数据一起上传到云存储。
第 2 步:排序并分发数据
在第 1 步中,全局排序程序获得了已排序的数据块列表及其对应的统计文件,这些文件提供了本地已排序块的数量。程序还拥有可供 PD 拆分和分散的真实数据范围。具体步骤如下:
- 对统计文件中的记录进行排序,将其划分为近似等大小的范围,这些范围即为将要并行执行的子任务。
- 将子任务分发到 TiDB 节点执行。
- 每个 TiDB 节点独立地将子任务的数据排序为范围,并无重叠地导入到 TiKV。